
大模型原理与训练 / 系统课时
用消融实验验证关键机制
用消融实验验证关键机制
消融实验不是“把组件删掉看看会不会变差”,而是一次只改变一个因素,用可复现的对照验证组件究竟解决了什么问题。本节用同一份微型序列数据,分别移除位置表示、移除因果掩码、缩短上下文长度,并同时比较损失与自由生成结果。
学习目标
- 设计一次只改变一个变量的 GPT 消融实验,避免把多种因素混在一起。
- 根据损失与生成样本判断位置表示、因果掩码和上下文长度各自承担的作用。
- 识别“损失更低但模型其实作弊”这类容易误判的实验结果。
设计并运行对照实验
消融的前提是基线可复现。除被研究变量外,数据、随机种子、模型宽度、优化器、训练步数和每次更新看到的 token 数都应保持一致。这里使用周期序列 aaaaaaab:要正确预测 b,模型必须知道自己处在序列中的什么位置;若允许看到未来 token,训练又会出现信息泄漏。
四组实验分别是:完整基线、去掉位置表示、去掉因果掩码、把上下文从 8 缩短到 4。上下文变短时把 batch size 从 64 增加到 128,使每次参数更新仍处理约 512 个 token,减少“训练 token 数不同”造成的干扰。
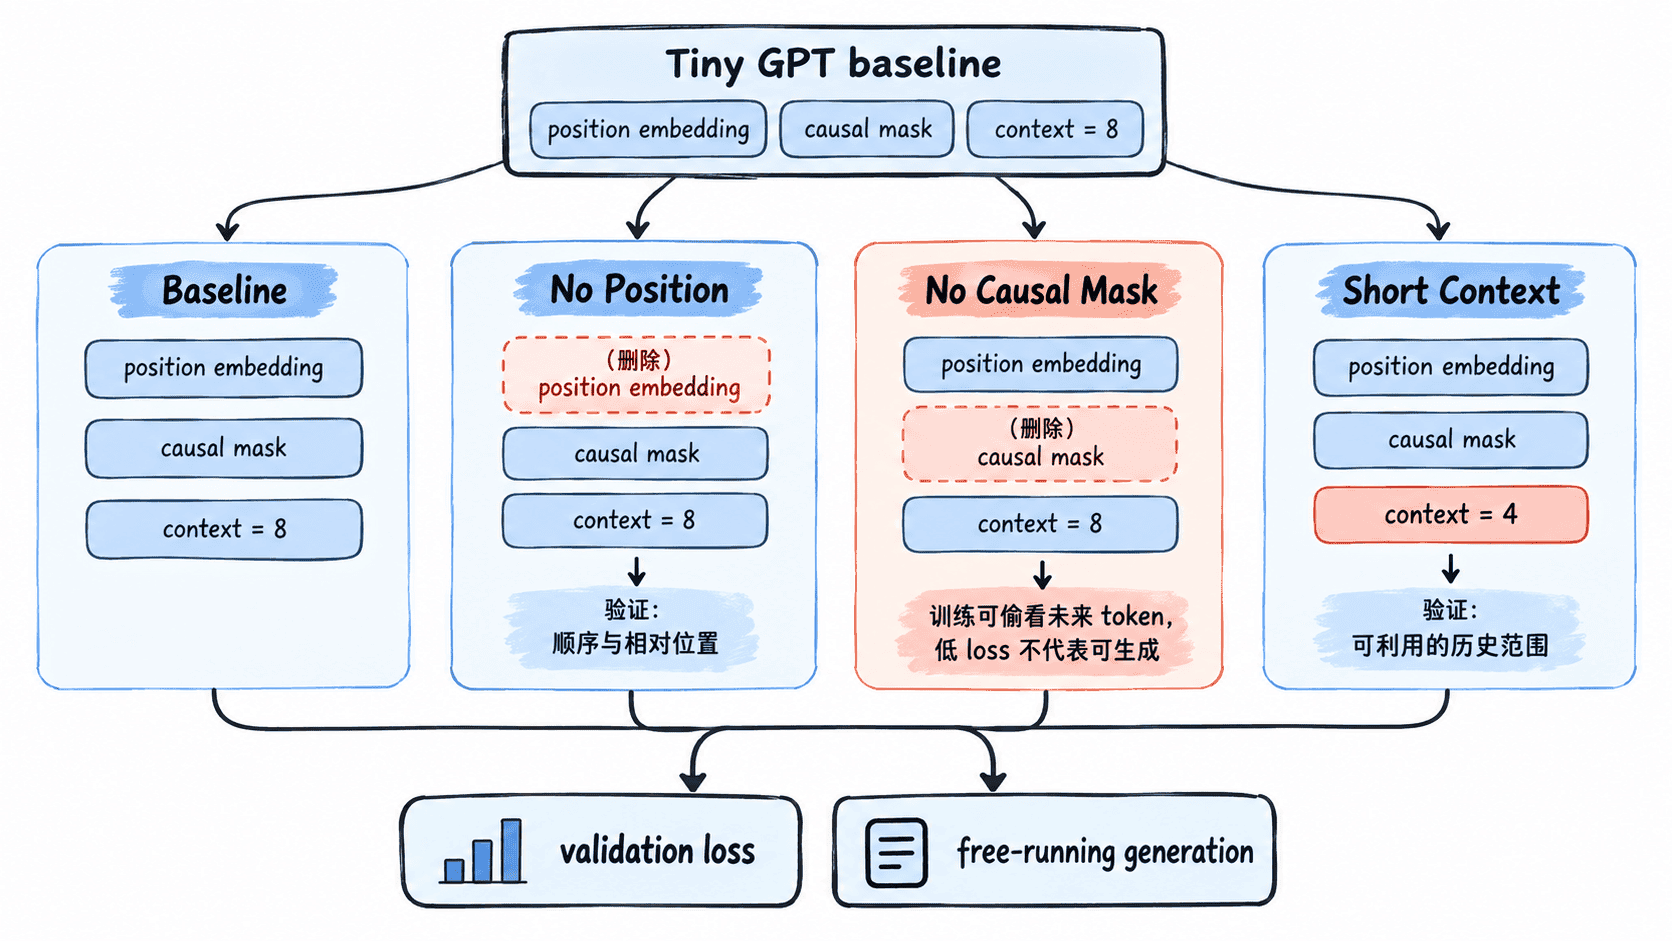
下面的脚本只依赖 PyTorch。它训练四个结构几乎相同的微型自回归模型,并打印验证损失和贪心生成样本。为便于观察机制,数据是刻意构造的诊断序列,而不是追求自然语言质量。
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(7)
device = "cuda" if torch.cuda.is_available() else "cpu"

pattern = torch.tensor([0, 0, 0, 0, 0, 0, 0, 1], dtype=torch.long)
data = pattern.repeat(600)
itos = {0: "a", 1: "b"}


class TinyGPT(nn.Module):
    def __init__(self, block_size: int, use_position: bool, causal: bool):
        super().__init__()
        dim = 32
        self.block_size = block_size
        self.use_position = use_position
        self.causal = causal
        self.token_emb = nn.Embedding(2, dim)
        self.pos_emb = nn.Embedding(block_size, dim)
        self.attn = nn.MultiheadAttention(dim, 4, batch_first=True)
        self.ln1 = nn.LayerNorm(dim)
        self.ff = nn.Sequential(
            nn.Linear(dim, 4 * dim),
            nn.GELU(),
            nn.Linear(4 * dim, dim),
        )
        self.ln2 = nn.LayerNorm(dim)
        self.head = nn.Linear(dim, 2)

    def forward(self, x, targets=None):
        _, t = x.shape
        h = self.token_emb(x)
        if self.use_position:
            pos = torch.arange(t, device=x.device)
            h = h + self.pos_emb(pos)[None, :, :]

        mask = None
        if self.causal:
            mask = torch.triu(
                torch.full((t, t), float("-inf"), device=x.device),
                diagonal=1,
            )

        attended, _ = self.attn(h, h, h, attn_mask=mask, need_weights=False)
        h = self.ln1(h + attended)
        h = self.ln2(h + self.ff(h))
        logits = self.head(h)

        loss = None
        if targets is not None:
            loss = F.cross_entropy(logits.reshape(-1, 2), targets.reshape(-1))
        return logits, loss


def get_batch(block_size: int, batch_size: int):
    starts = torch.randint(0, len(data) - block_size - 1, (batch_size,))
    x = torch.stack([data[i:i + block_size] for i in starts])
    y = torch.stack([data[i + 1:i + block_size + 1] for i in starts])
    return x.to(device), y.to(device)


@torch.no_grad()
def evaluate(model, batch_size: int):
    model.eval()
    losses = []
    for _ in range(20):
        x, y = get_batch(model.block_size, batch_size)
        _, loss = model(x, y)
        losses.append(loss.item())
    model.train()
    return sum(losses) / len(losses)


@torch.no_grad()
def generate(model, length: int = 32):
    model.eval()
    out = torch.tensor([[0]], dtype=torch.long, device=device)
    for _ in range(length - 1):
        ctx = out[:, -model.block_size:]
        logits, _ = model(ctx)
        next_token = logits[:, -1].argmax(dim=-1, keepdim=True)
        out = torch.cat([out, next_token], dim=1)
    return "".join(itos[int(i)] for i in out[0])


def run(name: str, block_size: int, use_position: bool, causal: bool):
    # block_size 变短时增大 batch,保持每步约 512 个训练 token。
    batch_size = 512 // block_size
    torch.manual_seed(7)
    model = TinyGPT(block_size, use_position, causal).to(device)
    optimizer = torch.optim.AdamW(model.parameters(), lr=3e-3)

    for _ in range(500):
        x, y = get_batch(block_size, batch_size)
        _, loss = model(x, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    val_loss = evaluate(model, batch_size)
    print(f"{name:16s} loss={val_loss:.4f} sample={generate(model)}")


if __name__ == "__main__":
    run("baseline", 8, True, True)
    run("no_position", 8, False, True)
    run("no_causal_mask", 8, True, False)
    run("short_context", 4, True, True)
预期结果(具体数值会随设备和 PyTorch 版本略有差异,应比较相对趋势):
baseline         loss=<LOW_LOSS> sample=<MOSTLY_PERIODIC_AAAAAAAB>
no_position      loss=<HIGHER_LOSS> sample=<POSITION_ERRORS>
no_causal_mask   loss=<VERY_LOW_LOSS> sample=<FREE_GENERATION_DEGRADES>
short_context    loss=<HIGHER_LOSS> sample=<LONG_RANGE_PATTERN_BREAKS>
如果机器较慢,可以把训练步数从 500 降到 200 先验证脚本流程;此时绝对损失会更高,但仍应重点观察四组实验之间的相对差异,而不是追求某个固定数值。
读懂三种消融
移除位置表示
没有位置表示时,连续多个 a 在注意力层看来缺少明确的先后坐标。模型可能仍能利用 token 统计信息,但难以稳定判断“已经连续出现了几个 a”。因此损失通常上升,生成样本也更容易在应输出 b 的位置出错。
这验证的是:自注意力本身擅长建立 token 间关系,却不会自动提供可靠的序列位置信息。位置表示承担的是“同样的 token 出现在不同位置时,模型能区分其角色”。
移除因果掩码
这一组最容易误判。训练时不加因果掩码,位置 可以读取右侧 token,而右侧输入里往往已经包含当前目标的信息,所以验证损失可能比基线还低。这个结果不是模型更强,而是实验允许了未来信息泄漏。
真正的检查点是自由生成:生成第一个未知 token 时,未来内容根本不存在。若模型训练时依赖偷看的未来信息,离开 teacher-forcing 的完整序列后就会明显退化。因此,因果掩码验证的是“训练条件必须与自回归生成时的信息边界一致”。
缩短上下文长度
把上下文从 8 缩短到 4 后,模型看不到足够长的历史,无法稳定判断距离上一个 b 已经过了多少步。即使位置表示和因果掩码都保留,信息根本没有进入输入窗口时,模型也无从利用。
这验证的是:上下文长度决定了模型一次预测可直接访问的历史范围。它不是“越长越好”的装饰参数,而是任务依赖跨度与计算成本之间的硬约束。
用两类指标得出结论
消融结果至少同时看两类证据。损失告诉你模型在指定评估协议下预测得多准;自由生成样本检查模型离开完整目标序列后,是否仍按自回归方式工作。只看其中一项都可能得到错误结论。
尤其是因果掩码实验,若只按“loss 越低越好”排序,会把作弊模型误判为最佳模型。一个有效的消融结论应能写成因果句:删除某组件后,哪一种能力按预期受损,并且其他训练条件没有同时改变。
当位置表示被移除后顺序判断变差、取消因果掩码后损失异常降低但自由生成退化、缩短上下文后长依赖模式被破坏时,这三组结果才分别构成对位置、信息边界和可见历史范围的直接证据。