
大模型原理与训练 / 系统课时
用 Embedding 映射离散词元
用 Embedding 映射离散词元
Tokenizer 得到的词元 ID 只是离散编号,数字之间没有可直接利用的距离关系。Embedding 会用这些 ID 从一个可训练矩阵中取出连续向量,使每个词元获得模型能够计算和更新的表示。本篇将把查表过程、矩阵形状和梯度更新连成一条完整链路。
学习目标
- 读懂 Embedding 矩阵的词表维度与向量维度,并判断输入输出形状。
- 理解词元 ID 如何通过查表变成连续向量,而不是把 ID 当作数值直接计算。
- 观察 Embedding 参数如何接收梯度并在训练过程中更新。
Embedding 本质是一张可训练的表
假设词表共有 V 个词元,每个词元需要一个 d 维表示,那么词元嵌入矩阵的形状就是 V × d。矩阵的每一行对应一个词元 ID,每一列对应向量中的一个特征维度。
当输入 ID 为 3 时,Embedding 做的核心操作就是取出矩阵第 3 行。输入 [3, 1, 3] 时,它会依次取出第 3、1、3 行,因此相同 ID 在同一次查表中得到相同的参数向量。
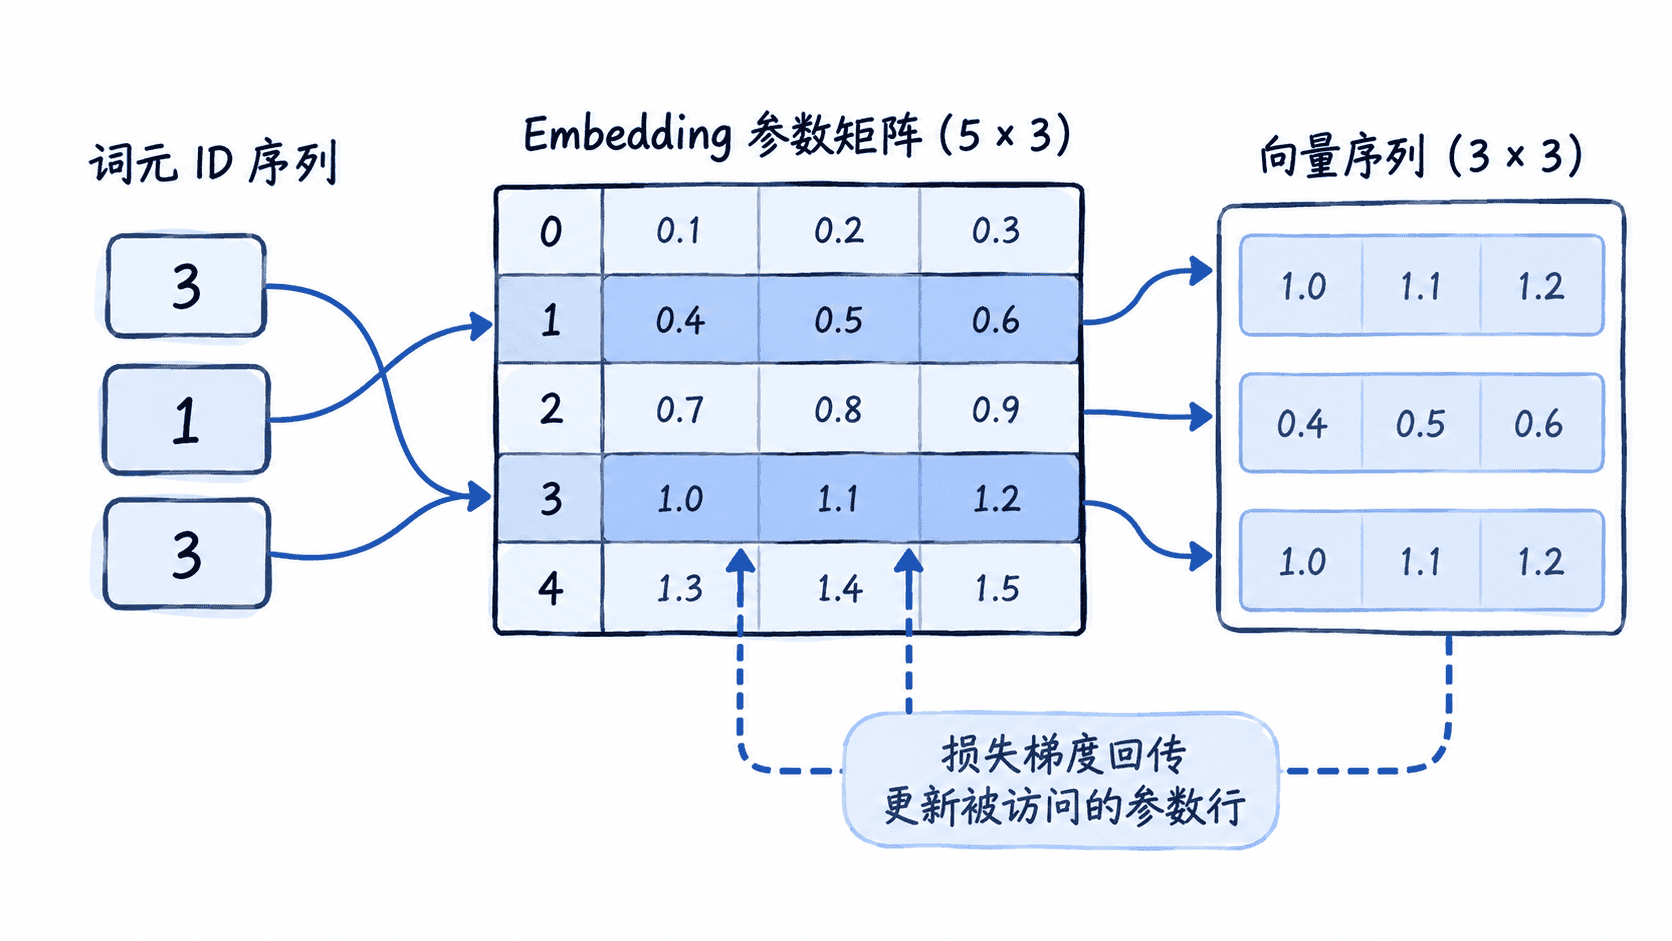
这里最重要的边界是:ID 的数值大小没有连续意义。ID 100 并不比 ID 10 大十倍,也不代表两个词元之间更远。ID 只是访问矩阵行的索引,真正参与后续神经网络计算的是查到的向量。
输入形状如何变成输出形状
如果一条样本含有 T 个词元,输入 ID 的形状可以记为 [T],经过 d 维 Embedding 后变成 [T, d]。批量输入 B 条样本时,常见形状则从 [B, T] 变成 [B, T, d]。
Embedding 不会在这个过程中减少词元数量。它只是给每个离散位置增加一个连续向量维度,后面的注意力层才能基于这些向量执行线性变换、点积和加权求和。
看一次真实的查表与反向传播
下面使用 PyTorch 构造一个包含 5 个词元、每个词元 3 维的 Embedding,并手工固定初始权重。对 ID 1 和 3 查表后求和并反向传播,可以直接观察哪些参数行收到了梯度。
import torch
from torch import nn

embedding = nn.Embedding(num_embeddings=5, embedding_dim=3)

with torch.no_grad():
    embedding.weight.copy_(torch.tensor([
        [0.0, 0.0, 0.0],
        [1.0, 1.0, 1.0],
        [2.0, 2.0, 2.0],
        [3.0, 3.0, 3.0],
        [4.0, 4.0, 4.0],
    ]))

ids = torch.tensor([1, 3])
vectors = embedding(ids)
loss = vectors.sum()
loss.backward()

print(vectors.detach())
print(embedding.weight.grad)
预期输出
tensor([[1., 1., 1.],
        [3., 3., 3.]])
tensor([[0., 0., 0.],
        [1., 1., 1.],
        [0., 0., 0.],
        [1., 1., 1.],
        [0., 0., 0.]])
输入只访问了第 1 行和第 3 行,所以这个简单损失对这两行产生梯度,而其他行梯度为零。真实语言模型的损失和计算图复杂得多,但基本机制相同:Embedding 是模型参数的一部分,梯度会沿反向传播链路回到相关向量,优化器再据此更新它们。
不要把 Embedding 当成固定词义表
训练开始时,嵌入向量通常只是初始化得到的一组数。随着语言建模损失不断反向传播,不同词元的向量才逐渐调整到有利于预测任务的位置。因此它不是人工预先规定的词义坐标,也不能只看单个维度就解释某个词元的完整语义。
另外,纯词元 Embedding 只回答“当前位置是什么词元”,尚未表达“它位于序列哪里”。GPT 类 Transformer 还需要把位置信息引入表示,然后才进入后续注意力和前馈网络计算。
从数据形态看,这一步完成了关键转换:整数 ID [B, T] 经过对可训练矩阵的索引,成为连续表示 [B, T, d]。从这里开始,离散的文本编号才真正进入神经网络的连续数值计算空间。