
大模型原理与训练 / 系统课时
从贪心生成切换到概率采样
从贪心生成切换到概率采样
同一组 logits 可以产生完全不同的生成行为:贪心解码每一步都选概率最高的 token,结果稳定但容易重复;概率采样则按分布随机抽取 token,让低概率但合理的候选也有机会出现。掌握两者差异,就能理解生成确定性与多样性的来源。
学习目标
- 区分
argmax贪心选择与按概率分布随机采样 - 解释为什么采样会提高多样性,同时带来不确定性
- 根据任务目标判断何时优先使用确定性输出或概率采样
同一分布的两种选法
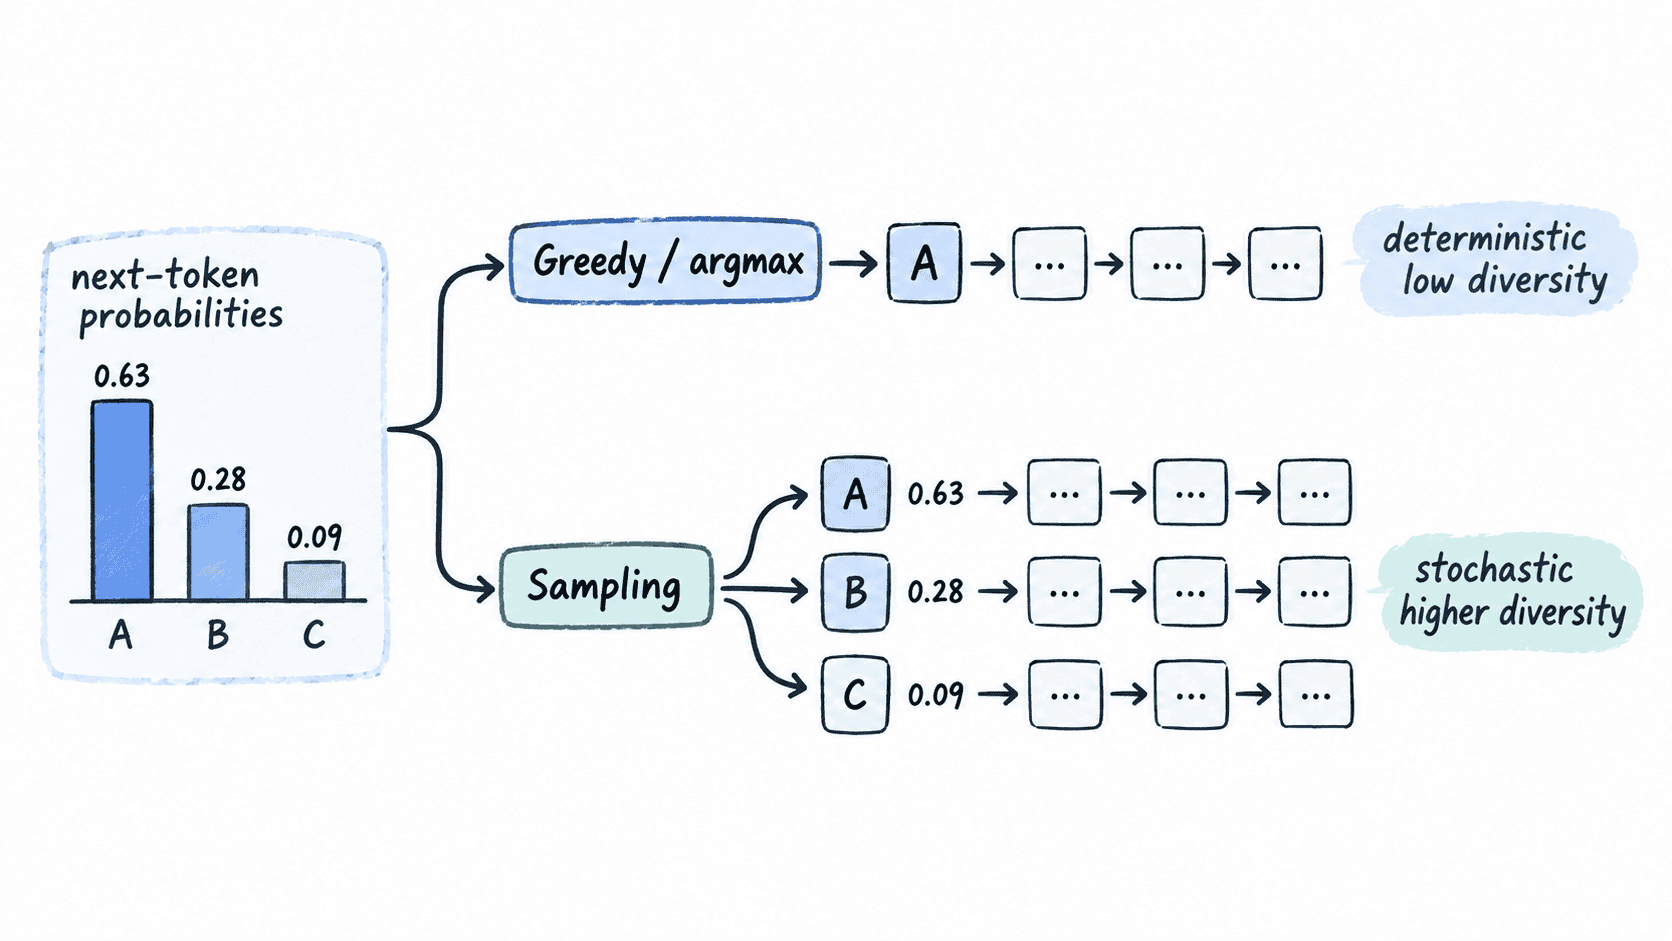
假设模型在某一步给出三个 token 的概率:A 为 0.63、B 为 0.28、C 为 0.09。贪心生成执行 argmax,永远选择 A。只要输入、模型和计算结果不变,这一步的输出就是确定的。
概率采样不会直接取最大值,而是把这三个概率看成抽签权重。A 仍然最容易被选中,但 B 和 C 也保留非零机会。多次从同一分布采样,得到的 token 可能不同,因此完整续写也会沿不同路径展开。
用一个最小示例观察差异
下面把 logits 转成 softmax 概率,再分别执行贪心选择和随机采样。示例固定随机种子,因此可以复现采样序列。
import math
import random

tokens = ["A", "B", "C"]
logits = [2.0, 1.2, 0.1]

m = max(logits)
exp_values = [math.exp(x - m) for x in logits]
total = sum(exp_values)
probs = [x / total for x in exp_values]

greedy = tokens[max(range(len(logits)), key=logits.__getitem__)]

rng = random.Random(2)
samples = rng.choices(tokens, weights=probs, k=10)

print([round(p, 3) for p in probs])
print("greedy:", greedy)
print("samples:", samples)
预期输出
[0.625, 0.281, 0.094]
greedy: A
samples: ['C', 'C', 'A', 'A', 'B', 'B', 'B', 'A', 'A', 'A']
固定种子只是为了让示例可验证,并不改变采样机制本身。实际生成时如果不固定随机状态,同一提示词多次运行可能得到不同续写。
为什么采样更容易产生多样性
贪心策略会在每一步提前压缩选择空间:只保留当前最高概率 token,其他候选全部丢弃。连续多步后,这种局部最优选择容易反复进入模型最熟悉的高概率表达,因此输出通常更稳定,也更可能模板化或重复。
采样则保留概率分布中的不确定性。高概率 token 仍占优势,但偶尔选择次高概率 token 会把后续上下文带到新的状态,之后每一步的分布也会随之改变。这就是为什么一次很小的随机选择,可能让整段文本走向明显不同的续写。
这种多样性不是免费收益。采样也会增加选中较差 token 的机会,尤其当分布尾部包含大量低质量候选时。因此实际系统常在“保留随机性”和“限制异常候选”之间继续做控制,不过这些策略的基础仍然是先从 argmax 切换到概率分布采样。
怎么选择贪心还是采样
如果任务强调可复现、格式稳定和答案一致,例如结构化抽取、严格分类或需要逐次对比模型变化,贪心生成更容易建立稳定基线。它的代价是缺少探索,同样的高概率表达可能反复出现。
如果任务希望产生多个合理版本,例如故事续写、创意文案或开放式对话,概率采样通常更合适。它允许模型利用分布中的多个候选,但每次输出不再完全确定,评估时也不能只依赖单次结果。
最核心的判断不是“哪种算法更先进”,而是任务是否需要随机性。argmax 把概率分布压缩成一个确定选择;概率采样则保留分布本身表达的不确定性。生成行为的稳定度、重复度和多样性,正是从这个选择开始分化。