
大模型原理与训练 / 系统课时
比较 RLHF 与 DPO 优化思路
比较 RLHF 与 DPO 优化思路
RLHF 与 DPO 都试图让语言模型更偏向人类选择的回答,但训练链路并不相同。RLHF 先把偏好学习成奖励,再通过强化学习优化策略;DPO 则把偏好关系直接改写成策略损失。理解这条结构差异,才能判断两种方法各自增加了什么能力与工程成本。
学习目标
- 串起基于奖励模型的 RLHF 典型优化链路
- 解释 DPO 如何直接利用
chosen与rejected更新策略 - 从训练复杂度、采样方式和控制能力比较两种方案
两条路线优化的是同一个方向
两种方法通常都从监督微调后的策略和人类偏好数据出发,并希望提高受偏好回答相对于较差回答的概率。同时,它们都会限制策略不要无约束地偏离参考模型,否则容易牺牲原有语言能力或寻找目标函数的漏洞。
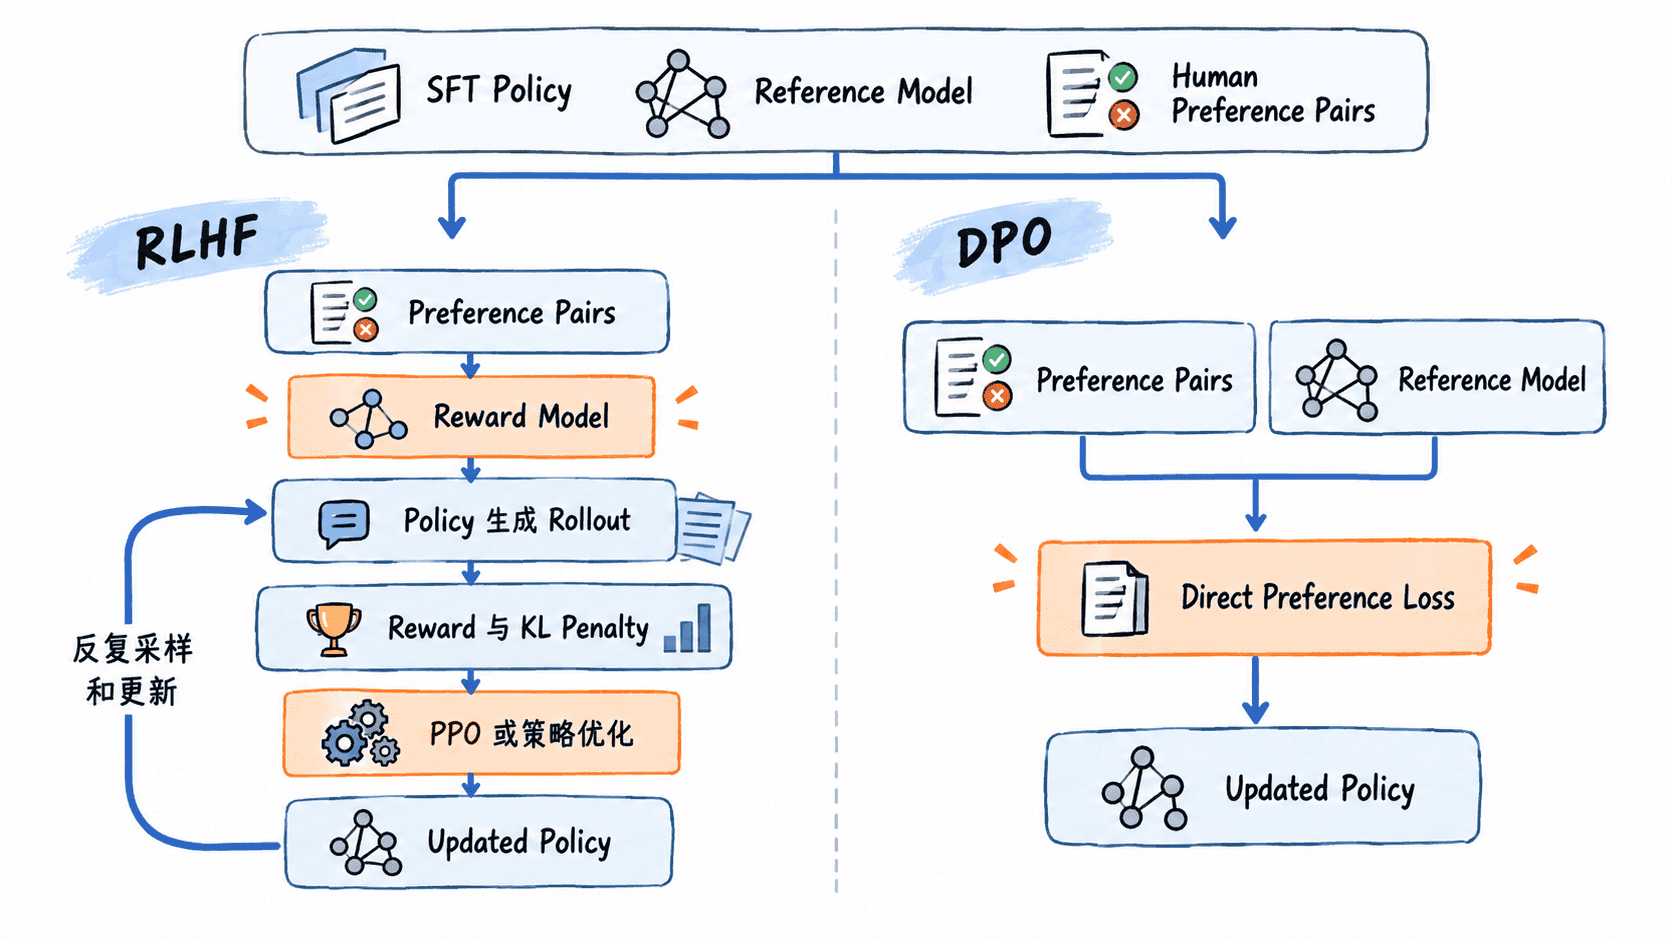
真正不同的是中间表示。RLHF 显式训练奖励模型,把人的选择压缩为可对任意回答打分的函数;DPO 不建立这层可调用的奖励函数,而是直接根据偏好对改变策略模型的概率比。
RLHF 先学习奖励再优化策略
经典 RLHF 可以拆成两个主要训练阶段。首先使用成对偏好训练奖励模型 ;随后让当前策略生成回答,由奖励模型评分,再通过 PPO 等强化学习算法更新策略。
策略目标可以概念化为:
第一项鼓励策略生成高奖励回答,第二项惩罚策略过度偏离参考模型。实际训练还要维护生成样本、价值估计、优势函数、策略更新以及多个模型之间的数据流,因此系统复杂度明显高于普通监督微调。
这条路线的价值在于奖励模型成为一个独立组件。只要奖励模型能够评价新生成的回答,策略就可以在自己的新样本上继续探索和优化。不过这也带来风险:如果奖励函数只近似人类偏好,策略可能找到获得高分却并非真正优质的行为,即常说的奖励利用或 reward hacking。
DPO 直接优化偏好概率差
DPO 从一个关键观察出发:在带 KL 约束的奖励最大化问题中,可以把隐含奖励与策略相对参考模型的概率比联系起来。于是无需显式拟合奖励模型,也无需在训练循环中运行 PPO,就能直接从 chosen 和 rejected 构造分类式损失。
对于偏好对,先计算策略相对参考模型的优势差:
再最小化:
当模型相对于参考策略更加偏向 chosen 时, 增大,损失下降。参考模型在这里非常重要,因为目标并不是无限提高 chosen 的概率,而是控制“相对于原策略应该向哪个方向移动多少”。
用数值例子观察两种信号
下面的可运行 Python 示例不实现完整 PPO 或 DPO 训练,而是分别计算一个简化的 RLHF 奖励减 KL 信号,以及一对回答对应的 DPO 偏好边际和损失,从数值上观察两条路线把优化压力放在哪里。
import math

# RLHF:奖励模型得分还要扣除偏离参考策略的代价。
reward_model_score = 1.4
kl_divergence = 0.2
kl_coefficient = 0.1
adjusted_reward = reward_model_score - kl_coefficient * kl_divergence

# DPO:直接比较策略相对参考模型对 chosen/rejected 的概率变化。
chosen_policy = -1.2
rejected_policy = -2.0
chosen_reference = -1.5
rejected_reference = -1.7
beta = 0.1

margin = beta * (
    (chosen_policy - rejected_policy)
    - (chosen_reference - rejected_reference)
)
dpo_loss = -math.log(1.0 / (1.0 + math.exp(-margin)))

print(f"RLHF adjusted reward: {adjusted_reward:.4f}")
print(f"DPO preference margin: {margin:.4f}")
print(f"DPO loss: {dpo_loss:.4f}")
预期输出
RLHF adjusted reward: 1.3800
DPO preference margin: 0.0600
DPO loss: 0.6636
RLHF 的示例信号来自“奖励减去偏离成本”;DPO 的信号则直接来自 chosen 与 rejected 的相对对数概率差。真实训练还会对批量 token 概率、掩码和梯度进行处理,但核心区别不会改变。
选择取决于需要什么训练能力
| 维度 | RLHF | DPO |
|---|---|---|
| 独立奖励模型 | 通常需要 | 不需要 |
| 强化学习循环 | 通常需要 | 不需要 |
| 训练期策略采样 | 常见,需要持续生成 rollout | 可直接使用固定偏好数据 |
| 工程复杂度 | 较高 | 更接近监督微调 |
| 独立奖励函数用途 | 可以单独评分、分析或供其他策略使用 | 没有显式奖励模型 |
| 对偏好数据依赖 | 奖励模型质量决定后续优化方向 | 偏好对直接决定策略梯度 |
如果已有成熟的生成、奖励评估和强化学习基础设施,并希望利用独立奖励模型对新策略样本持续评分,RLHF 提供了更显式的优化闭环。若目标主要是利用现成成对偏好数据完成稳定、简化的策略对齐,DPO 往往能减少模型组件和训练环节。
两者并不是“强化学习有效、监督学习无效”这样的二选一关系。它们使用的偏好来源高度相似,差别主要在于是否先学习一个显式奖励函数,以及之后通过强化学习还是直接偏好损失把这个信号传递给策略模型。