
大模型原理与训练 / 系统课时
把原始语料变成预训练样本
把原始语料变成预训练样本
大模型不能直接拿网页、书籍或代码文件开始训练。原始语料需要经过清洗、分词、词元流组织、定长切块和标签对齐,最终变成可以批量送入 GPU 的自回归样本。本篇走通这条完整数据链路。
学习目标
- 说清原始文档从清洗到定长样本的主要处理阶段
- 理解分词、文档边界和定长切块分别解决什么问题
- 解释因果语言模型如何从词元序列得到下一词元训练目标
原始文本要经过一条数据流水线
预训练数据处理的目标不是简单地“把文本存成文件”,而是把格式各异的文档转换成统一的词元序列,再组织成尺寸稳定、能够高效组成批次的训练样本。
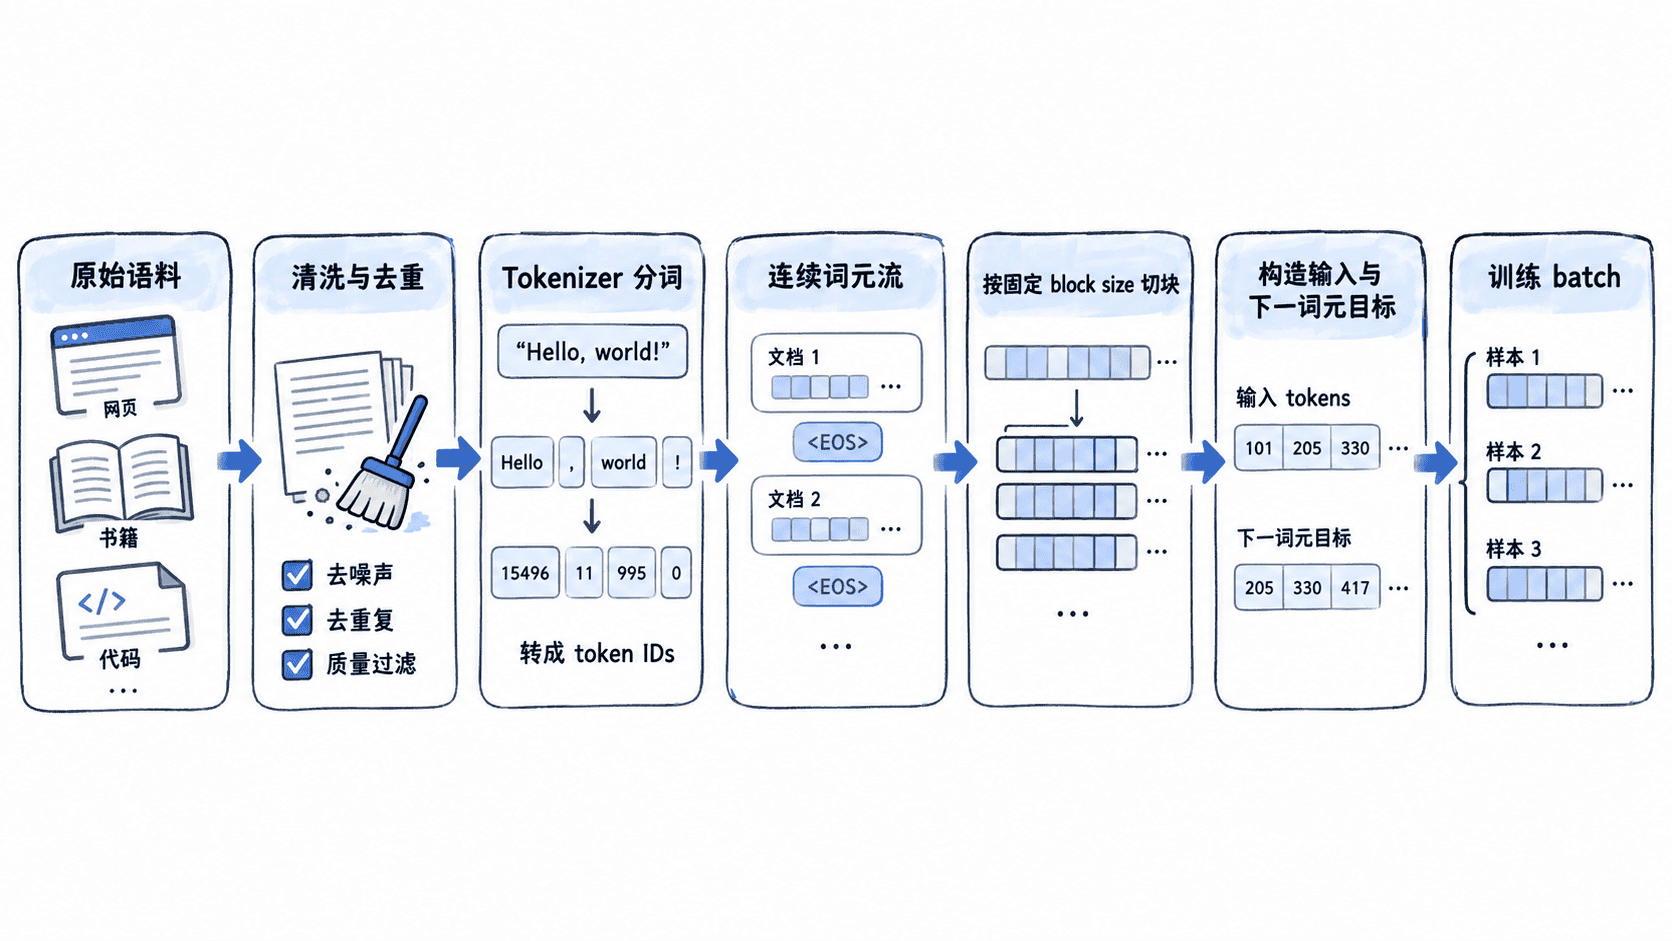
这条链路中,每一阶段解决的问题都不同。清洗控制语料质量,分词把字符串转换成模型可处理的离散整数,切块统一张量尺寸,而标签对齐决定模型究竟在每个位置学习什么。
清洗先决定哪些文本值得学习
原始抓取数据常包含重复页面、导航栏、广告模板、乱码、异常编码和明显损坏的内容。如果这些内容大量进入训练集,模型会把计算资源浪费在重复或低质量模式上。
常见处理包括文本抽取、编码规范化、质量过滤、近重复与精确重复去除,以及依据数据策略执行语言、来源或内容过滤。清洗规则不能无限加强,因为过度过滤同样可能删除罕见但有价值的文本。
文档边界也应在这一阶段被保留下来。后面即使把多个文档拼接成连续词元流,也需要知道一篇文档在哪里结束,避免让两个无关文档在数据表示上看起来像同一段自然连续文本。
分词把字符串变成词元 ID
Tokenizer 按既定词表和分词规则把文本转换为词元,再将每个词元映射为整数 ID。模型真正接收的是这些整数 ID,而不是原始 Unicode 字符串。
例如一小段文本经过分词后,可能形成类似 [314, 1592, 42, 981] 的整数序列。这里的数字只是示意;实际 ID 完全取决于所使用的 Tokenizer 和词表,不能跨模型直接比较数字含义。
分词完成后,数据集通常不再围绕“字符数”组织,而是围绕词元数组织。训练上下文长度、批次显存占用和每次优化处理的数据量,也通常以 token 为基本单位。
定长切块让样本能够高效组成批次
不同文档的词元数量差异很大,直接把每篇文档作为一个样本会产生大量不同长度的数据。常见做法是先把经过边界处理的词元连接成长序列,再按照固定的 block_size 切成等长片段。
假设 block_size 为 4,一条连续词元流可以按下面方式切分:
| 连续词元流 | 切块结果 |
|---|---|
| A B C D E F G H I J | A B C D |
| E F G H | |
| I J 与后续数据共同处理或按策略丢弃 |
文档之间通常会加入 EOS 等特殊词元,使模型能够学习“这里已经结束”的边界。对于最后不足一个块的少量词元,可以根据数据管线选择继续与后续数据打包、填充或丢弃;大规模预训练通常会尽量减少无意义填充,提高有效 token 比例。
下一词元标签来自同一条序列
因果语言模型的目标是根据左侧上下文预测下一个词元。概念上,一段序列 会产生一组位置级目标:位置 根据此前可见内容预测 。
| 当前位置 | 已知到的词元 | 预测目标 |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 |
在许多因果语言模型训练接口中,数据字段里的 labels 可以直接保存与 input_ids 相同的词元序列,模型内部在计算损失时再完成一位错位对齐。因此“标签等于输入序列”和“目标是下一个词元”并不矛盾,前者描述存储接口,后者描述真正参与损失计算的预测关系。
自回归目标也能并行训练
生成时必须先得到前一个新词元,才能继续生成下一个,因此推理天然是逐步进行的。训练却不同:完整正确序列已经提前存在,配合因果注意力掩码后,一个训练块中多个位置的下一词元损失可以在一次前向计算中并行求出。
这正是定长切块的重要价值之一。大量文本被转换成统一尺寸的 token 张量后,可以组成批次交给 GPU 并行计算,而因果掩码仍然保证位置 看不到未来词元。
从原始语料到预训练样本的关键链路可以归结为:先决定哪些文本进入数据集,再把文本编码成词元流,用边界标记保留文档结构,按照上下文长度切成训练块,最后让每个有效位置学习预测它的下一个词元。这样,海量异构文本才真正变成可并行优化的自回归训练数据。