
大模型原理与训练 / 系统课时
用梯度累积扩展有效批次
用梯度累积扩展有效批次
显存装不下大批次时,不必直接缩小训练的有效批次。梯度累积把一个大批次拆成多个 micro-batch 依次前向与反向传播,在若干次反向后才更新参数,从而用较小显存近似更大的批次训练。
学习目标
- 区分 micro-batch、累积步数与 effective batch size。
- 正确安排
backward()、step()和zero_grad()的调用时机。 - 识别损失缩放、分布式训练和尾批次带来的边界问题。
有效批次由什么决定
单卡训练时,设每次真正送入显存的样本数为 micro_batch_size,连续累积 次梯度后才更新一次参数,则一次优化器更新对应的有效批次为:
若使用数据并行并有 个并行进程,同时每个进程都做同样的梯度累积,则常用近似为:
因此,micro-batch 决定单次前向与反向的显存压力,而 effective batch size 决定一次参数更新综合了多少样本。两者不能混为一谈。
梯度在什么时候真正更新参数
每个 micro-batch 都执行一次前向和反向传播,但梯度不会在每次反向后清零。只有累积到指定次数,才执行一次优化器更新,然后清空梯度,开始下一轮累积。
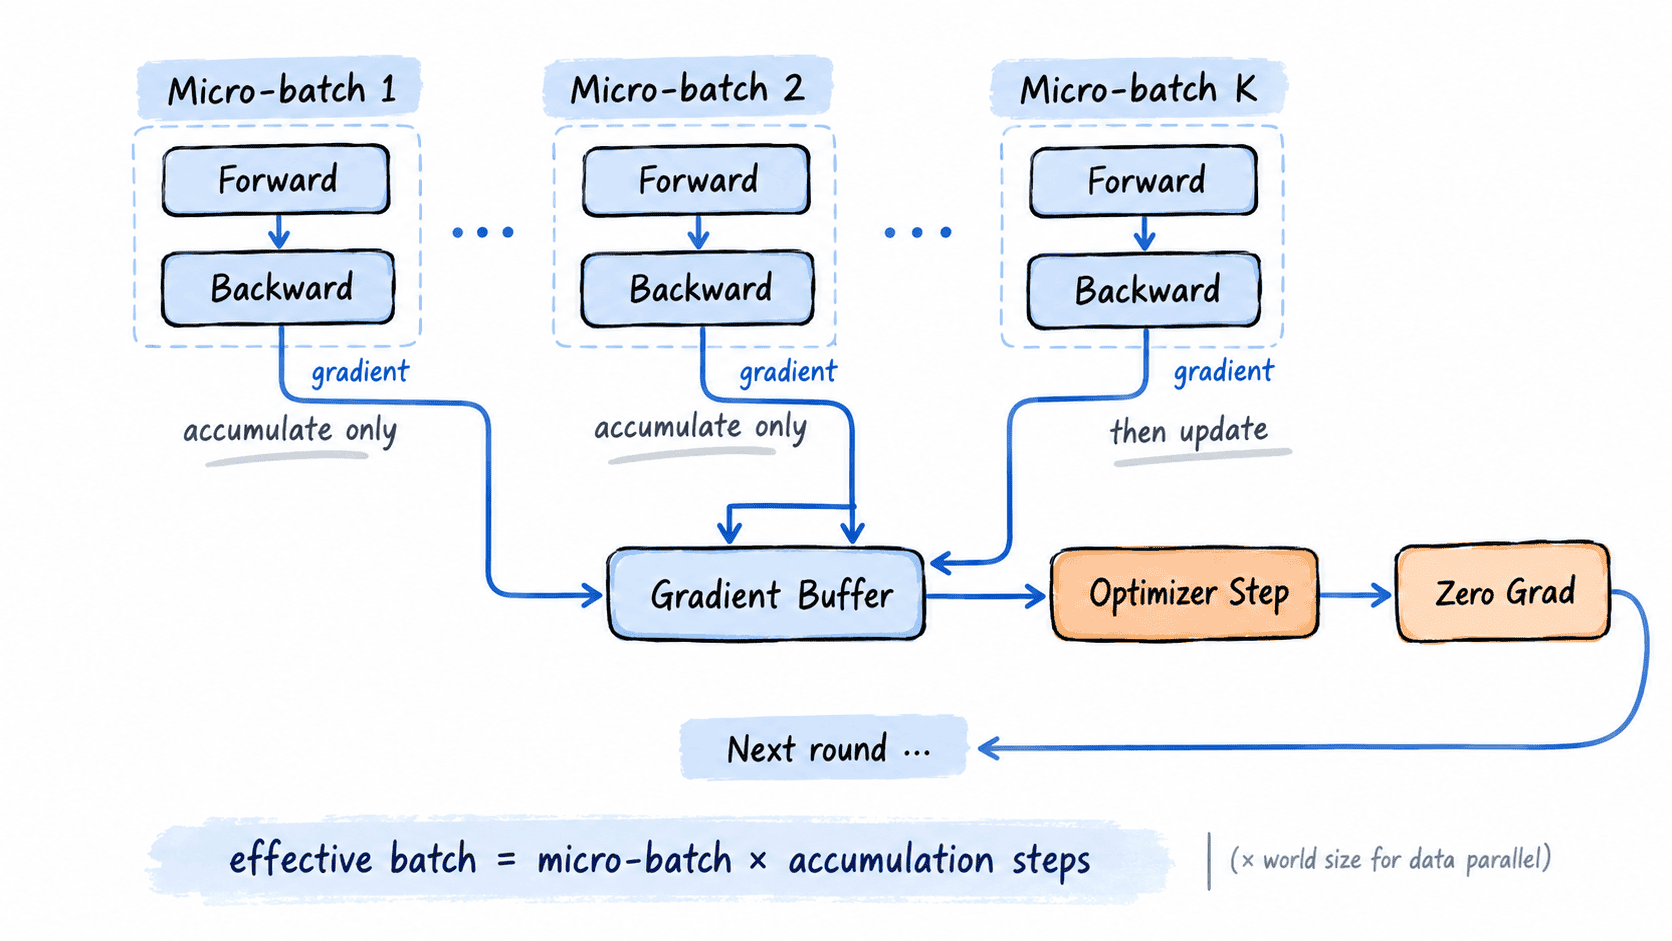
最容易犯的错误是每个 micro-batch 后都调用 zero_grad(),这样前面已经累积的梯度会被清掉;另一个错误是忘记按累积步数缩放损失,使累计梯度幅度比预期大约放大 倍。
跑通一个最小训练循环
下面示例要求已安装 PyTorch。8 条样本被分成 4 个 micro-batch,每 2 个 micro-batch 更新一次参数,因此最终发生 2 次优化器更新;为了让累积后的梯度等价于对两个 micro-batch 的平均损失求梯度,反向前将损失除以 accumulation_steps。
import torch

torch.manual_seed(0)

model = torch.nn.Linear(4, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
loss_fn = torch.nn.MSELoss()

x = torch.arange(32, dtype=torch.float32).reshape(8, 4) / 32
y = x.sum(dim=1, keepdim=True)

micro_batch_size = 2
accumulation_steps = 2
optimizer.zero_grad()
optimizer_steps = 0

for micro_step, start in enumerate(
    range(0, len(x), micro_batch_size),
    start=1,
):
    xb = x[start:start + micro_batch_size]
    yb = y[start:start + micro_batch_size]

    prediction = model(xb)
    loss = loss_fn(prediction, yb) / accumulation_steps
    loss.backward()

    if micro_step % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
        optimizer_steps += 1
        print(
            f"micro_step={micro_step} "
            f"optimizer_step={optimizer_steps}"
        )

print(
    "effective_batch_size="
    f"{micro_batch_size * accumulation_steps}"
)
预期输出
micro_step=2 optimizer_step=1
micro_step=4 optimizer_step=2
effective_batch_size=4
示例故意让 micro-batch 数量可以被累积步数整除。真实数据若最后只剩不足 个 micro-batch,仍要在训练结束前执行最后一次 step(),并重新考虑这一小组样本的损失缩放,不能直接把残余梯度丢掉。
梯度累积不等于免费的大批次
梯度累积主要节省的是激活与单步样本占用的显存,并不会减少总前向和反向计算量。累积步数越大,一次参数更新前需要执行的 micro-step 越多,因此“每秒优化器更新次数”通常会下降。
在数据并行训练中,effective batch size 还要乘并行进程数;如果每个 micro-step 都触发一次梯度同步,通信开销也会重复发生。实际使用 DDP 时,常在前 个 micro-step 抑制同步,只在真正更新前完成同步。
梯度累积的核心检查点只有三个:梯度是否跨 micro-batch 保留下来、损失是否按累积逻辑正确缩放、优化器是否只在预定边界更新。三者都满足时,才能把显存受限的小批次可靠地扩展成更大的有效批次。