
大模型原理与训练 / 系统课时
构造输入右移的训练目标
构造输入右移的训练目标
GPT 的训练目标不是复原整段文本,而是在每个位置预测紧随其后的词元。只要把同一段词元序列错开一位构造成输入与标签,就能把一条长度为 的序列变成多个下一词元预测任务,并在一次前向计算中并行求出这些位置的预测。
学习目标
- 从一段词元序列构造错开一位的输入与标签
- 理解一次前向计算为何能同时训练多个下一词元预测位置
- 避免重复移位、标签泄漏和 Padding 参与损失等常见错误
把一条序列变成多个预测任务
假设词元序列依次为 <BOS>、我、喜欢、模型、<EOS>。自回归训练要求模型看到当前位置及其左侧内容后,预测右侧紧邻的词元。因此输入去掉最后一个词元,标签去掉第一个词元:
输入 ,标签 。两者长度相同,但标签相对输入错开一位。
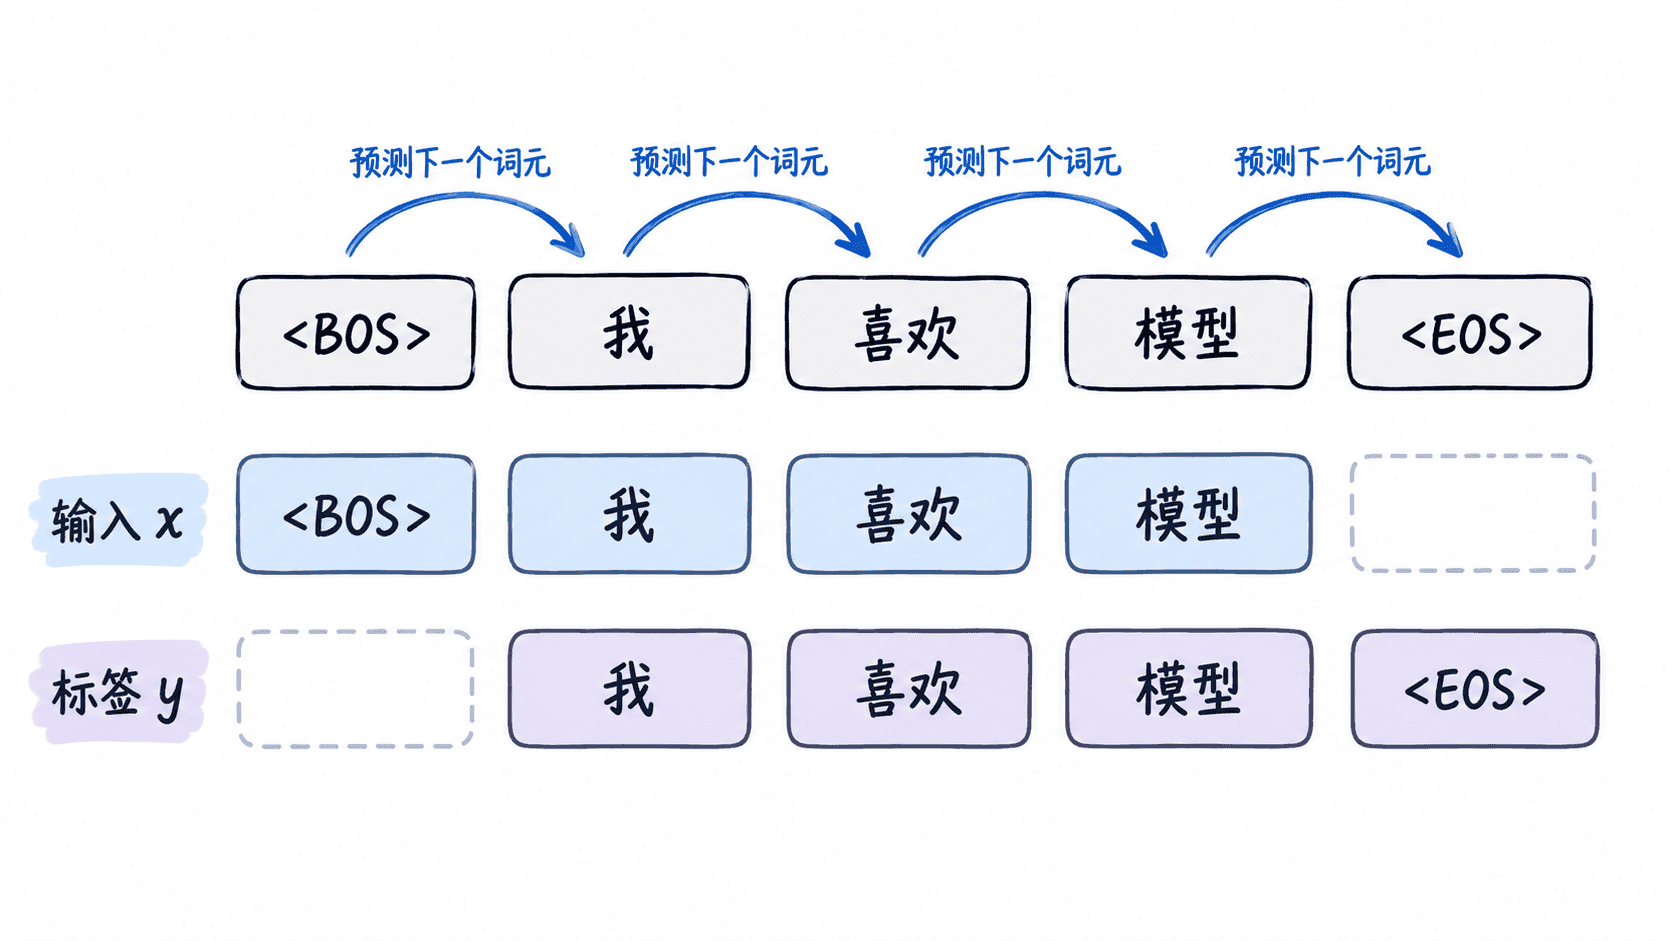
用最小 Python 示例可以直接观察这种错位关系:
tokens = ["<BOS>", "我", "喜欢", "模型", "<EOS>"]

# 输入去掉末尾,标签去掉开头,使每个位置对应“预测下一个词元”。
input_tokens = tokens[:-1]
target_tokens = tokens[1:]

for source, target in zip(input_tokens, target_tokens):
    print(f"{source} -> {target}")
预期输出
<BOS> -> 我
我 -> 喜欢
喜欢 -> 模型
模型 -> <EOS>
原序列有 5 个词元,因此产生 4 个有效预测位置。真实训练会把词元先转换为整数 ID,但错位规则完全相同。
一次前向为何能训练多个位置
Transformer 与逐步生成不同。训练时,整段输入可以同时送入模型,模型一次产生每个位置对应的 Logits。因果注意力掩码负责限制信息流:第 个位置只能读取自己和左侧位置,不能偷看右侧真正答案。
于是输入位置 <BOS> 的输出负责预测 我,位置 我 的输出负责预测 喜欢,其余位置同理。各位置的计算可以在矩阵运算中并行执行,最后分别与对应标签计算损失,再汇总为整段序列的训练损失。
实际训练中的移位方式
不同代码库对“谁负责移位”约定可能不同。手写训练循环时,可以显式构造 input_ids = ids[:-1] 与 labels = ids[1:];一些因果语言模型接口则允许输入和标签使用同一整段序列,并在损失实现内部完成位置错位。
关键不是固定采用哪一种写法,而是最终必须保证位置 的 Logits 与词元 比较。若调用的模型已经内部移位,又在数据阶段提前移位一次,就会产生二次错位,训练目标将从“下一个词元”错误地变成更远的位置。
处理边界位置与 Padding
序列最右端没有更右侧词元可预测,因此显式错位时自然会舍弃最后一个输入位置对应的不存在标签。若数据经过批量补齐,还要让 Padding 位置不参与损失,否则模型会被迫学习人为补齐符号的分布。
实际检查一批训练数据时,可以挑一条短序列,把词元 ID 还原成人类可读词元,并逐位置核对“当前输入 → 下一个标签”。只要错位关系、因果掩码和有效位置过滤三者一致,一次前向就能正确并行学习整段序列中的多个下一词元预测任务。