
大模型原理与训练 / 系统课时
让模型按提示连续生成文本
让模型按提示连续生成文本
本节把训练好的微型 GPT 变成可连续生成文本的自回归程序:从提示词开始,每次只预测一个新词元,再把它拼回上下文继续预测。你还会加入温度、top-k、重复惩罚和停止条件,避免输出过早终止或陷入机械循环。
学习目标
- 实现提示词编码、上下文裁剪、单步采样与回填组成的自回归生成循环。
- 理解温度、
top-k与重复惩罚分别怎样改变下一个词元的概率分布。 - 用最大生成长度、停止字符串或 EOS 设计可靠的停止边界,并定位重复问题。
自回归生成在循环什么
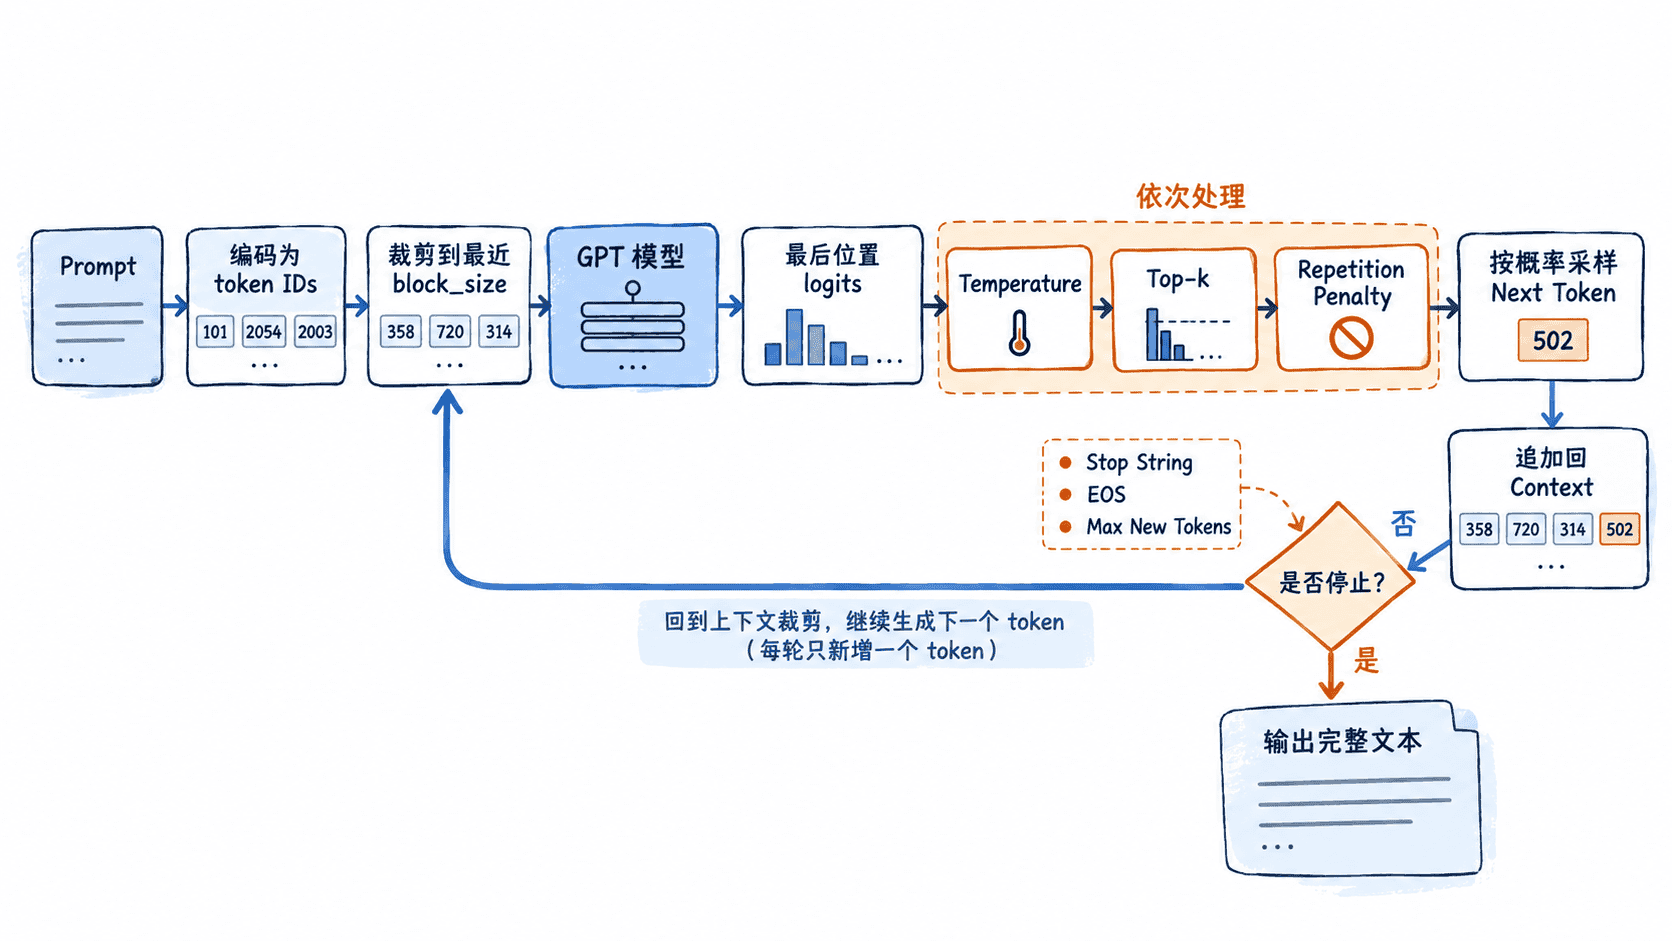
GPT 不会一次性写出整段文本。它先根据当前上下文得到最后一个位置的 logits,经过采样得到一个新词元,再把这个词元追加到序列尾部,重新执行同样过程。只要没有命中停止条件,这个循环就会持续。
模型的上下文窗口是有限的。序列长度超过 block_size 后,只能保留最后一段词元送回模型;这不是删除已经生成的文本,而是限制下一次前向计算能看到的历史范围。
采样参数分别控制什么
温度会缩放 logits。temperature < 1 会让高概率候选更占优势,结果更稳定;大于 1 会放大随机性。top_k 只保留概率最高的一小组候选,避免从长尾中抽到明显不合理的字符或词元。
重复惩罚解决的是另一类问题:模型可能已经非常确信某个局部模式,于是不断重复同一字符、单词或短句。本例对最近窗口中出现过的词元降低 logits。惩罚过大也会破坏正常语法,所以应在确认存在重复后再逐步增加。
停止条件至少要有一个硬边界。字符级模型通常没有 EOS,因此本例把 max_new_tokens 作为兜底,同时支持 stop_text;如果你的词表含 EOS,只需在采到对应 ID 时提前退出。
运行连续生成脚本
下面脚本与训练时使用同一个 TinyGPT 结构,并从 tiny_gpt.pt 恢复配置、字符表和参数。这个检查点应由你自己生成或来自可信来源,且字段至少包含 model_state、config、stoi 与 itos。
import torch
import torch.nn.functional as F
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"
checkpoint = torch.load(
    "tiny_gpt.pt",
    map_location=device,
    weights_only=True,
)
config = checkpoint["config"]
stoi = checkpoint["stoi"]
itos = checkpoint["itos"]

class TinyGPT(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.token_embedding = nn.Embedding(
            cfg["vocab_size"],
            cfg["d_model"],
        )
        self.position_embedding = nn.Embedding(
            cfg["block_size"],
            cfg["d_model"],
        )
        layer = nn.TransformerEncoderLayer(
            d_model=cfg["d_model"],
            nhead=cfg["n_head"],
            dim_feedforward=4 * cfg["d_model"],
            dropout=cfg["dropout"],
            batch_first=True,
            norm_first=True,
            activation="gelu",
        )
        self.blocks = nn.TransformerEncoder(
            layer,
            num_layers=cfg["n_layer"],
        )
        self.norm = nn.LayerNorm(cfg["d_model"])
        self.lm_head = nn.Linear(
            cfg["d_model"],
            cfg["vocab_size"],
        )

    def forward(self, idx):
        _, t = idx.shape
        pos = torch.arange(t, device=idx.device)
        x = self.token_embedding(idx) + self.position_embedding(pos)

        # 因果掩码保证当前词元不能利用未来位置。
        mask = torch.triu(
            torch.full((t, t), float("-inf"), device=idx.device),
            diagonal=1,
        )
        x = self.blocks(x, mask=mask)
        return self.lm_head(self.norm(x))

model = TinyGPT(config).to(device)
model.load_state_dict(checkpoint["model_state"])
model.eval()

def encode(text):
    unknown = sorted(set(text) - set(stoi))
    if unknown:
        raise ValueError(f"prompt contains unknown chars: {unknown}")
    return [stoi[ch] for ch in text]

def decode(ids):
    return "".join(itos[int(i)] for i in ids)

@torch.no_grad()
def generate(
    idx,
    max_new_tokens=120,
    temperature=0.8,
    top_k=8,
    repetition_penalty=0.4,
    repeat_window=24,
    stop_text=None,
):
    for _ in range(max_new_tokens):
        idx_cond = idx[:, -config["block_size"]:]
        logits = model(idx_cond)[:, -1, :]
        logits = logits / max(temperature, 1e-5)

        # 对最近出现过的词元做轻量惩罚,减少局部循环。
        recent = idx[:, -min(idx.size(1), repeat_window):]
        recent_ids = torch.unique(recent)
        logits[:, recent_ids] = (
            logits[:, recent_ids] - repetition_penalty
        )

        k = min(top_k, logits.size(-1))
        top_values, _ = torch.topk(logits, k)
        cutoff = top_values[:, -1].unsqueeze(-1)
        logits = torch.where(
            logits < cutoff,
            torch.full_like(logits, float("-inf")),
            logits,
        )

        probs = F.softmax(logits, dim=-1)
        next_id = torch.multinomial(probs, num_samples=1)
        idx = torch.cat([idx, next_id], dim=1)

        # stop_text 是软停止条件,max_new_tokens 始终提供硬上限。
        if stop_text and decode(idx[0].tolist()).endswith(stop_text):
            break

    return idx

prompt = "to be"
input_ids = torch.tensor(
    [encode(prompt)],
    dtype=torch.long,
    device=device,
)
output_ids = generate(
    input_ids,
    max_new_tokens=120,
    temperature=0.8,
    top_k=8,
    repetition_penalty=0.4,
    stop_text=" question ",
)
print("prompt:", prompt)
print("completion:", decode(output_ids[0].tolist()))
预期输出
prompt: to be
completion: to be<GENERATED_TEXT>
<GENERATED_TEXT> 每次运行都可能不同,因为 torch.multinomial 会按概率采样。若模型一直没有生成 question,循环会在新增 120 个字符后停止;若提前生成该字符串,则立即结束。
排查停止与重复
如果输出几乎立刻终止,先检查 stop_text 是否本来就容易出现在提示词附近,以及停止判断是否误用了“包含”而不是“以该序列结尾”。若使用带 EOS 的词表,还要确认 EOS 的 ID 与训练时一致。
如果文本反复出现同一小段,可以先把 repetition_penalty 从 0.4 小幅提高,再观察语法是否被破坏;也可以适度提高 top_k,让模型拥有更多合理候选。相反,如果输出过于随机,应降低温度或缩小 top_k,而不是单纯增加重复惩罚。
同一个提示连续生成多次时,结果不同是采样的正常表现。验收时应重点确认三件事:提示词没有未知字符、每轮只追加一个词元且上下文正确裁剪、停止条件总能在有限步数内结束生成。