
大模型原理与训练 / 系统课时
串起残差归一化与前馈层
串起残差归一化与前馈层
一个 Transformer Block 不只有注意力。注意力完成 Token 之间的信息交换后,还要经过残差连接、LayerNorm 和前馈网络,才能形成稳定而有表达力的深层网络。本节沿一条数据路径拆开这些组件各自承担的职责。
学习目标
- 沿 Transformer Block 追踪注意力、残差、LayerNorm 与前馈网络的数据流
- 解释残差连接和 LayerNorm 为什么有助于深层网络稳定训练
- 理解前馈网络与自注意力在信息处理方式上的分工
一个 Block 里有两种主要变换
典型 Transformer Block 可以看成两个连续的子层:自注意力子层负责让不同 Token 交换信息,前馈网络子层负责对每个 Token 的表示独立做非线性变换。残差连接与归一化围绕这两个子层出现,用来保持信息通路和控制数值尺度。
现代 GPT 类模型经常采用 Pre-LN 结构,可以抽象成:
这里的 、、 形状通常保持一致,因此每个子层的结果都能与原输入逐元素相加。不同模型会调整归一化类型、激活函数或具体顺序,但“信息变换加一条残差主干”是理解 Block 的关键。
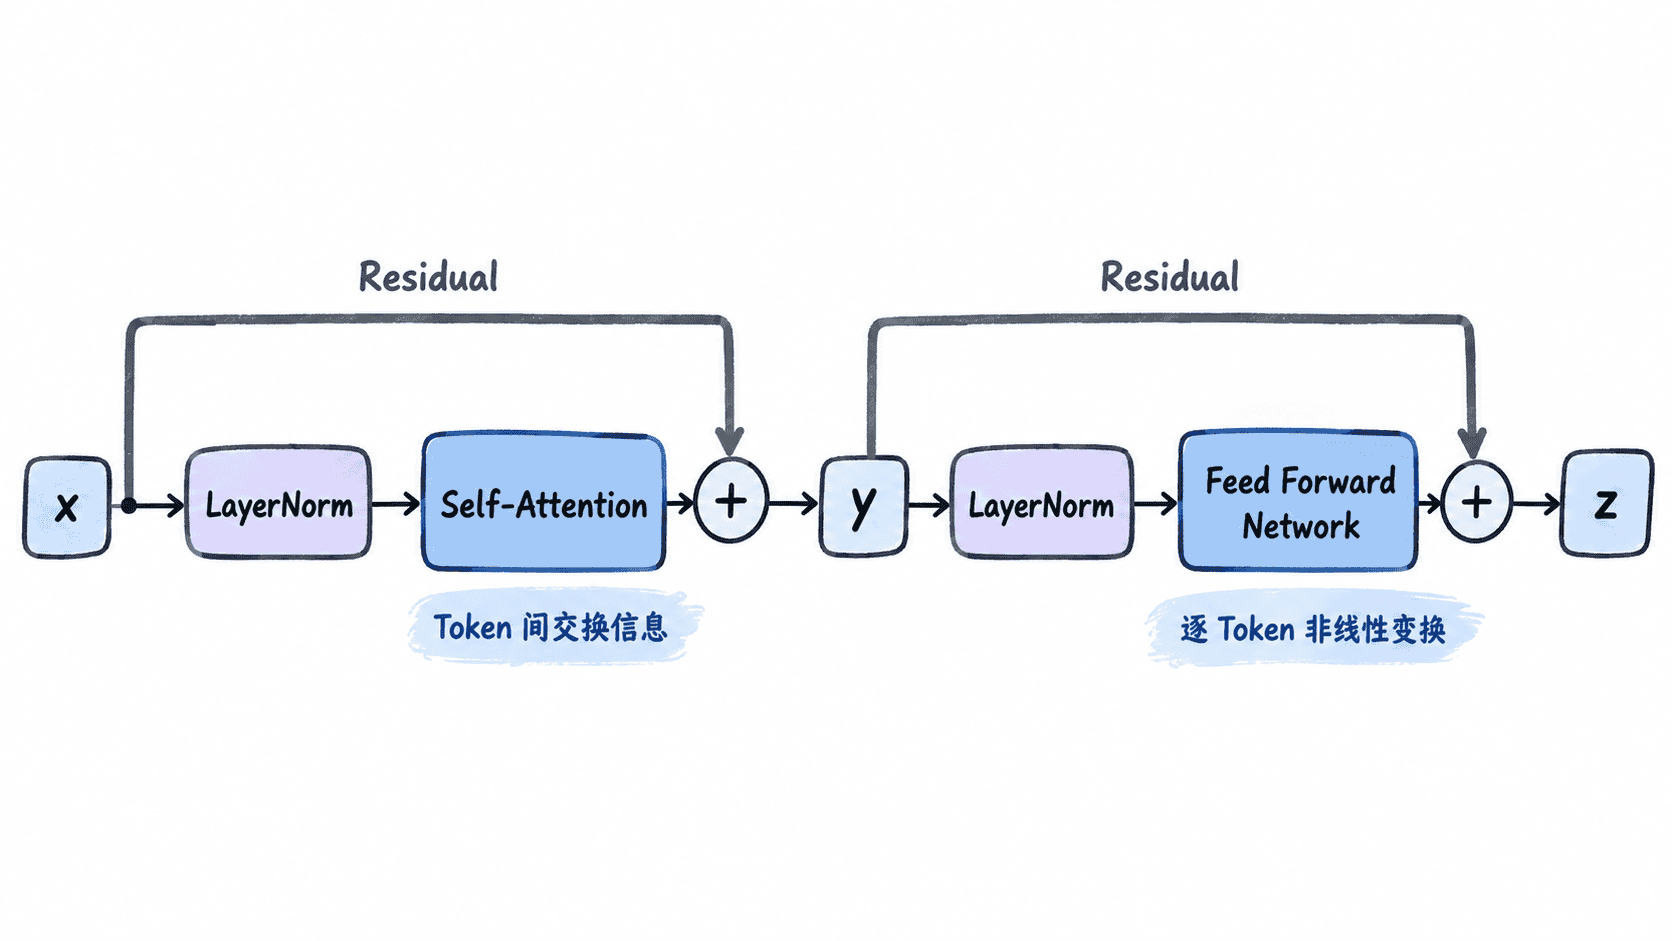
残差连接保留一条直接的信息通路
假设某个子层计算函数为 。没有残差时,下一层只能得到 ;加入残差后得到:
这意味着子层不必重新构造全部表示,而可以学习“在已有表示上应该修改什么”。如果当前子层只需要很小的调整, 可以接近零,原来的 仍能直接向后传播。
这条旁路对深层网络尤其重要。反向传播时,梯度除了经过复杂的子层计算,还存在穿过加法节点的直接路径,因此深度增加时训练通常更容易。残差并不保证梯度永远不会出现问题,但它显著改善了深层堆叠中的优化条件。
LayerNorm 控制每个 Token 表示的尺度
随着许多 Block 连续堆叠,不同特征维度的数值分布会不断变化。LayerNorm 对单个 Token 的隐藏向量在特征维度上做归一化,再通过可学习的缩放和偏移恢复模型需要的表达范围。
对隐藏向量 ,其核心形式可以写成:
这里的 和 来自该隐藏向量自身的特征维度,而不是依赖一个 batch 中其他样本。因此 LayerNorm 很适合序列模型,不需要通过批大小来获得稳定的统计量。
需要特别区分 LayerNorm 与残差的职责:残差解决的是信息和梯度能否保留直接通路,归一化解决的是进入复杂变换前后数值尺度是否容易控制。两者经常一起出现,但并不是同一种机制。
前馈网络负责逐 Token 的非线性加工
自注意力完成的是 Token 之间的信息混合。得到上下文信息后,每个位置还需要把自己的表示进一步转换,这就是前馈网络的工作。经典形式包含两次线性变换和一次非线性激活:
第一层通常先把隐藏维度扩展到更宽的中间维度,激活函数产生非线性,再由第二层投影回 。同一个 Block 中的所有 Token 使用同一组 FFN 参数,但每个位置分别计算,不会像注意力那样直接读取其他位置的向量。
因此可以用一句分工来记忆:**Attention 在位置之间搬运和组合信息,FFN 在单个位置内部加工已经聚合好的信息。**如果只有注意力而缺少强有力的非线性变换,模型对每个 Token 表示的特征重组能力会受到明显限制。
Pre-LN 与 Post-LN 不要混为一谈
Transformer 原始结构常被描述为对子层结果先做残差相加,再归一化,即类似 的 Post-LN。许多现代 GPT 架构则把归一化移到子层之前,形成前面看到的 Pre-LN:。
两者都包含残差、归一化和子层变换,但梯度传播路径与训练行为并不完全相同。阅读模型实现时,不能只看到“都有 LayerNorm”就认为 Block 等价,应实际检查归一化发生在注意力和 FFN 的前面还是后面。
沿 Pre-LN Block 顺序追踪一次即可建立完整心智模型:输入先归一化并参加注意力,注意力结果通过残差加回原表示;新的表示再次归一化,经过 FFN 做逐位置非线性变换,再通过第二次残差合并。这样一个 Block 同时完成跨 Token 通信、局部特征加工以及稳定的深层信息传递。