
大模型原理与训练 / 系统课时
用 RoPE 注入相对位置信息
用 RoPE 注入相对位置信息
自注意力如果只比较 token 内容,本身无法知道两个 token 谁在前、相隔多远。RoPE 通过按位置旋转 Q 和 K 的二维分量,让注意力内积自然携带相对距离信息。本节还会说明为什么把上下文直接拉长到训练范围之外存在风险。
学习目标
- 解释 RoPE 如何按位置旋转 Q 和 K 的成对维度
- 理解注意力内积为什么能够得到相对位置
- 识别上下文扩展时位置外推带来的分布偏移风险
把位置变成旋转角度
RoPE 的核心不是给 token 向量直接加一个位置向量,而是对 Query 和 Key 做与位置有关的旋转。对于隐藏维度中的第 组二维分量,位置 对应旋转角 ,不同维度组使用不同频率 。
若原始 Query 的一组分量为 ,旋转后可写成:
Key 使用同样的规则,只是位置可能是 。旋转不会额外增加向量维度,也不需要为每个位置学习一套独立参数;位置信息直接进入随后计算注意力分数的 Q/K 表示。
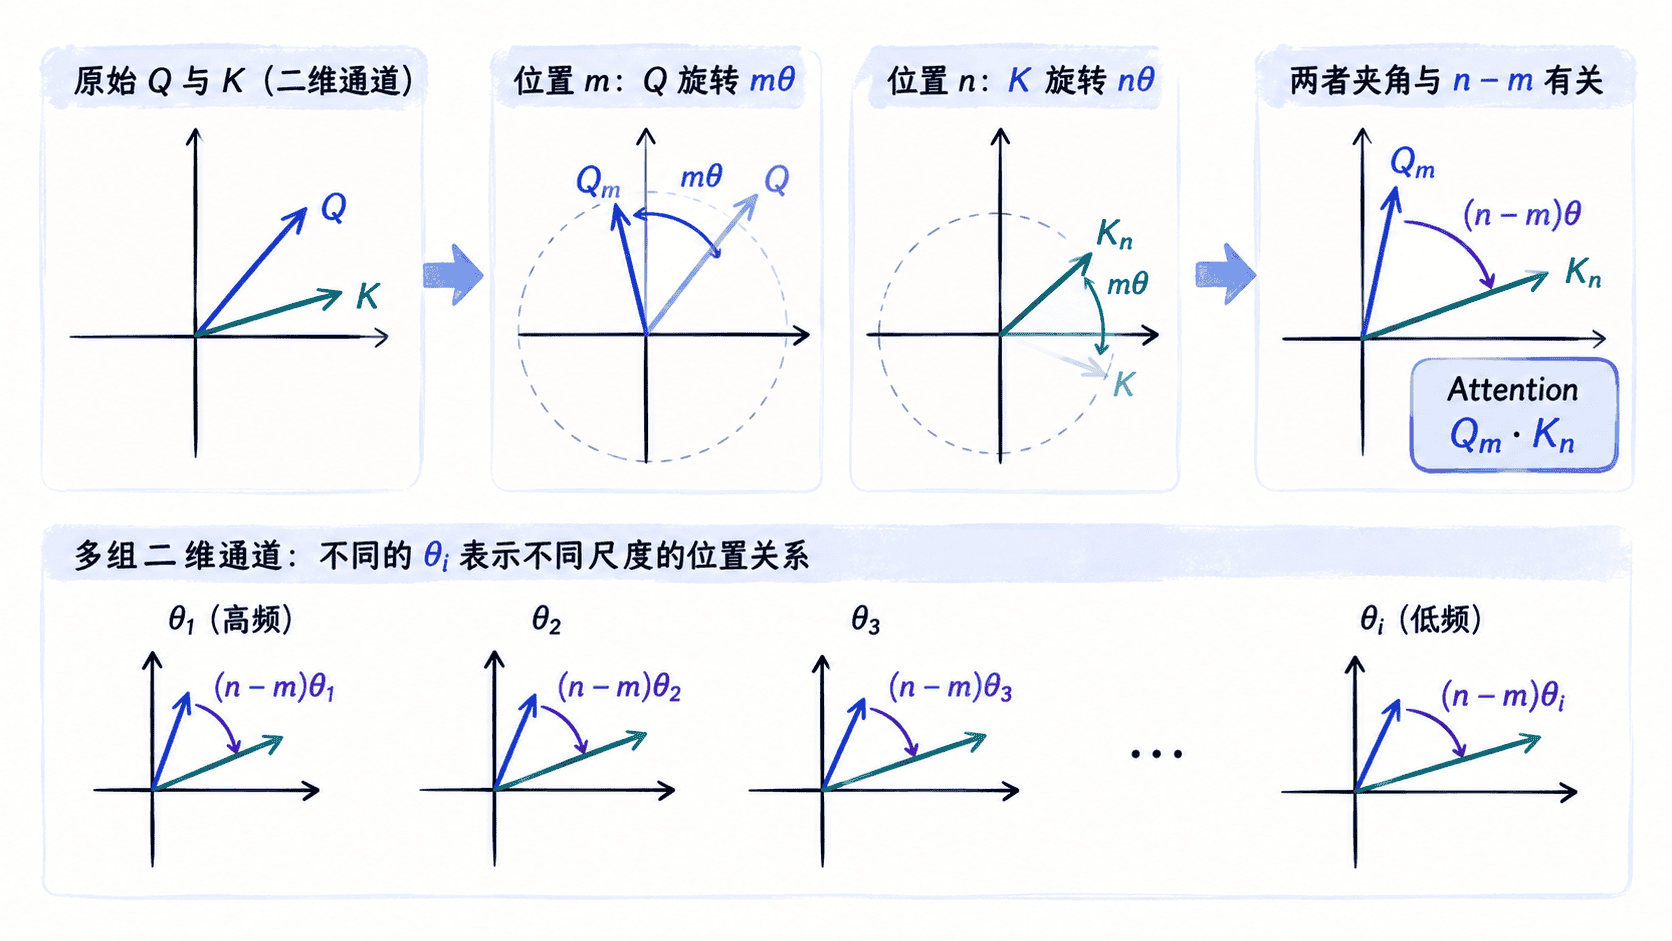
内积只保留相对位置
设 表示位置 对应的旋转,位置 的 Query 为 ,位置 的 Key 为 。计算注意力分数时会出现:
关键就在右侧:两个绝对位置 和 被组合成了相对位移 。因此,同样相隔 3 个位置的一对 token,即使整体向后移动,它们在旋转关系上仍保留一致的相对距离结构。
不同维度组使用不同旋转频率也很重要。较高频率的维度对短距离变化更敏感,较低频率的维度变化更慢,可以表达更长尺度的位置关系。模型最终在多个频率上同时比较 token 内容与相对位置。
这也是 RoPE 与简单绝对位置嵌入的重要区别:位置没有只在输入层出现一次,而是直接参与每一层注意力中 Q/K 的几何关系。
为什么长上下文不是免费得到的
RoPE 的公式可以计算任意大的位置编号,但“能够算出旋转角”不等于模型已经学会处理任意长度。假设训练时模型主要见过位置 到 ,推理时突然使用远大于 的位置,就会出现位置外推。
随着位置增加,各频率对应的相位继续旋转。一些维度组合会进入训练阶段很少甚至从未出现过的相位关系,注意力分数的统计分布也可能随之改变。模型因此可能出现长距离检索下降、近远位置偏好异常,或者生成质量在超过某个长度后快速恶化。
扩展上下文时要看什么
实际模型常通过位置缩放、频率调整或在更长序列上继续训练来扩展 RoPE 的工作范围。这些方法的共同目标,是让推理阶段的位置相位关系尽量落在模型能够处理的范围内,而不是简单把最大位置编号改大。
评估扩展是否成功时,不应只检查模型能否接受更长输入,还要观察长距离信息检索、困惑度或任务准确率是否随长度稳定,并同时检查短上下文能力有没有明显退化。一个模型能够完成 128K token 的前向计算,并不自动意味着它能可靠利用 128K token 中的全部信息。
RoPE 的价值在于把位置编码转化成 Q/K 的旋转,使注意力内积天然依赖相对距离;它的限制也来自同一套旋转几何。理解相位、频率和训练位置范围之间的关系,才能正确判断一个模型的长上下文能力来自哪里,以及外推到更长序列时为什么需要额外设计。