
大模型原理与训练 / 系统课时
理解门控前馈层的表达优势
理解门控前馈层的表达优势
普通前馈层让中间通道经过单一路径的非线性变换;SwiGLU 则把输入投影成两条分支,再让其中一条逐元素调制另一条。看懂这次“先分流、再相乘”,就能理解门控为何增强通道选择和非线性表达。
学习目标
- 写出标准前馈层与 SwiGLU 的计算形式
- 解释门控分支如何根据当前输入调节中间通道
- 理解门控带来的表达能力与参数开销之间的取舍
标准前馈层只有一条变换主路
Transformer 的前馈网络通常对每个 token 独立计算。经典形式可以写成:
输入先通过 投影到更宽的中间维度,再经过激活函数,最后由 投影回模型维度。每个中间通道是否产生较强响应,主要由同一个投影结果和固定激活函数 决定,没有另一组独立特征专门控制它的传递强度。
SwiGLU 把输入拆成门和值两条分支
SwiGLU 常写成:
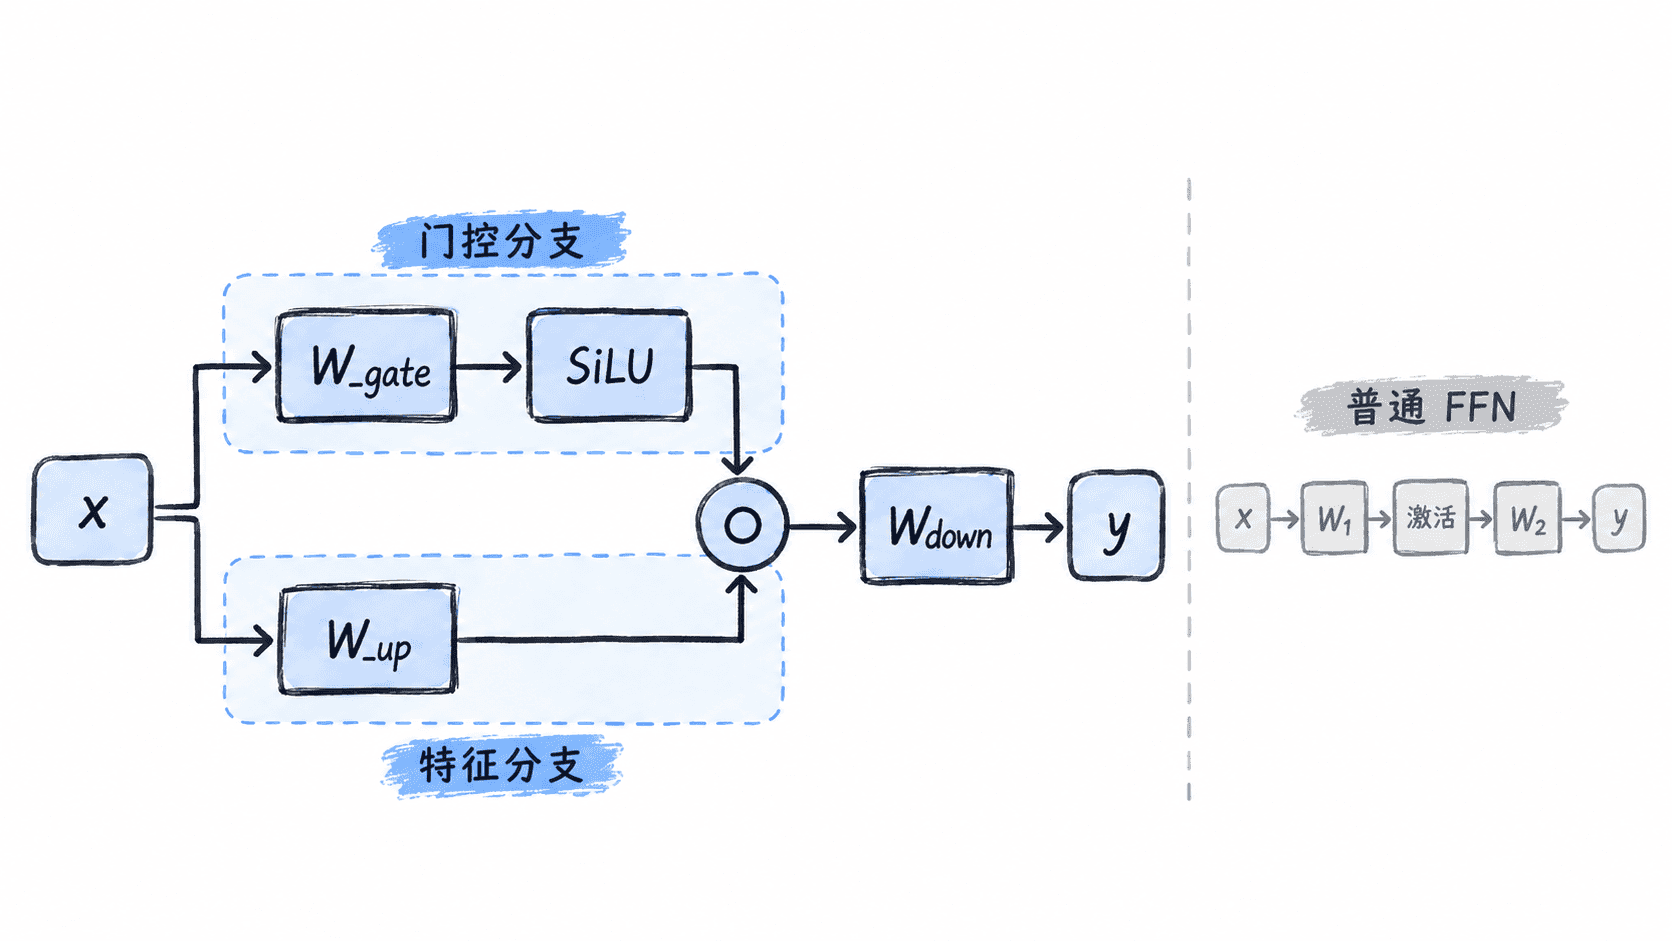
其中 表示逐元素乘法。输入 同时进入两个独立线性投影:一条经过 SiLU 形成门控信号,另一条产生待传递的特征;二者相乘后,再由降维投影得到输出。
乘法让通道选择依赖当前输入
对某个中间通道 ,SwiGLU 可以写成:
这里 与 来自两组不同参数。门控分支响应幅值较小时,对应特征会被削弱;响应幅值较大时,另一分支的特征就能以更强权重进入后续计算。因此“这个通道表达什么”和“当前输入下应该传递多少”不再完全由同一次投影决定。
这种逐元素乘法与简单相加不同。相加只是叠加两组特征,而相乘会让一组特征直接调制另一组特征,从而引入输入相关的乘法交互,使前馈层能够形成更丰富的条件化表示。
表达增强不是免费的
如果 SwiGLU 保持与传统 FFN 完全相同的中间维度,就会因为多出一个输入投影而增加参数量和计算量。因此实际模型设计通常会缩小门控前馈层的中间维度,使整体参数预算与传统 FFN 接近,再利用门控乘法获得更强的表达能力。
这也是比较两种结构时容易忽略的地方:不能只比较“中间维度是多少”,还要同时计算升维投影、门控投影和降维投影三个矩阵的规模。不同模型会根据吞吐、显存和参数预算选择不同的中间宽度。
读懂实现时抓住数据流
具体代码可能使用 gate_proj、up_proj、down_proj 等名称,也可能把两个输入投影合并成一次更大的矩阵乘法,随后再切分张量。命名和实现优化可以变化,但数学结构应满足四个动作:输入形成两条投影、一支经过门控激活、两支逐元素相乘、结果再投影回模型维度。
SwiGLU 的核心价值不只是把激活函数换成 SiLU,而是通过独立门控分支引入乘法调制。它让前馈层能够根据当前 token 的表示,更细致地强化、抑制和组合不同中间通道。