
大模型原理与训练 / 系统课时
读懂批次、序列与隐藏维度
读懂批次、序列与隐藏维度
这一节只解决一个高频问题:看到形如 [B, S, H] 的张量时,立刻知道每个维度在表示什么,以及某次切片、线性变换或注意力拆头后形状会怎样变化。把 batch、sequence、hidden 三个轴固定下来,后续注意力计算就不容易在维度上迷路。
学习目标
- 准确解释 batch、sequence、hidden 三个维度的语义
- 根据操作判断张量形状中哪些维度保持、哪些维度变化
- 用切片验证
[B, S, H]中单个样本、单个位置和单个隐藏向量的对应关系
把 [B, S, H] 当成三个正交轴
语言模型通常把一批序列表示成三维张量:
B 是 batch size,表示一次并行处理多少条样本;S 是 sequence length,表示每条样本包含多少个词元位置;H 是 hidden size,表示每个位置用多少个数来表示。
例如形状 [2, 3, 4] 表示:有 2 条样本,每条有 3 个词元位置,每个位置由 4 维隐藏向量表示。总元素数是 ,但这 24 个数不能被随意当成一条长向量,因为三个轴承担完全不同的语义。
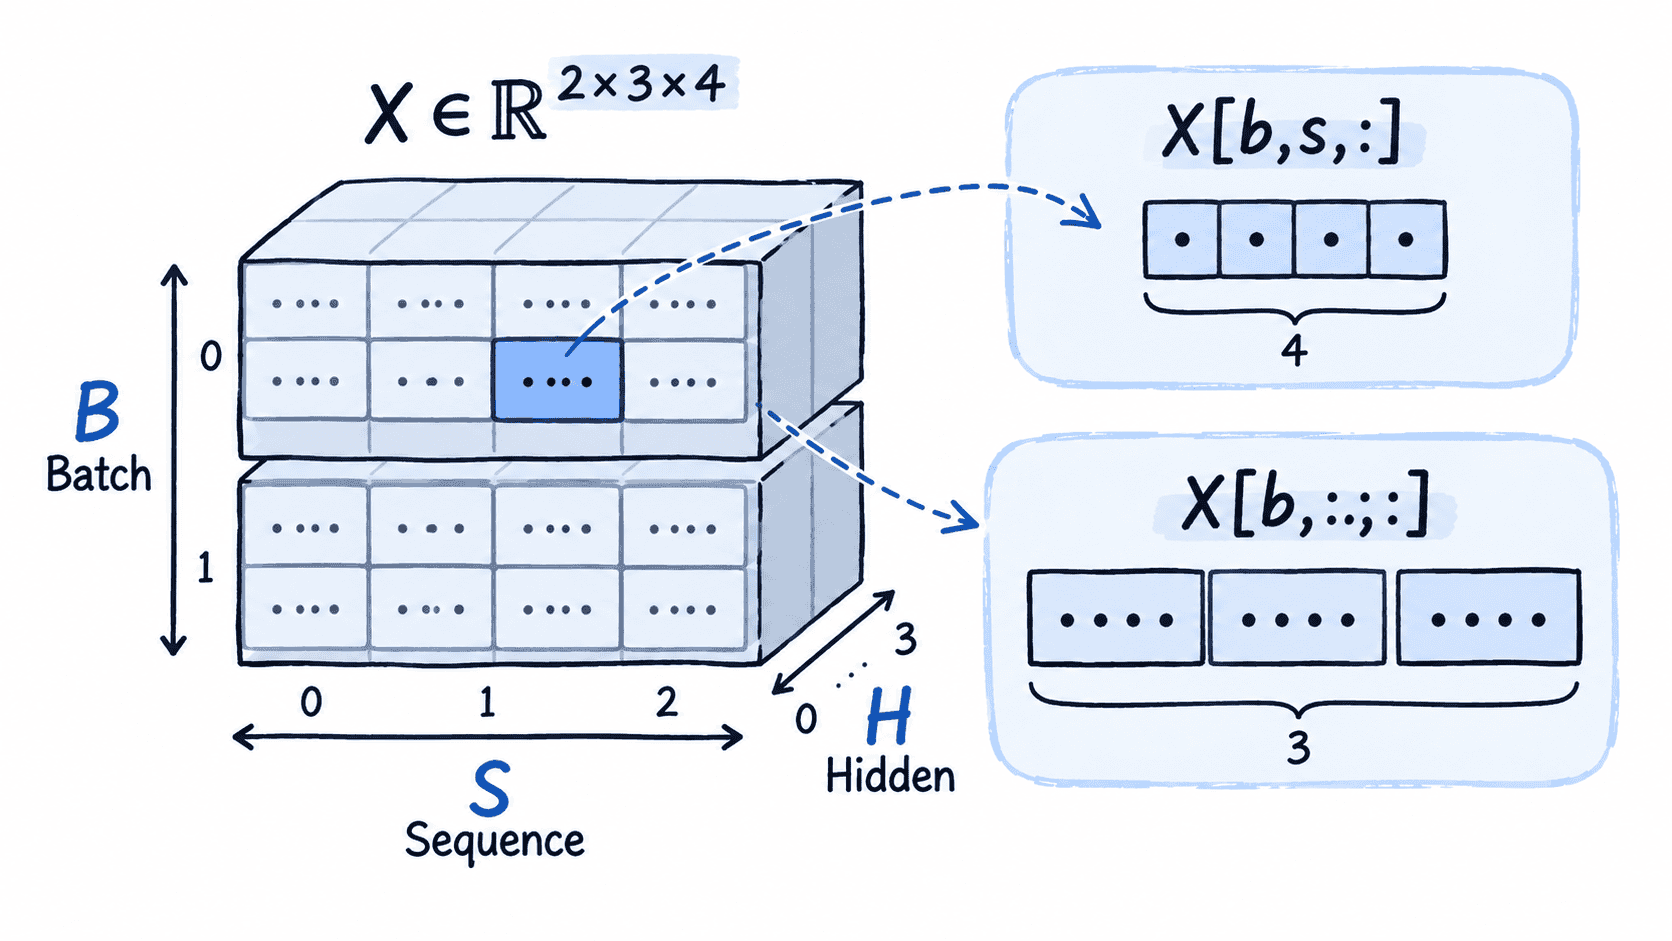
用切片验证每个轴的含义
下面用 PyTorch 构造一个值从 0 到 23 的张量。连续数字不是模型真实隐藏状态,只是为了让切片结果一眼可核对。
import torch

x = torch.arange(24).reshape(2, 3, 4)

print("x.shape =", tuple(x.shape))
print("sample 0 shape =", tuple(x[0].shape))
print("position [0, 1] =", x[0, 1].tolist())
print("hidden dim 2 =", x[:, :, 2].tolist())
预期输出
x.shape = (2, 3, 4)
sample 0 shape = (3, 4)
position [0, 1] = [4, 5, 6, 7]
hidden dim 2 = [[2, 6, 10], [14, 18, 22]]
x[0] 固定了 batch 轴,所以剩下 [S, H] = [3, 4];x[0, 1] 同时固定 batch 和 sequence,只剩长度为 4 的隐藏向量;x[:, :, 2] 固定 hidden 轴,因此得到 [B, S] = [2, 3]。
判断形状变化先看操作作用在哪个轴
大多数 Transformer 操作并不会同时改变三个轴。词元嵌入通常把整数 ID 张量 [B, S] 映射为 [B, S, H];逐位置线性层只改变最后一维,例如 [B, S, H] 经过输出投影后变成 [B, S, V],其中 V 是词表大小。
注意力拆成多头时,常见做法是把 H 重排为 num_heads × head_dim。若 H = 768、num_heads = 12,则 head_dim = 64,形状可从 [B, S, 768] 重排为 [B, S, 12, 64],再根据实现调整轴顺序。元素总数没有变化,变化的是解释这些元素的方式。
三个常见误区
不要把 S 当成“文本字符数”。序列长度统计的是词元位置,分词后一个词可能对应一个或多个 token。也不要把 H 当成词表大小;隐藏维度描述内部表示宽度,词表大小 V 只会在输入嵌入表或最终输出投影附近出现。
最后,batch 轴通常只是为了并行计算,不表示样本之间会互相注意。标准自注意力在每条序列内部建立位置关系,不会因为把两条句子放进同一个 batch 就让它们共享上下文。
只要把 [B, S, H] 读成“多少条样本 × 每条多少位置 × 每个位置多少特征”,再逐步追踪操作作用的轴,后续的 Q、K、V、多头拆分和注意力矩阵形状都能沿同一套方法推导。