
大模型原理与训练 / 系统课时
用 KV Cache 避免重复计算
用 KV Cache 避免重复计算
自回归生成每次只新增一个词元,但新词元仍要关注前面的全部历史。如果每一轮都重新计算所有历史位置,绝大多数工作都会重复。KV Cache 的核心价值,就是把已经算过的 Key 和 Value 留下来,让下一轮只计算新增部分。
学习目标
- 解释为什么历史 Key、Value 可以跨 Decode 步复用
- 区分需要缓存的 K/V 与无需长期缓存的 Query
- 能根据层数、序列长度、KV 头数和数据类型估算缓存占用
没有缓存时会重复什么
在因果自注意力中,第 t 个词元只能关注位置 1 到 t。生成第 t+1 个词元时,位置 1 到 t 的输入表示没有发生变化,因此这些历史位置在各层投影得到的 Key、Value 也不会变化。
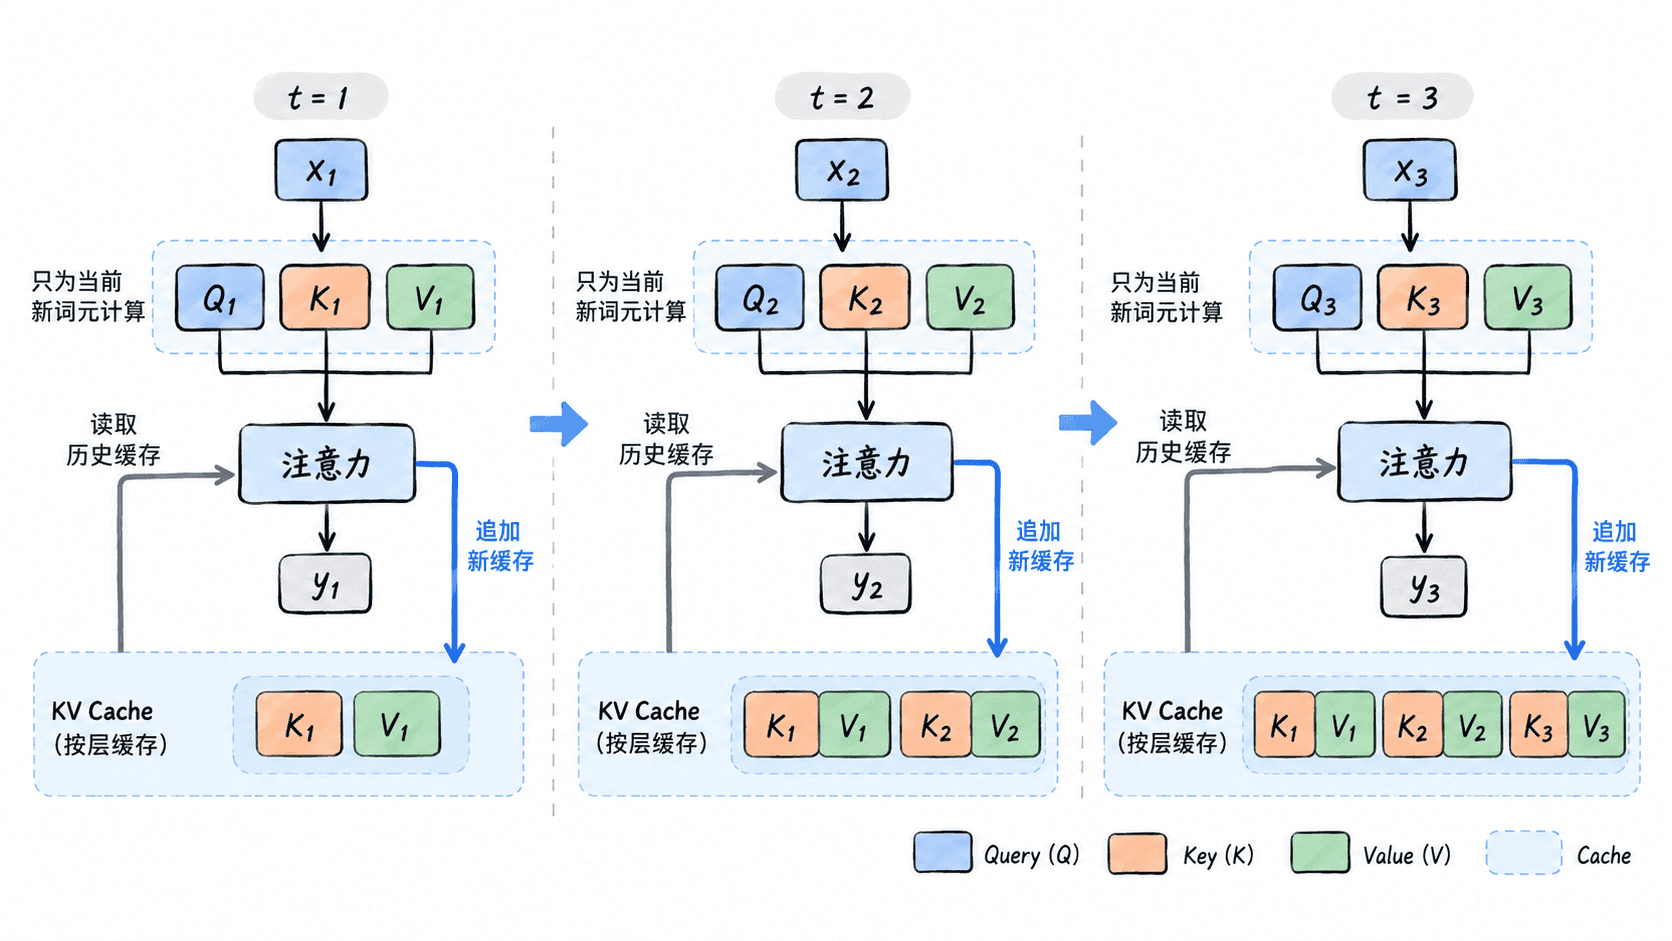
如果每轮都把完整序列重新送进模型,历史 K/V 会被一遍遍重新计算。序列越长,重复部分越大。KV Cache 把这部分结果保存在显存中,使每次 Decode 只为最新词元计算新的 Q、K、V,然后把新 K/V 追加到缓存末尾。
为什么缓存 K 和 V 而不是 Q
历史 Key 决定“当前 Query 应该和哪些历史位置匹配”,历史 Value 则承载这些位置真正被聚合的内容。后续每一个新词元都会再次用到历史 K/V,所以保存它们可以直接消除重复投影计算。
历史 Query 的用途不同。某个位置的 Query 只在计算该位置自己的注意力输出时使用一次,后面的词元不会再次拿它作为查询。因此常规自回归 Decode 不需要长期保存历史 Query,只需要保留各层历史 K/V。
KV Cache 是逐层保存的。每一层都有自己的 K/V,不能只缓存最后一层;并且缓存长度会随着已处理序列不断增长,直到请求结束、上下文被截断,或服务系统主动回收对应缓存页。
缓存大小怎么算
忽略对齐、分页和框架元数据时,单个批次的 KV Cache 可以近似写成:
其中前面的 2 代表 K 和 V 两份张量; 是层数, 是当前缓存的序列长度, 是每层 Key/Value 头数, 是每个头的维度, 是每个元素占用的字节数。
例如一个模型有 32 层,序列长度为 4096,使用 8 个 KV 头,每个头维度 128,缓存采用 BF16,每个元素 2 字节,批大小为 1:
( 2 × 32 × 4096 × 8 × 128 × 2 = 536870912 )
也就是约 512 MiB。若序列长度翻倍到 8192,其他参数不变,缓存也近似翻倍到 1 GiB。多并发请求还会让总占用继续按批量或活跃序列数增长。
MHA、GQA 与 MQA 会改变占用
标准多头注意力中,KV 头数通常与 Query 头数相同;GQA 让多个 Query 头共享较少的 K/V 头;MQA 则进一步把 K/V 头减少到 1。对 KV Cache 来说,关键变量不是 Query 头数,而是公式里的 。
假设其他参数完全相同,把 KV 头从 32 降到 8,缓存理论占用约变为原来的四分之一。这也是长上下文模型常使用 GQA 或 MQA 的原因之一:它们不仅减少缓存空间,也减少 Decode 时需要从显存读取的 K/V 数据量。
缓存换来的不是零成本
KV Cache 用显存容量换取了更少的重复计算。序列越长、并发越高,缓存占用越显著,Decode 每一步还必须读取越来越长的历史 K/V,所以它解决的是“不要重复算历史投影”,并没有消除“访问越来越多历史状态”的成本。
因此评估长上下文推理时,应同时看算力和缓存:Prefill 决定长提示词首次处理有多重,KV Cache 决定历史结果如何复用,而不断增长的缓存容量与读取带宽又会继续约束后续 Decode。