
大模型原理与训练 / 系统课时
用学习率计划避免训练震荡
用学习率计划避免训练震荡
大模型训练不能只把学习率设成一个固定值后一路跑到底。本节把预热、峰值学习率和衰减串成一条可操作的计划,并用损失曲线的典型形态判断学习率过大、过小或基本合适。
学习目标
- 解释预热、峰值学习率与衰减阶段各自解决的问题。
- 写出一个可运行的预热加余弦衰减学习率计划。
- 根据训练损失的尖峰、平台期和收敛速度调整学习率。
学习率为什么要分阶段
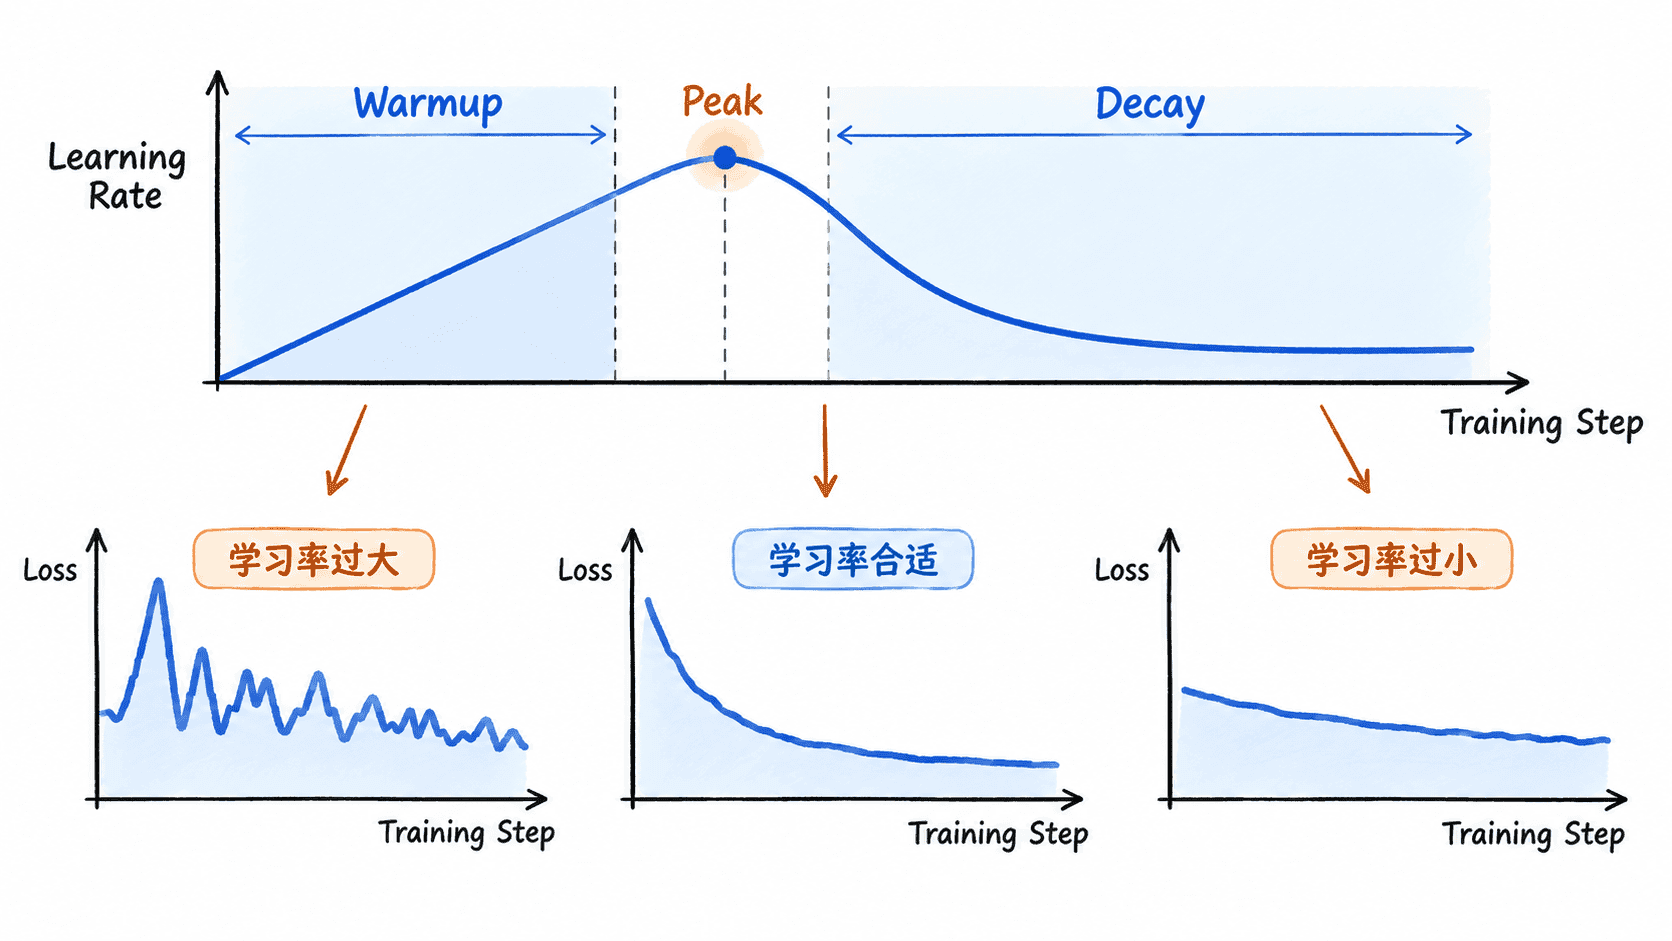
训练刚开始时,参数还未进入稳定区域,优化器内部统计量也在建立。若第一步就使用较大的峰值学习率,参数更新可能突然跨得过远,表现为损失剧烈尖峰、梯度异常放大,严重时直接出现非有限值。
预热阶段让学习率从较小值逐步升高,使模型先适应更新尺度;达到峰值后进入主要学习阶段;训练后段再逐步衰减,使参数在已经找到的较优区域内做更细的调整,减少来回震荡。
写一个最小学习率计划
下面用纯 Python 实现“线性预热 + 余弦衰减”。示例把第 10 步设为峰值,随后逐步衰减到最小学习率;真实训练中把 total_steps 替换为实际优化器更新次数。
import math

total_steps = 100
warmup_steps = 10
peak_lr = 3e-4
min_lr = 3e-5

def learning_rate(step: int) -> float:
    if not 1 <= step <= total_steps:
        raise ValueError("step out of range")

    if step <= warmup_steps:
        return peak_lr * step / warmup_steps

    progress = (step - warmup_steps) / (total_steps - warmup_steps)
    cosine = 0.5 * (1.0 + math.cos(math.pi * progress))
    return min_lr + (peak_lr - min_lr) * cosine

for step in (1, 5, 10, 50, 100):
    print(f"step={step:3d} lr={learning_rate(step):.8f}")
预期输出
step=  1 lr=0.00003000
step=  5 lr=0.00015000
step= 10 lr=0.00030000
step= 50 lr=0.00018844
step=100 lr=0.00003000
这里的关键不是固定采用余弦函数,而是保证学习率变化与训练阶段一致:开始阶段避免突然的大更新,中段提供足够的学习速度,后段逐渐减小步幅。线性衰减等其他方案也可以满足同样目标。
从损失曲线反推学习率
学习率过大时,最常见的信号是损失频繁出现高尖峰、短时间内大幅上下摆动,或训练在某一步突然发散。应先降低峰值学习率;如果问题集中在训练最早期,也可以延长预热,再观察尖峰是否消失。
学习率过小时,损失通常不会爆炸,却会长期缓慢下降,训练预算消耗很多但收益有限。此时可以小幅提高峰值学习率,并确认梯度和损失仍保持稳定。不要仅凭单个 batch 的波动下结论,应看一段窗口内的趋势。
调参时保持一次只改一个变量
最稳妥的做法是先固定优化器、批次和数据顺序,用较短训练运行比较几组峰值学习率。若最早阶段不稳定,优先动预热;若全程震荡,优先降低峰值;若稳定但下降太慢,再尝试提高峰值。进入后半程后,观察衰减是否让损失波动幅度缩小。
学习率计划的判断标准不是曲线“看起来漂亮”,而是训练在有限预算内既能快速下降,又不会因为步幅过大失去稳定性。