
大模型原理与训练 / 系统课时
理解上下文学习为何出现
理解上下文学习为何出现
上下文学习最特别的地方,是模型只看提示中的几个示例,就能临时改变回答方式,却没有修改任何参数。本节从条件预测与模式匹配出发,解释 few-shot 示例究竟改变了什么,以及它为什么不能等同于微调。
学习目标
- 从条件预测角度解释 few-shot 提示为什么能改变模型输出
- 说明上下文学习发生在前向计算中,而不是参数更新中
- 区分上下文学习与微调在信息保存方式和持续时间上的差异
提示本身就是条件
自回归语言模型始终在计算下一个 token 的条件概率。把提示记为上下文 ,已经生成的内容记为 ,模型要估计的是 。因此,只要提示发生变化,后续 token 的概率分布就会变化,这并不要求模型参数发生变化。
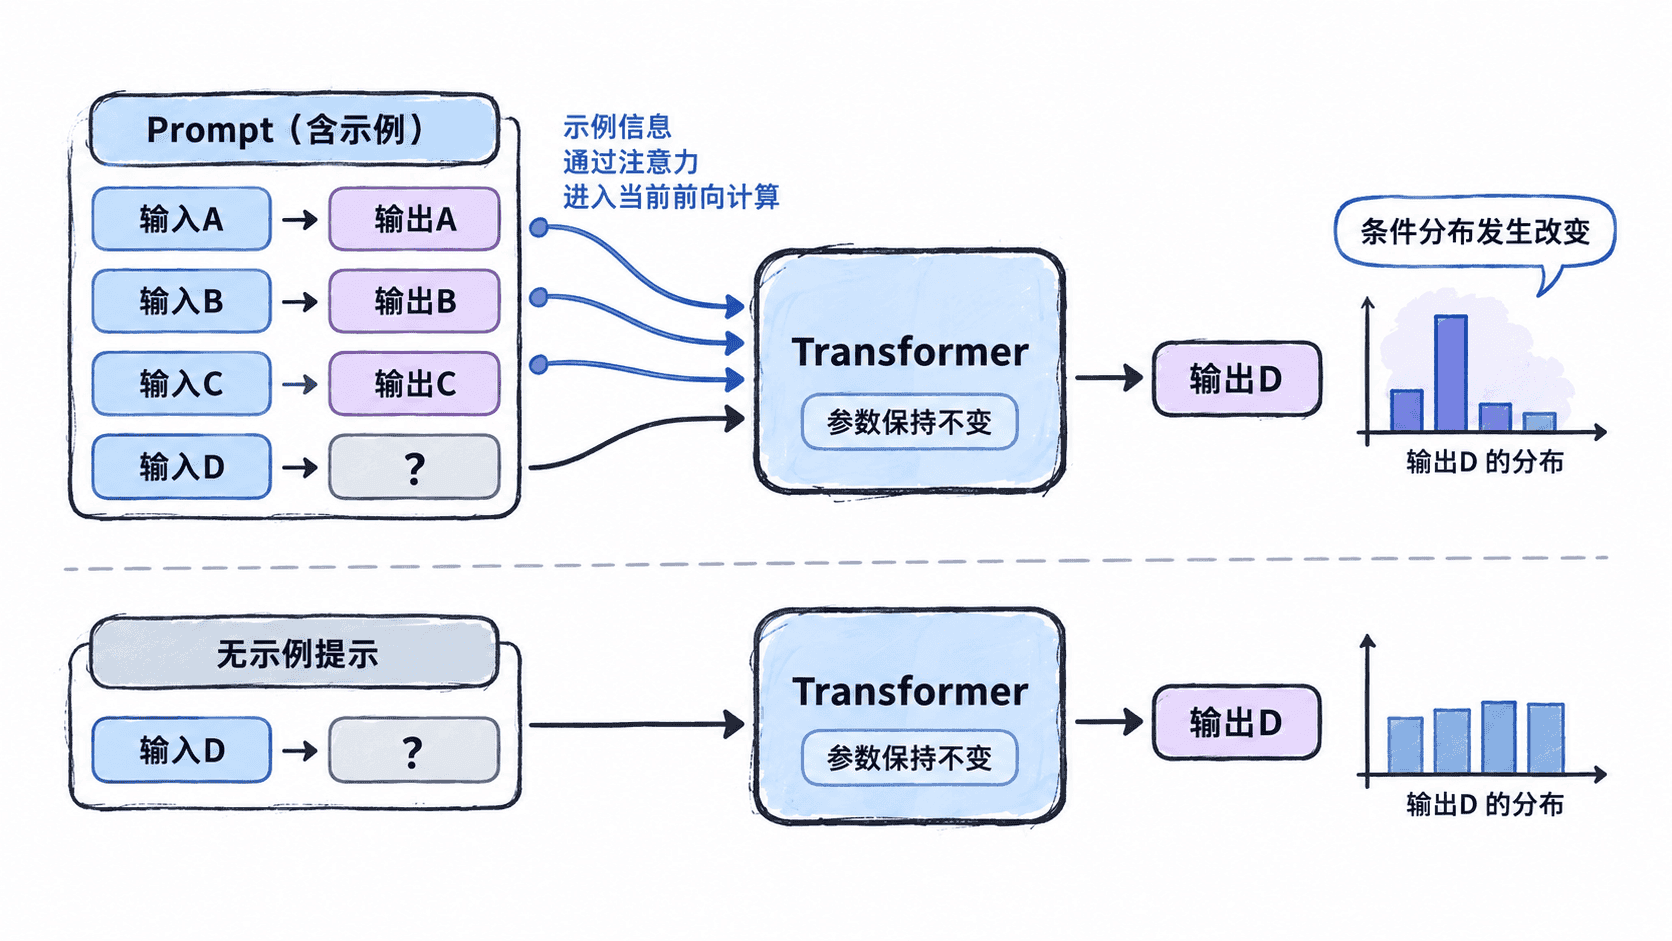
例如,提示中连续出现“英文短语 → 中文翻译”的对应关系后,再给出一个新的英文短语。对模型而言,前面的示例不仅提供了词义信息,还暴露了输入格式、输出格式和任务关系。生成下一个 token 时,这些都已经属于条件 的一部分。
模型在上下文中寻找可继续的模式
规模较大的 Transformer 在预训练阶段见过大量具有内部规律的文本:问答、翻译、分类标签、代码补全、表格映射以及各种“先给例子再继续”的序列。训练目标虽然只是预测下一个 token,但为了降低预测误差,模型会学习利用前文推断当前序列中正在重复的关系。
few-shot 提示正好利用了这种能力。几个示例共同给出了一种局部模式,模型可以通过注意力读取示例中的输入、输出及其对应关系,再把这种关系用于新的输入。这个过程更接近“根据当前上下文推断一个临时任务”,而不是在模型内部永久写入了一套新规则。
上下文学习也不意味着模型真的执行了一个明确、独立的传统学习算法。更稳妥的理解是:随着模型规模、数据和训练充分程度增加,网络内部形成了能利用示例结构进行条件预测的计算模式,于是某些任务表现出类似临时学习的行为。
参数不变,内部状态仍然会变
一次生成期间,模型权重保持固定,但各层激活值以及注意力使用的 K/V 表示会随着提示内容变化。示例因此可以影响后续位置读取哪些信息、哪些模式获得更高权重,以及最终 logits 的分布。
可以把参数理解为模型长期获得的能力,把上下文理解为本次调用临时提供的任务说明和工作记忆。前者决定模型“有可能会什么”,后者决定这一次“应该按什么模式回答”。当上下文窗口被清空后,这些示例带来的影响通常也随之消失。
与微调的边界
上下文学习和微调都能让输出更符合特定任务,但改变的位置完全不同。
| 对比项 | 上下文学习 | 微调 |
|---|---|---|
| 信息来源 | 当前提示中的指令与示例 | 训练数据集 |
| 是否更新参数 | 否 | 是,或更新 LoRA 等可训练参数 |
| 生效范围 | 当前上下文 | 后续推理持续生效 |
| 切换任务 | 更换提示即可 | 通常需要另一组参数或适配器 |
| 主要成本 | 占用上下文长度和推理计算 | 需要训练计算与模型管理 |
因此,需要快速切换任务、只有少量示例或不方便训练时,可以优先使用 few-shot 提示;如果希望行为长期稳定、减少反复携带示例,或者需要系统性改变模型行为,微调通常更合适。
上下文学习的关键并不是模型在推理时偷偷执行了一次参数训练,而是 Transformer 能把示例纳入当前条件,通过注意力和内部激活重新组织预测。few-shot 改变的是本次计算所处的上下文,微调改变的则是未来每次计算都会使用的参数。