
大模型原理与训练 / 系统课时
理解 RMSNorm 的简化作用
理解 RMSNorm 的简化作用
LayerNorm 通过“减均值再按方差缩放”控制隐藏状态分布,而 RMSNorm 只保留按均方根缩放。理解这一步删掉了什么、又保留了什么,就能看清它为何仍能帮助深层 Transformer 稳定训练。
学习目标
- 写出 LayerNorm 与 RMSNorm 的核心计算,并指出两者差异
- 解释 RMSNorm 为什么仍能抑制激活尺度漂移
- 判断 RMSNorm 的优势、代价与容易误解的边界
从 LayerNorm 的两步归一化开始
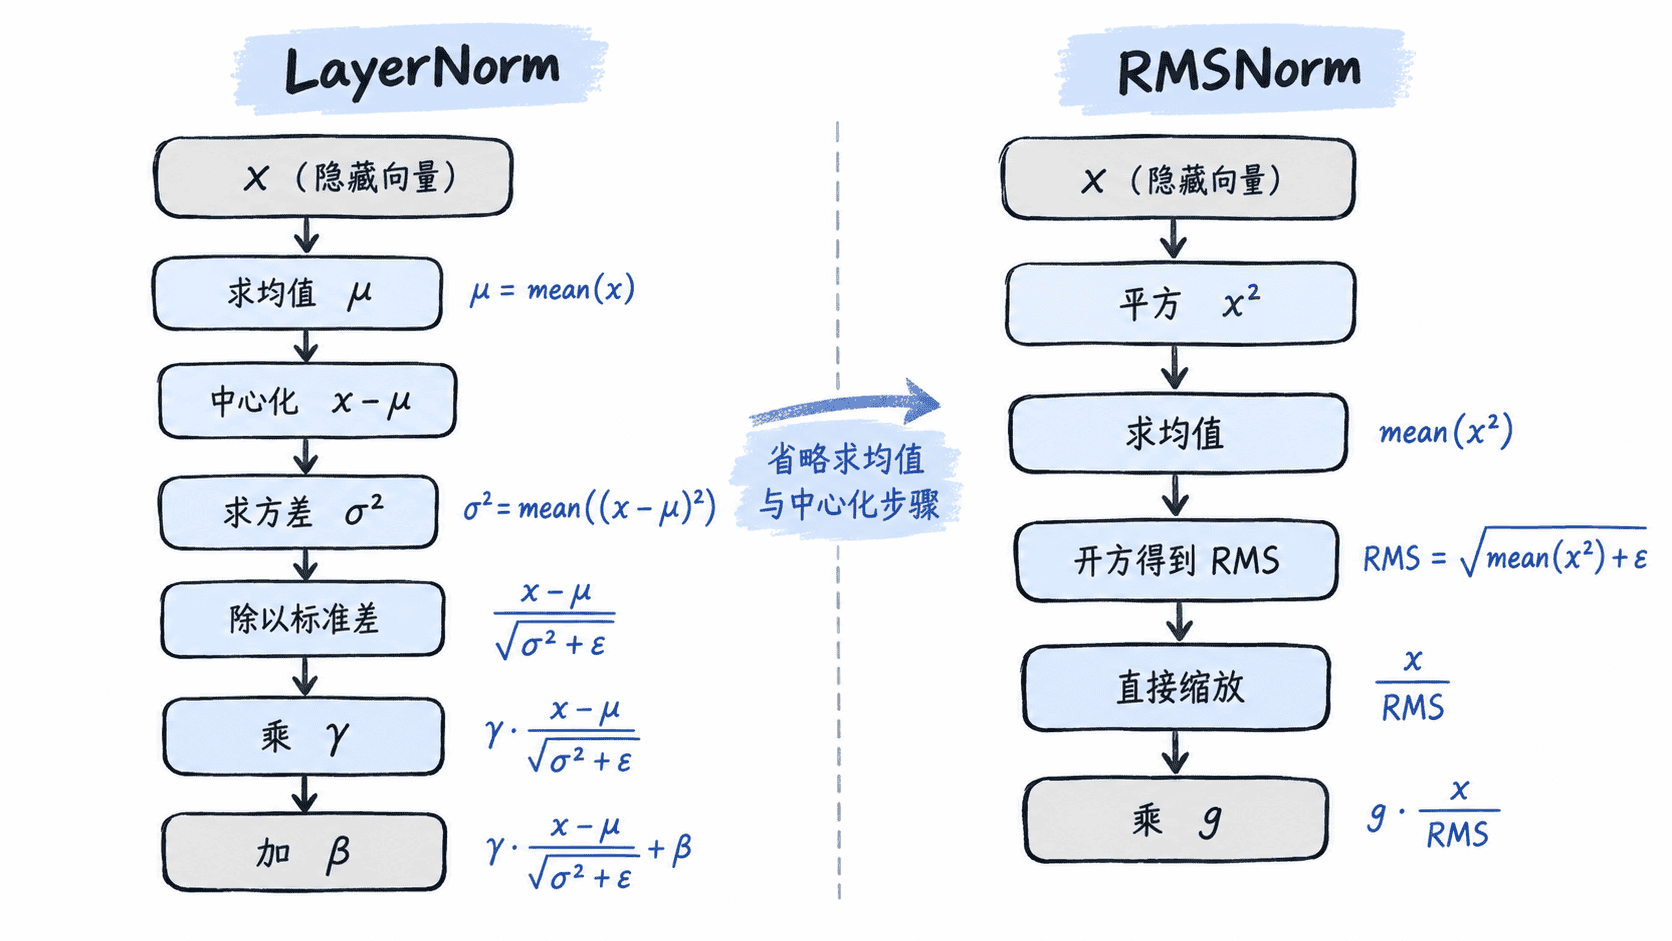
设一个 token 的隐藏向量为 。LayerNorm 先计算特征维上的均值与方差:
随后把每个分量中心化并缩放:
因此 LayerNorm 同时处理两件事:消除整体偏移,以及约束整体尺度。如果隐藏向量整体加上同一个常数,中心化会消除这部分偏移;如果整体幅值变大,除以标准差又会把尺度拉回稳定范围。
RMSNorm 删掉了均值中心化
RMSNorm 不计算均值,也不执行 。它直接用均方根衡量向量尺度:
然后执行:
其中 是可学习缩放参数。很多实现没有与 LayerNorm 中 对应的偏置项,因此数据路径更短:统计平方和、求均方根、缩放,再乘可学习权重。
为什么不减均值仍能稳定训练
深层网络中的一个关键风险是残差流数值幅值持续放大或缩小。RMSNorm 虽然不保证输出零均值,却会约束向量的均方根;若输入整体放大为 ,分母也近似变成 ,因此归一化结果不会随着输入幅值同比放大。
这意味着 RMSNorm 保留了对优化很重要的尺度控制。在采用 Pre-Norm 的 Transformer 中,隐藏状态进入注意力层或前馈层前先被归一化,稳定的输入幅值能够减轻深层堆叠中的数值漂移,并让各层接收到更一致的尺度。
简化带来的实际取舍
两种归一化可以抓住三个核心差异:
| 维度 | LayerNorm | RMSNorm |
|---|---|---|
| 统计量 | 均值与方差 | 均方根 |
| 均值中心化 | 有 | 无 |
| 主要控制对象 | 偏移与尺度 | 尺度 |
RMSNorm 少了一组均值相关计算和数据依赖,计算路径更简洁,也便于实现高效融合内核。但现代加速器上的真实收益还取决于张量尺寸、内核融合和内存带宽,不能仅根据公式少几步就推断固定比例的速度提升。
理解 RMSNorm 的关键不是“删掉了 LayerNorm 的一半”,而是它保留了最关键的幅值约束,同时放弃显式均值中心化。只要模型能够适应这一差异,就可以用更简洁的归一化机制维持深层网络所需的尺度稳定性。