
大模型原理与训练 / 系统课时
用 Scaling Law 判断扩展收益
用 Scaling Law 判断扩展收益
Scaling Law 的价值不是告诉你“模型越大越好”,而是估计继续增加参数、数据或训练算力还能换来多少损失下降。掌握这种幂律视角后,可以把扩展决策从经验拍脑袋变成可比较的收益判断。
学习目标
- 理解参数量、数据量与训练算力和验证损失之间常见的幂律关系。
- 区分“单独放大模型”与“按资源比例扩展”的差别。
- 用小规模实验判断下一单位预算应该优先投入模型、数据还是训练步数。
Scaling Law 真正在回答什么
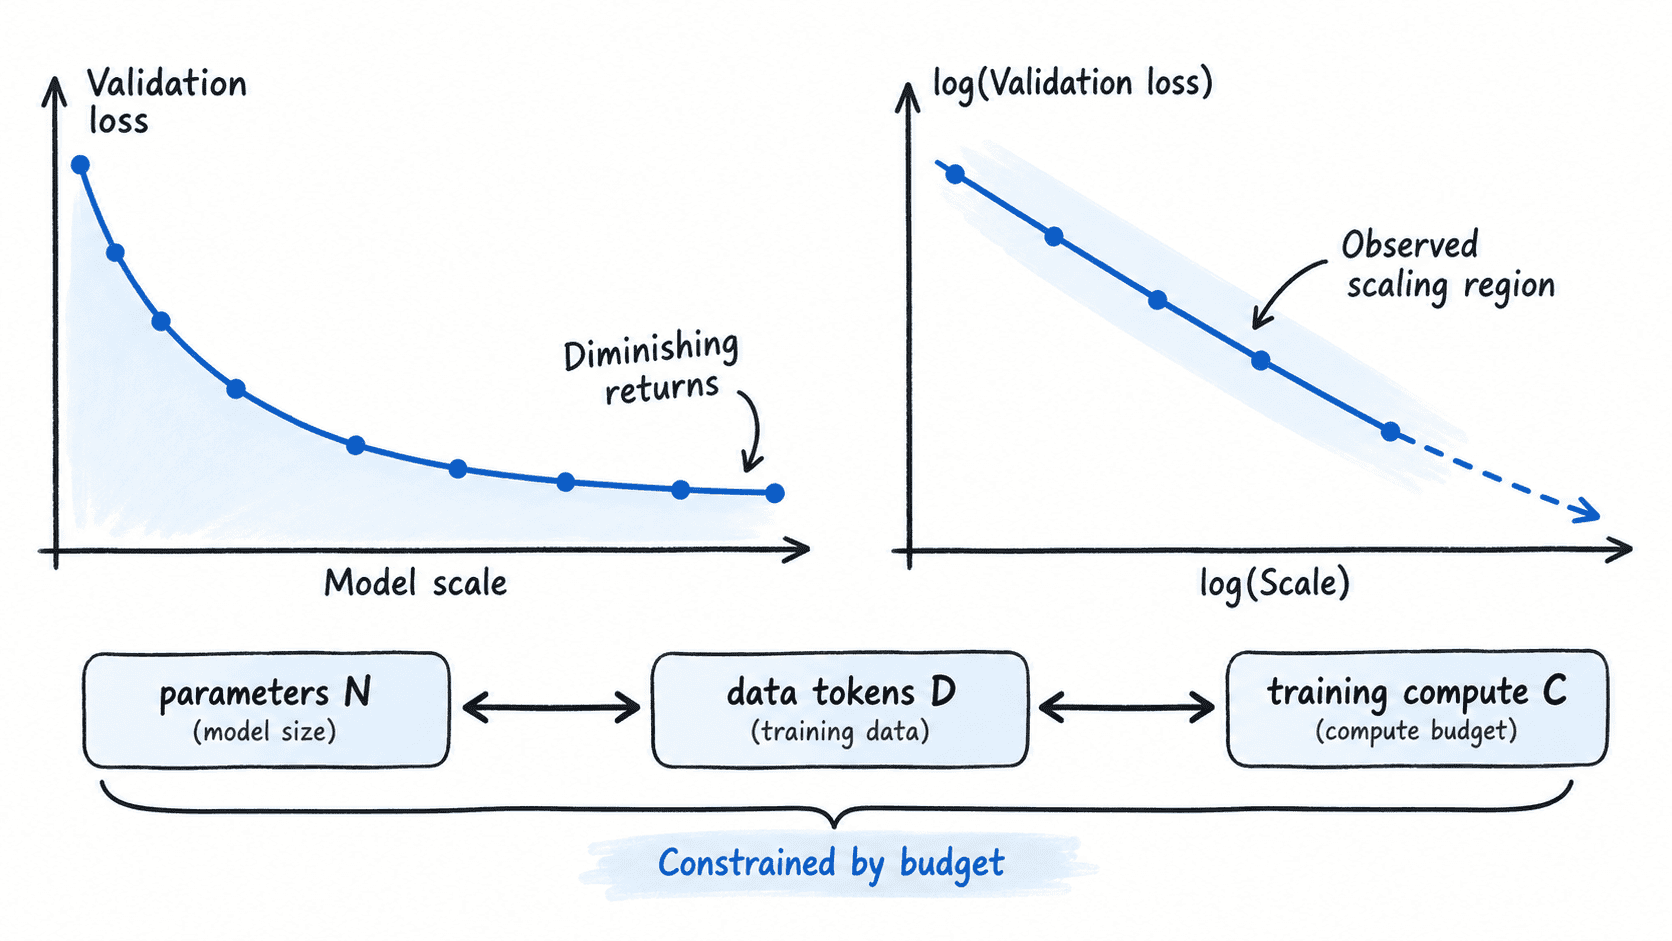
在一段有效的规模区间内,语言模型的验证损失经常可以用幂律近似描述。例如只看参数量时,可以写成:
其中 是参数量, 表示在当前数据分布和建模假设下难以继续突破的损失下界, 和 由实验拟合得到。关键不是记住某个固定指数,而是理解 时,规模继续增大仍有收益,但单位扩展带来的改善会越来越小。
类似地,数据量 或训练算力 也常呈现幂律趋势。对密集型 Transformer,可以用 粗略理解算力与参数量、训练 token 数之间的关系,其中常数 取决于具体实现和训练过程。
为什么只把模型做大可能浪费预算
扩大参数量会提高模型容量,但如果数据量和训练步数没有同步增加,大模型可能处于训练不足状态:参数很多,却没有见到足够多的数据和优化步骤,预算被用在了没有充分训练的容量上。
反过来,如果模型很小却持续喂入远超其容量所需的数据,也可能出现另一种低效:大量算力继续训练一个已经接近自身容量上限的模型,损失下降变得很慢。
因此,扩展问题不是“最大模型能不能训练”,而是“在固定预算下,参数、数据和步数怎样组合,才能让最终验证损失最低”。Scaling Law 提供的就是这种资源分配视角。
用边际收益而不是绝对规模做决策
实际项目里可以先训练一组较小模型,记录每次实验的参数量、训练 token、训练算力和最终验证损失。把规模与损失放到对数坐标中,如果多个点近似落在稳定趋势上,就可以拟合当前任务自己的经验曲线。
判断是否值得扩展时,重点比较边际收益:预算翻倍后,验证损失下降多少;如果同样的预算改为增加高质量数据,下降是否更多;若模型已经明显训练不足,继续扩大参数量通常不是最优选择。
可以把决策压缩成三类信号:
| 观测信号 | 更可能的瓶颈 | 下一步优先动作 |
|---|---|---|
| 模型增大后收益明显,但训练仍充分 | 容量不足 | 继续增加参数量,并同步检查数据与算力 |
| 更长训练或更多数据带来明显收益 | 数据或训练不足 | 先增加有效 token 或训练步数 |
| 参数、数据、算力同时增加后收益仍很小 | 接近当前可用数据与架构的收益边界 | 改善数据分布、目标函数或架构,而不是机械放大 |
计算最优的核心直觉
固定算力预算时,参数量和数据量存在此消彼长的关系。更大的模型意味着每个 token 的计算成本更高,于是同样预算下能训练的 token 变少;更小的模型则可以看更多数据,但容量可能不足。
所谓计算最优,不是一个永远固定的模型大小,而是在给定训练预算、数据可得性和实现效率下,寻找使验证损失最低的参数与 token 组合。随着训练系统、数据质量和模型结构变化,最优比例也会变化,因此不能把某篇论文里的比例直接当成通用常数。
知道 Scaling Law 什么时候会失效
Scaling Law 是经验规律,不是保证外推正确的物理定律。模型进入新的架构区间、数据分布发生改变、训练目标改变,或者优化器与正则化策略发生显著变化时,原来的拟合曲线都可能失效。
小规模实验也必须处于与目标训练相似的设置中。如果小模型使用不同 tokenizer、不同数据混合或完全不同的训练策略,再漂亮的幂律拟合也可能无法指导大模型。
当扩展决策回到边际收益上,你就能明确回答三个问题:预算翻倍是否值得、下一笔预算该投向哪里,以及当前曲线已经接近收益变平时,是否应该把精力转向数据质量或结构改进。