
大模型原理与训练 / 系统课时
从概率分布理解语言模型
从概率分布理解语言模型
语言模型不是先写好一句话再选择答案,而是根据已经看到的词元计算下一位置的概率分布,再重复这一过程生成序列。理解这个循环,就能把“生成文字”还原成可分析的概率预测问题。
学习目标
- 区分生成式语言模型与固定标签分类模型
- 理解自回归语言模型学习的条件概率与序列概率
- 解释贪心选择、随机采样为什么会得到不同文本
从“分类标签”切换到“下一个词元”
分类模型通常计算 :给定输入 ,在预先定义的一组标签中判断哪个 更可能。例如情感分类的输出空间可能只有“正向”和“负向”。
自回归语言模型的输出空间则是整个词表。给定上下文 ,模型为第 个位置计算 。这里的候选不是整句话,而是一个个词元(token);选出一个词元后,它会被追加到上下文,再预测下一个位置。
同一个机制连续执行时,完整序列的概率可以写成:
这意味着训练长文本时,不需要为每种句子准备一个类别标签。模型只要反复学习“看到前文后,下一个真实词元应该有多大概率”。
一次预测到底输出什么
假设上下文是“机器学习正在改变”,词表中部分候选的概率如下:
| 候选词元 | 概率 |
|---|---|
| 世界 | 0.42 |
| 软件 | 0.24 |
| 教育 | 0.18 |
| 其他词元合计 | 0.16 |
这些概率共同构成当前位置的离散概率分布,总和为 1。模型输出的核心不是“世界”这个词本身,而是一组分数经过归一化后得到的概率;解码策略再决定怎样从分布中选出实际词元。
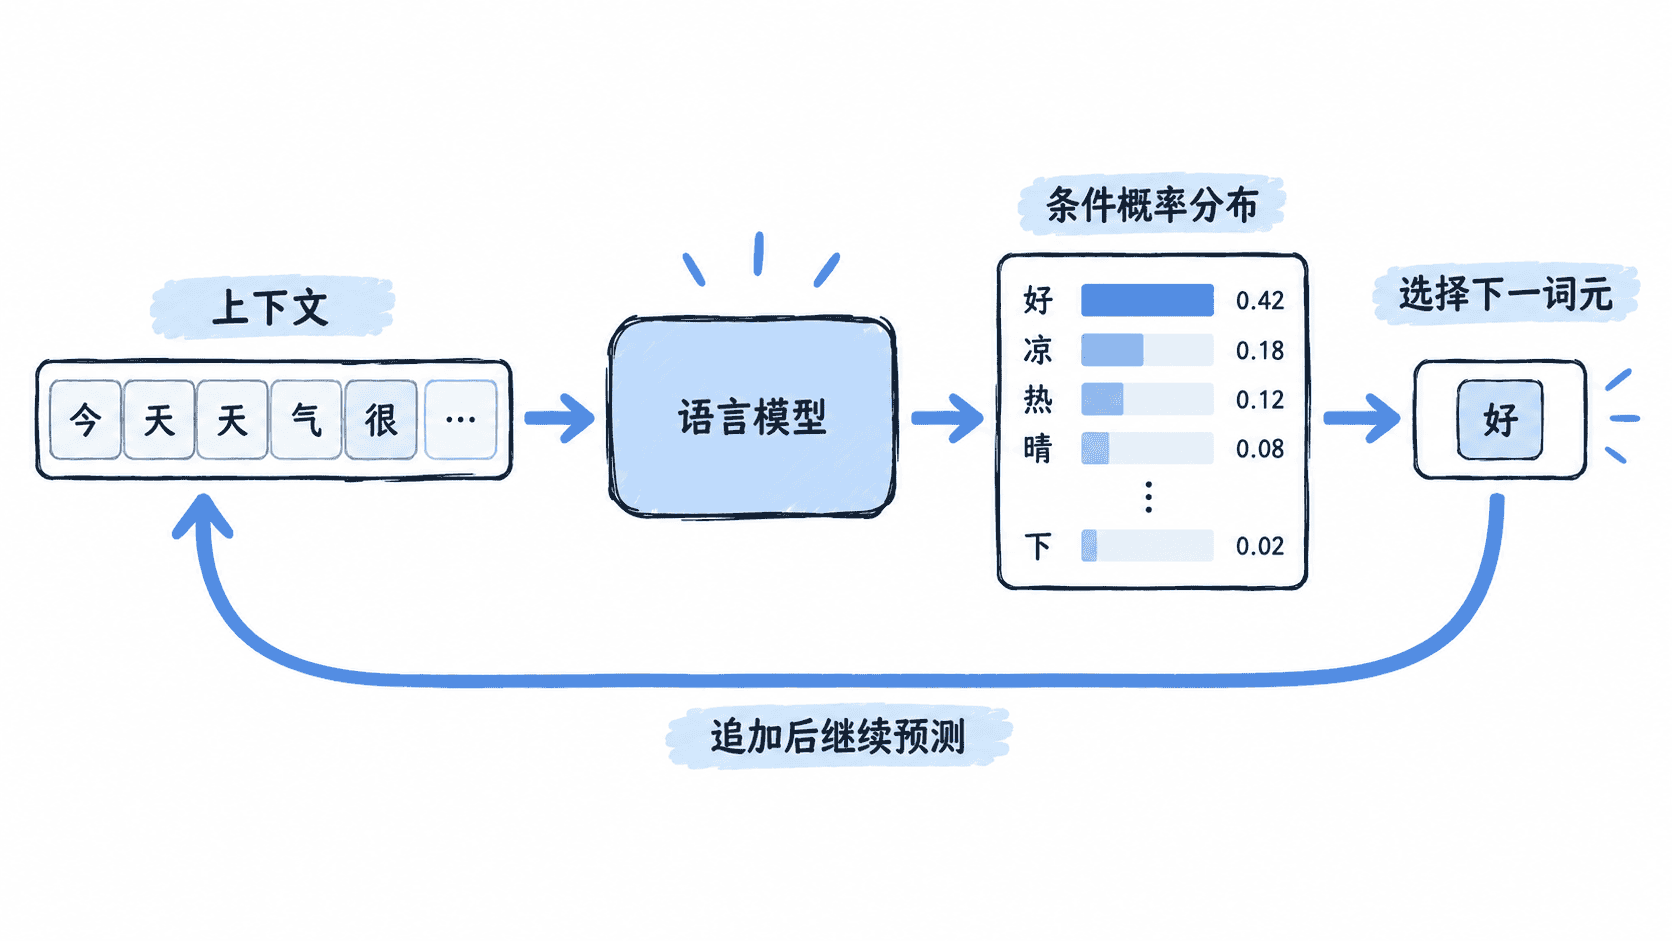
训练时,真实的下一个词元是监督信号。若真实词元是“世界”,优化目标就会推动模型提高“世界”的条件概率,同时降低错误候选的相对概率。大量位置上的这种学习累积起来,模型才逐渐掌握语法、搭配和更长距离的统计规律。
概率最高不等于必须选择
如果每一步都取概率最大的词元,就是常见的贪心解码。它稳定、可复现,但容易让生成结果趋于单一。随机采样则按分布抽取词元,低概率候选仍有机会被选中,因此同一个上下文可以生成不同续写。
例如上表中“世界”概率最高,贪心解码一定选择它;随机采样却可能选到“软件”或“教育”。采样并没有改变模型学到的概率,只是改变了从概率分布到实际词元的选择规则。
用三个问题检查理解
看到一个语言模型输出时,可以依次问:当前上下文是什么、模型对词表给出了怎样的条件概率、解码策略如何从分布中选词。只要这三件事能分开解释,就不会把“模型概率估计”和“最终生成结果”混为一谈。
语言模型的生成能力因此可以归结为一个重复动作:根据已有词元估计下一个词元的条件概率,选择一个词元,再把它放回上下文继续预测。后续的注意力、Transformer 和 GPT 结构,都是在改进“如何根据上下文算出这组概率”。