
大模型原理与训练 / 系统课时
从人类偏好构造排序信号
从人类偏好构造排序信号
同一个提示可以产生多个语法正确却质量不同的回答。要让模型学习“哪个更好”,关键不是为每个回答规定绝对分数,而是把人的相对判断整理成稳定的成对偏好数据,再把这种排序关系转化为奖励建模或直接偏好优化能够使用的监督信号。
学习目标
- 理解
chosen与rejected如何表达相对偏好 - 说明奖励模型如何从成对数据学习排序函数
- 判断偏好数据中的噪声、偏差与歧义会怎样影响后续对齐
偏好数据表达的是相对判断
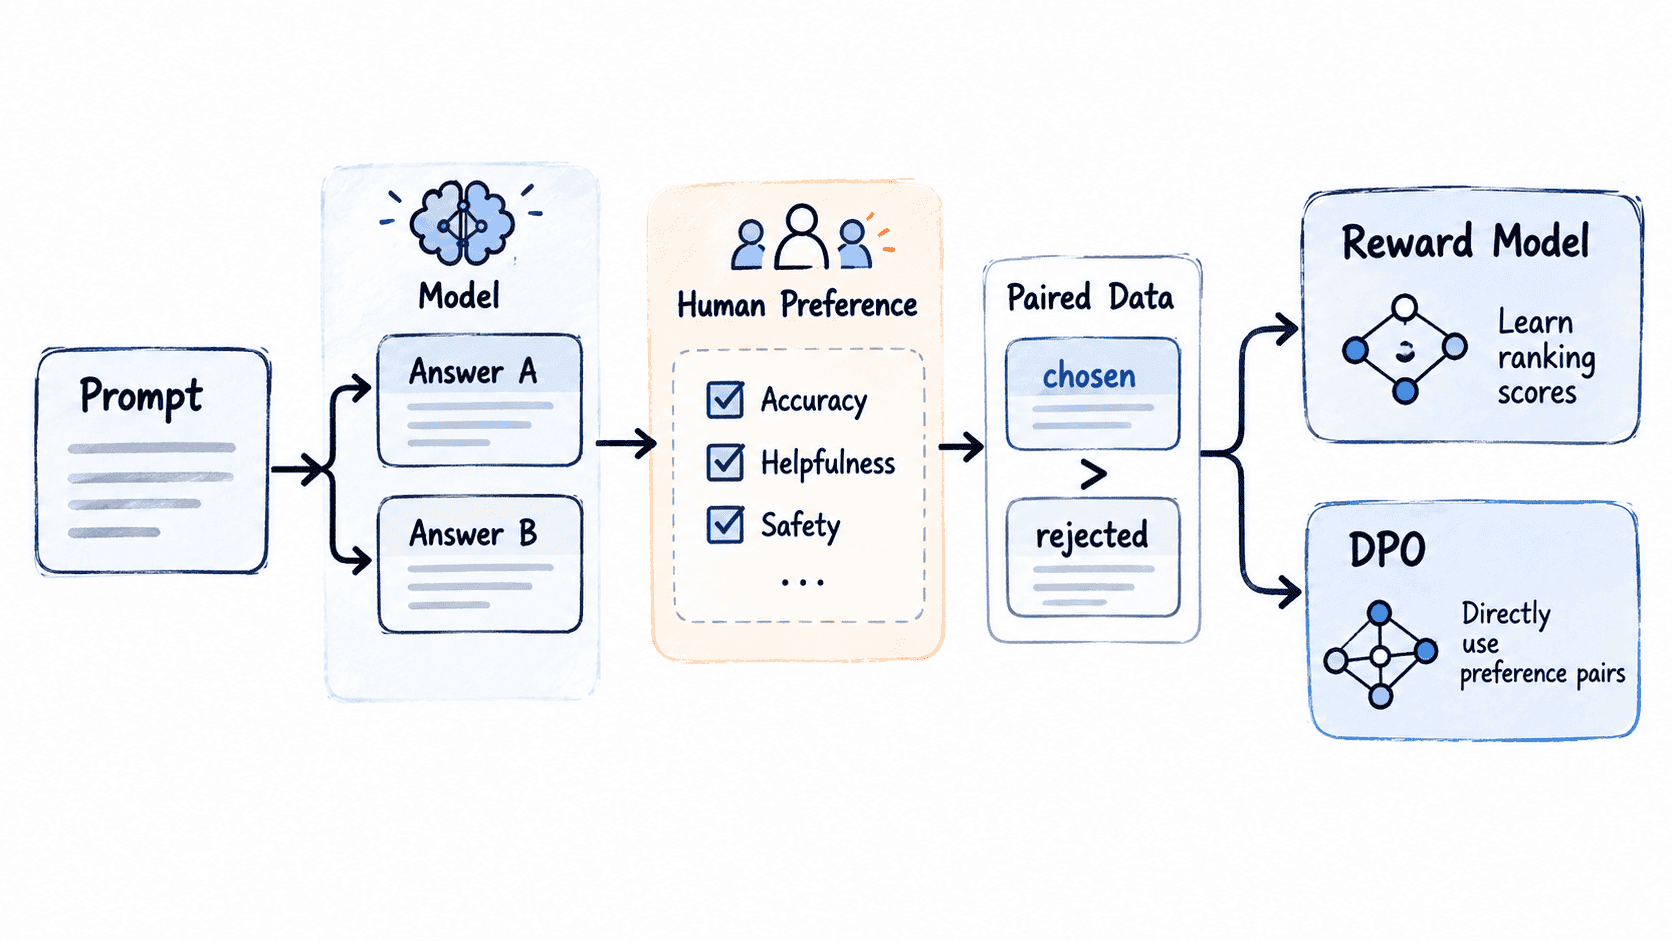
给定提示 ,模型生成两个候选回答 与 。标注者不必回答“这个答案值 8.3 分”,只需要判断哪一个更符合既定标准。被选择的回答通常记为 chosen,另一个记为 rejected。
这种表示方式的重要优势是降低绝对评分尺度带来的差异。不同标注者对“7 分”和“8 分”的理解可能不同,但在两个具体回答之间选择更有帮助、更准确或更安全的一个,通常更容易形成一致信号。
一条最小偏好记录可以表示为:
{
  "prompt": "请解释为什么天空通常呈蓝色。",
  "chosen": "太阳光进入大气后,较短波长的蓝光发生更强的瑞利散射,因此从多数方向进入眼睛的散射光偏蓝。",
  "rejected": "因为天空会反射海洋的蓝色,所以看起来是蓝色。"
}
这里真正被监督的是关系 chosen > rejected。记录本身并没有声明 chosen 是完美答案,也没有规定它应获得多少分;它只说明在当前候选集合和评价准则下,它更值得偏好。
奖励模型把排序关系压成分数
奖励建模会训练一个函数 ,输入提示和回答,输出一个标量。对于一条偏好对,希望满足 。常见做法是让两个分数之差进入 sigmoid,并最小化成对排序损失:
如果 chosen 的得分已经明显高于 rejected,损失会下降;如果顺序相反,模型会收到较大的纠正信号。因此奖励模型学习的首要能力是排序,不是构造一个具有固定物理意义的绝对评分尺度。
这也解释了为什么奖励分数不能简单跨模型、跨数据集直接比较。给所有回答同时加上一个常数,并不会改变成对排序。后续 RLHF 真正依赖的是奖励函数在相关样本上的相对偏好是否可靠。
DPO 可以直接消费同一类偏好对
直接偏好优化不要求先训练一个独立奖励模型。它比较策略模型与参考模型对 chosen、rejected 的相对概率变化,让策略提高受偏好回答的相对优势。
设策略相对参考模型的偏好边际为:
DPO 可以使用类似 的目标直接训练策略。这里仍然没有要求人类提供数值奖励;监督源依旧是同一个二元关系:在给定提示下,更希望模型倾向 chosen 而不是 rejected。
因此,奖励建模和 DPO 的分叉点发生在怎样消费偏好数据,而不是偏好数据本身必须采用完全不同的采集方式。
偏好信号的上限由标注质量决定
成对判断看似简单,但如果评价标准不稳定,训练信号同样会失真。一个回答可能更详细,另一个更简洁;一个事实更准确,另一个表达更友好。没有明确准则时,不同标注者可能实际上在优化不同目标。
高质量数据通常需要明确“比较什么”,并对难以区分的样本保留平局、跳过或重新标注机制。还要注意候选位置偏差、篇幅偏好以及模型风格暴露等因素,否则模型可能学到“更长就是更好”之类的代理特征。
当偏好对能够稳定表达“面对同一个提示,更希望哪一种行为”时,它就形成了连接人类判断与模型优化的核心桥梁:奖励模型可以把关系学习成排序分数,DPO 等方法则可以绕过显式奖励分数,直接用同样的排序关系推动策略变化。