
大模型原理与训练 / 系统课时
用批处理提升吞吐的代价
用批处理提升吞吐的代价
推理服务器把多个请求放在一起计算,可以让 GPU 一次处理更多 Token,减少硬件空闲并提升总体吞吐。但批越大并不代表每个用户都更快:为了凑批、等待其他序列或共享有限显存,请求可能增加排队时间。本节用静态批、动态批和连续批处理拆解这种吞吐与延迟之间的交换。
学习目标
- 理解静态批、动态批和连续批处理分别如何组织推理请求
- 解释批处理为什么能提高 GPU 利用率和总体吞吐
- 能区分吞吐、排队时间、首 Token 延迟和单请求完成时间之间的取舍
批处理是在共享一次计算机会
如果服务器一次只处理一个很短的请求,GPU 上大量计算单元可能没有被充分利用。把多个请求的 Token 拼成一个批次后,矩阵乘法的规模变大,GPU 可以并行执行更多工作,固定的调度、Kernel 启动和数据搬运成本也能被更多 Token 分摊。
因此批处理优化的主要目标通常是单位时间完成更多工作,而不是保证任意一个请求立即完成。可以把吞吐简单理解为单位时间处理或生成的 Token 数,而用户感受到的延迟还包含排队、预填充、逐 Token 解码以及等待调度的时间。
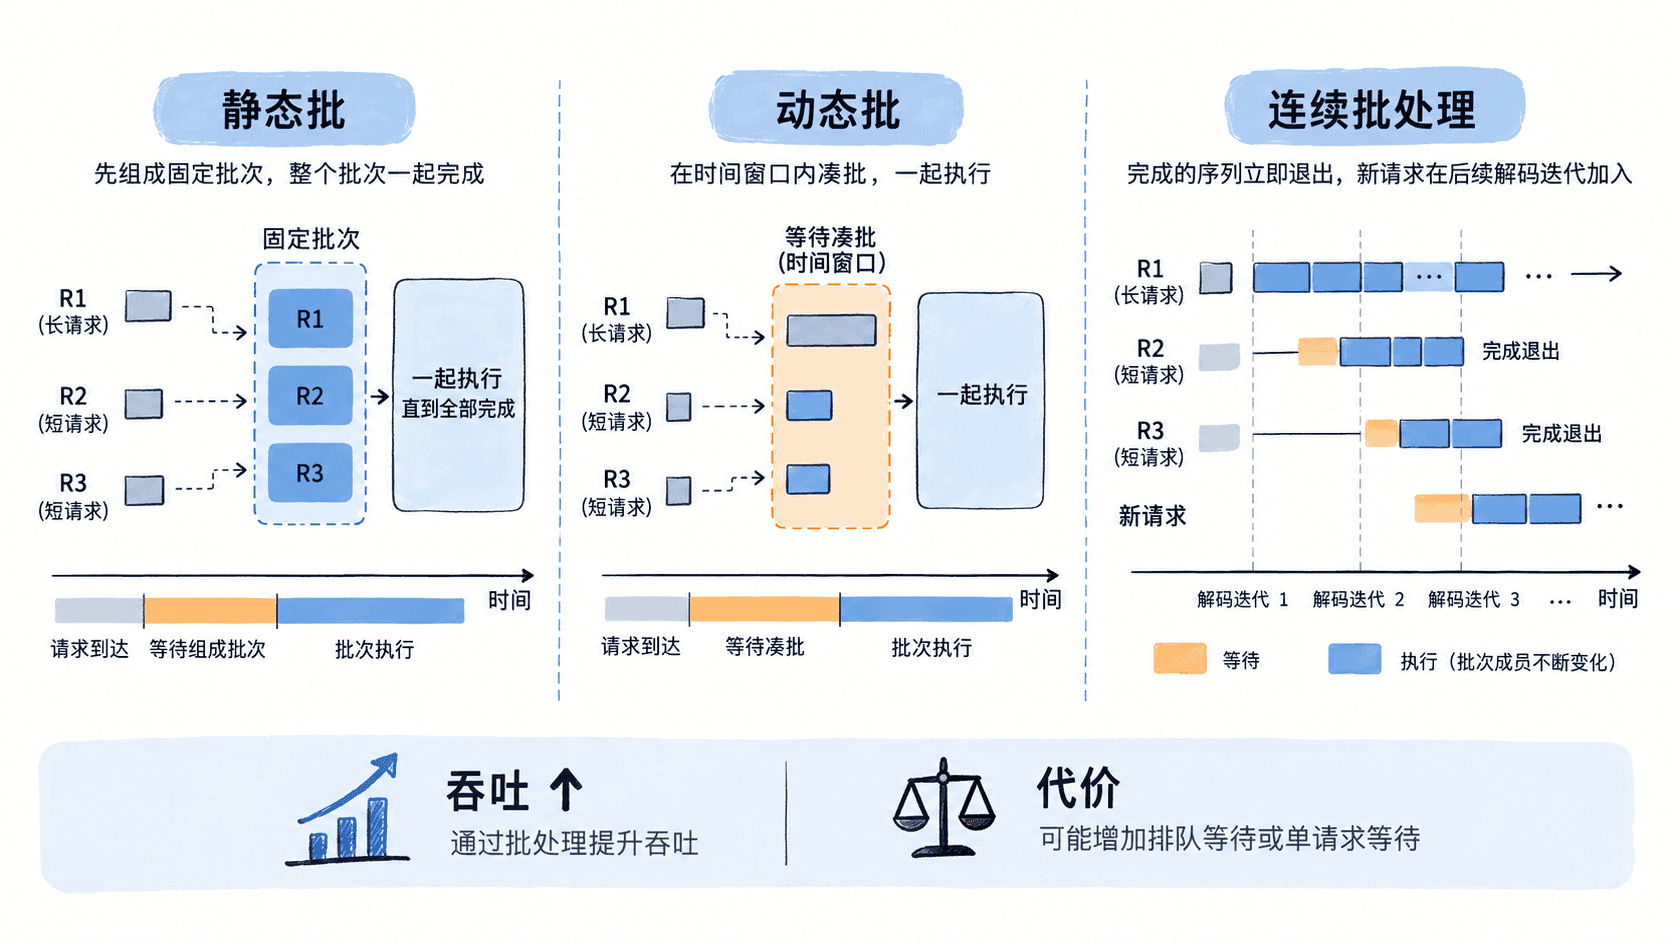
静态批要求一组请求一起走
静态批处理先确定一个批次,再把其中请求作为整体执行。离线评测或输入尺寸比较规则的任务很适合这种方式,因为数据天然可以预先分组,调度逻辑也很简单。
在线生成服务中,它的问题更明显。不同请求的 Prompt 长度和生成长度通常不同。如果批次内一个请求只生成 20 个 Token,另一个需要生成 500 个 Token,那么较短序列即使早已结束,批次中对应计算槽位也可能难以立即让给新请求。这种现象会降低有效利用率,并形成“短任务被长任务拖住”的尾部延迟。
固定使用很大的静态批还会放大显存需求,因为模型必须同时容纳更多请求的激活和 KV Cache。因此实际能使用多大批次,通常先受显存容量和请求长度约束,而不是只由 GPU 算力决定。
动态批用短暂等待换更高吞吐
动态批处理不要求请求事先成组。服务器收到请求后,会在一个很短的时间窗口内收集多个请求,再将它们合并执行。低流量时可能直接发出小批,高流量时则更容易形成大批次。
这种方式比固定批次更适合在线服务,但代价非常直接:第一个到达的请求可能已经准备好执行,却仍需要等待几毫秒,让后续请求加入批次。等待窗口越长,越容易凑出高效的大批;窗口越短,请求启动越及时,但硬件利用率可能下降。
因此动态批处理不是“免费提速”,而是在等待时间和吞吐之间选择一个服务目标。交互式聊天通常更敏感于首 Token 延迟,而批量摘要、离线生成等任务往往更愿意接受等待,以换取更高的整体处理效率。
连续批让批次成员不断变化
大语言模型生成具有迭代特征:每轮通常只为活跃序列生成一个或少量新 Token。连续批处理利用这一点,不再要求一整个批次从开始到结束保持不变,而是在每轮调度时重新组合活跃序列。
某个请求结束后,它占用的槽位可以很快释放;新的请求无需等待当前所有长请求结束,就能在后续迭代进入执行集合。这样可以减少静态批中的空槽,让 GPU 在混合长短请求时保持更高利用率。
连续批处理也更复杂。调度器需要管理每个序列当前的位置、KV Cache、显存块和优先级,还要决定本轮究竟处理哪些预填充 Token、哪些解码 Token。如果为了追求总体吞吐持续塞入大量工作,单个已经在服务中的请求也可能获得更少的调度机会,从而增加 Token 间等待时间。
三种方式解决的是不同调度问题
| 方式 | 批次如何形成 | 主要优势 | 典型代价 |
|---|---|---|---|
| 静态批 | 执行前固定成员 | 实现简单,适合规则的离线任务 | 长短请求互相拖累,槽位难以及时复用 |
| 动态批 | 在短时间窗口收集请求 | 在线流量下容易提高批量和 GPU 利用率 | 请求需要等待凑批,首 Token 延迟可能上升 |
| 连续批 | 每轮生成后重新安排活跃序列 | 长短请求混合时利用率高,完成槽位可快速复用 | 调度与 KV Cache 管理复杂,拥塞时仍会增加等待 |
实际系统经常同时使用多种思想。例如先用动态策略把新到请求聚合,再通过连续批处理管理长期生成过程。名称本身不是重点,关键是看调度器什么时候允许新请求加入、什么时候释放完成请求,以及一次迭代中允许多少 Token 参与计算。
吞吐更高不等于单请求更快
假设单独运行请求 A 时 GPU 只使用了一部分计算资源。加入 B、C、D 后,四个请求可以并行执行,服务器每秒完成的总 Token 数可能明显提高。但 A 不一定更早完成,因为它可能先等待凑批,还可能在后续调度中与其他请求分享算力和显存带宽。
评估批处理时因此至少要区分总体吞吐与用户延迟。吞吐回答“服务器单位时间做了多少工作”;首 Token 延迟回答“用户多久看到第一次响应”;Token 间延迟反映流式输出是否顺畅;端到端延迟则回答整个请求何时真正完成。
批处理的本质是把有限的 GPU 计算、显存与带宽在更多请求之间共享。静态批追求简单整齐,动态批用短暂排队换取更好的批量规模,连续批则让生成中的请求可以不断加入和退出。选择策略时应先确定延迟目标,再在这个约束下提升吞吐,而不是单纯把批次做得越大越好。