
大模型原理与训练 / 系统课时
用位置编码保留顺序信息
用位置编码保留顺序信息
自注意力擅长判断词与词之间的相关性,却不会天然知道谁在前、谁在后。本节从这个缺口出发,解释位置表示为什么必须进入 Transformer,并比较绝对位置编码与相对位置思路各自保存了什么顺序信息。
学习目标
- 解释纯自注意力为什么不能仅凭输入内容可靠地区分词序
- 理解绝对位置表示如何把位置加入 Token 表示
- 区分绝对位置与相对位置方法关注的信息差异
注意力本身没有顺序坐标
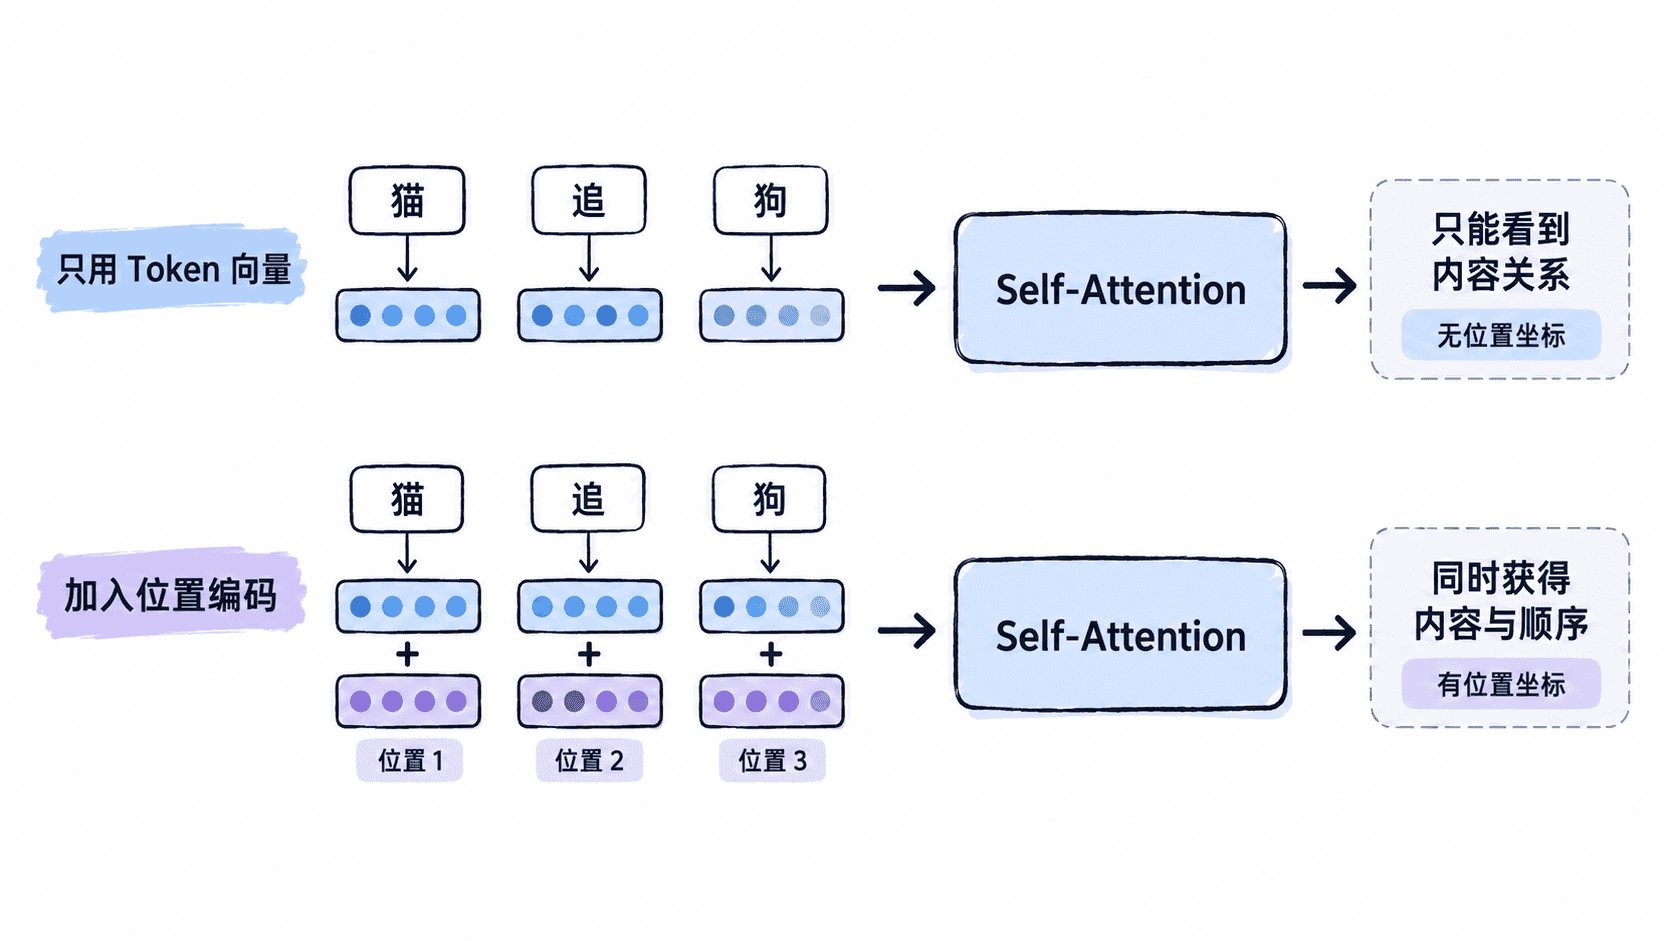
设输入序列经过嵌入后得到向量 。自注意力会由每个向量生成 Query、Key 和 Value,再根据内容相似度决定信息如何聚合。这个计算过程知道“哪些向量彼此相关”,却没有一个天然的变量表示“这是第 1 个词”或“它位于另一个词左边两格”。
如果只是把一组输入向量重新排列,并让对应的 Query、Key、Value 一起按相同方式排列,注意力结果也会跟着排列。换句话说,注意力可以处理集合中的关系,但顺序必须由额外信息注入。
例如“猫追狗”和“狗追猫”含有相同的三个概念,但词序改变后语义完全不同。若模型只看词向量之间的内容关系,就缺少判断主客体顺序的重要依据。
绝对位置表示给每个位置一个身份
最直接的办法,是为序列中的第 个位置构造一个位置向量 ,再与词向量相加:
这样进入注意力层的向量同时包含“这个 Token 是什么”和“它位于哪里”。Transformer 原始论文使用固定的正弦、余弦函数生成不同维度的位置值,其中一部分维度可写成:
不同频率让模型能够从多个尺度感知位置变化。因为这些值由公式直接计算,所以训练时不需要为每个位置学习独立参数,也能为训练长度之外的位置继续计算表示。
另一种常见做法是可学习绝对位置嵌入:建立一个位置向量表,让第 0、1、2……个位置像 Token Embedding 一样通过训练得到参数。它实现简单,但通常需要预先规定可表示的最大位置数量;当推理长度超过训练时覆盖的位置范围时,也不能简单认为模型会自然外推。
相对位置更关心两个 Token 相隔多远
很多语言规律并不只依赖“这是第 137 个 Token”,而更依赖两个 Token 之间的相对关系。例如修饰词通常影响附近词语,某个括号更需要找到与自己相距一定位置的配对符号。
因此,相对位置方法不再只给每个 Token 一个孤立的位置身份,而是让注意力计算能够感知 与 之间的距离或方向。其核心问题从“我在哪个绝对位置”变成了“你相对我在哪里”。
这类设计可以直接修改注意力分数,也可以把位置信息编码进 Query 和 Key。后续大模型中常见的旋转位置编码等方案虽然实现方式不同,但目标相近:让注意力关系本身携带相对位置信息,而不是只依赖输入端的一次位置相加。
两类方法解决的问题并不完全相同
| 位置思路 | 主要表达 | 典型优点 | 主要边界 |
|---|---|---|---|
| 绝对位置 | Token 位于序列中的具体位置 | 直观、实现简单 | 对更长上下文的泛化取决于具体设计 |
| 相对位置 | 两个 Token 的距离和方向 | 更贴近许多语言关系 | 会改变或参与注意力计算,机制更复杂 |
绝对位置和相对位置并不是“旧方法与新方法”的简单替代关系。真正需要记住的是:**自注意力负责内容之间的信息交换,位置机制负责告诉模型这种交换发生在怎样的顺序结构中。**没有位置线索,Transformer 能看见有哪些信息,却无法可靠地区分这些信息以什么顺序出现。