
大模型原理与训练 / 系统课时
解释生成长度为何拖慢推理
解释生成长度为何拖慢推理
同一个模型处理同样的输入,要求生成 50 个词元和 500 个词元时,后者通常会明显更慢。本节从 Prefill 与 Decode 两个阶段拆开延迟,解释自回归生成为什么无法把全部输出一次并行算完,以及输出长度如何继续影响 GPU 占用、KV Cache 和服务成本。
学习目标
- 区分 Prefill 与 Decode,说明两者的计算方式为什么不同
- 解释输出词元数与总生成延迟之间的关系
- 判断长输出为什么会同时增加计算量、显存占用和服务成本
先分清 Prefill 与 Decode
大语言模型收到提示词后,推理通常可以分为 Prefill 和 Decode。Prefill 一次处理已有输入词元,Transformer 可以并行计算这些已知位置,因此 GPU 往往能获得较高的并行度。
进入 Decode 后,情况发生变化。模型先根据当前上下文预测第一个新词元,把这个词元追加到上下文,再预测下一个。后一个词元依赖前一个已经生成的结果,因此单个请求无法提前同时得到全部未来词元。
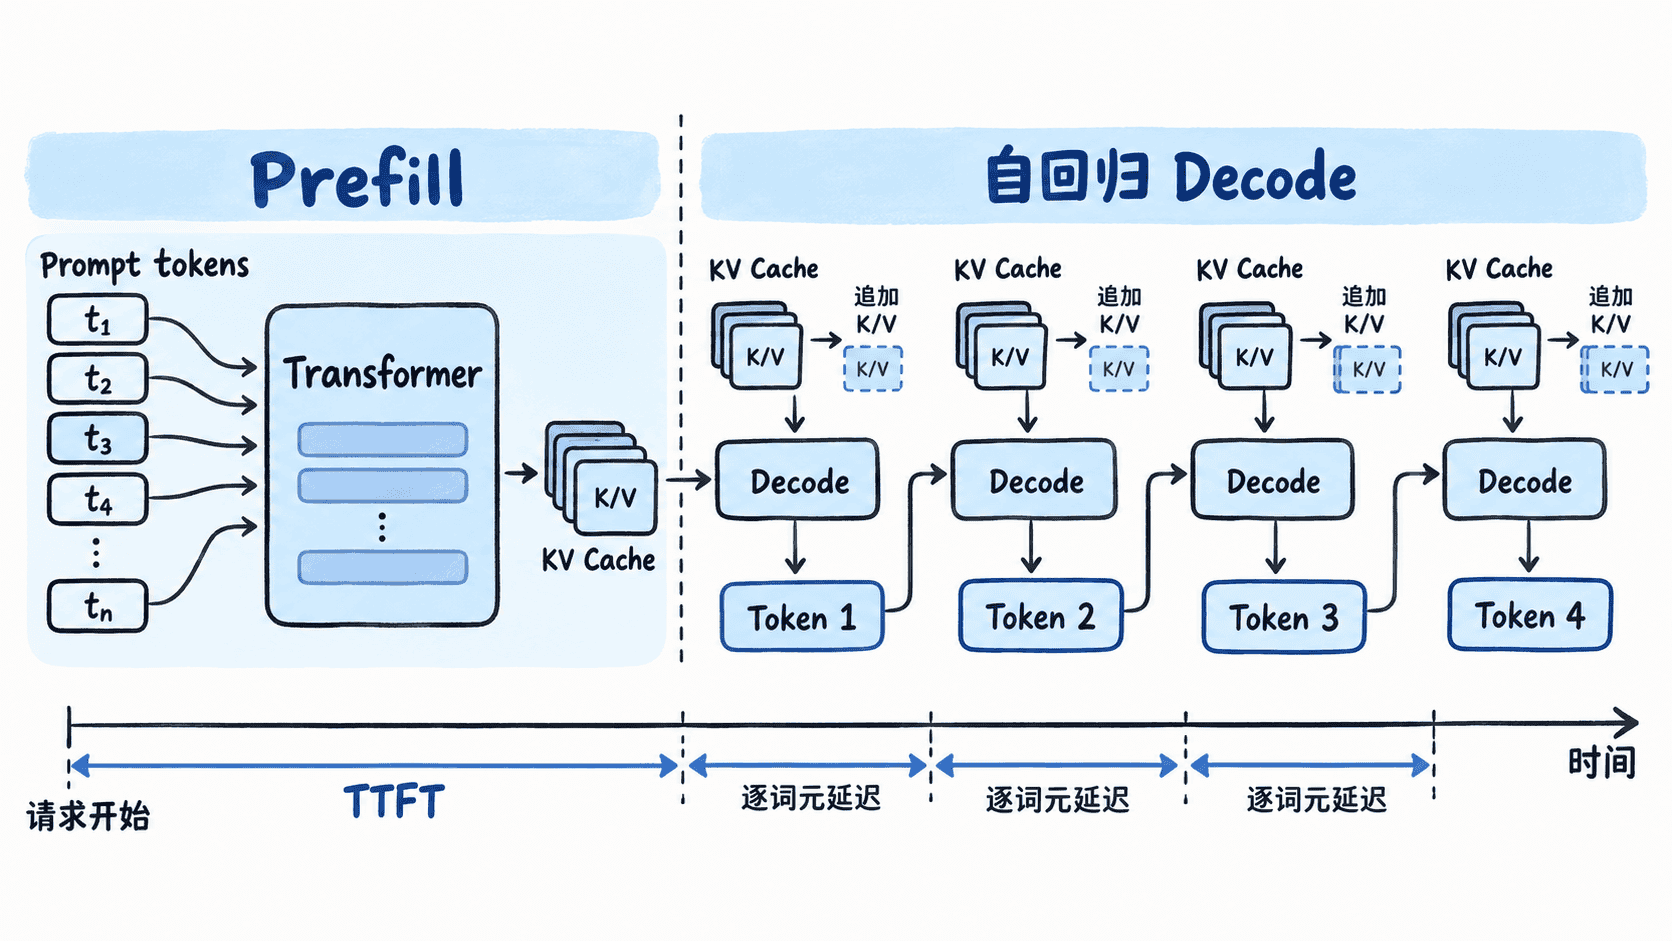
这也是为什么“模型一次前向计算能得到所有位置的 logits”并不等于“生成时可以一次算完整段答案”。训练阶段的目标词元全部已知,可以并行;实际生成时未来词元尚不存在,必须等采样结果出现后才能继续。
输出长度怎样进入总延迟
为了建立直觉,可以把一次请求的总时间近似写成:
其中, 是实际生成的词元数, 表示平均生成一个新词元所需的时间。真实系统中每一步耗时并不完全相同,但这个近似足以说明核心规律:输出越长,需要串行执行的 Decode 步数越多。
例如,在其他条件近似不变时,128 个输出词元相对于 32 个输出词元,大约需要 4 倍的 Decode 步数;512 个输出词元则约为 16 倍。Prefill 成本并没有按这个比例增加,增加的主要是后续连续生成过程。
因此观察延迟时要区分两个指标:首词元延迟主要反映请求排队和 Prefill 等前置成本,而完整响应耗时还会被输出长度持续拉长。一个服务首字出现很快,并不代表长答案也能很快完成。
长输出为什么还会推高成本
Decode 不只是让用户多等待几轮计算。每生成一个词元,模型都需要继续运行 Transformer 层,并读取已有 KV Cache。对 GPU 服务而言,请求在更长时间内保持活跃,会持续占用调度槽位和计算资源。
同时,新的词元还会产生新的 Key 与 Value,并追加到该请求的 KV Cache。输出越长,请求生命周期越长,缓存也继续增长。高并发场景下,大量长输出请求叠加后,可能同时压低可容纳的并发数,并增加其他请求排队等待的机会。
判断该优化哪一部分
如果用户主要抱怨“很久才出现第一个字”,应优先检查排队、输入上下文长度、Prefill 性能和批处理策略,而不能简单归因于输出太长。
如果第一个词元很快出现,但完整答案拖得很久,则应重点查看实际输出词元数和每词元 Decode 延迟。此时减少不必要的输出、设置合理停止条件、提高单步 Decode 效率,通常比单纯优化 Prefill 更直接。
推测解码、量化和更高效的推理内核可以降低每一步的成本,但它们并没有消除自回归生成的因果依赖。判断生成性能时,始终要把“每一步有多快”和“最终需要走多少步”分开看。