
大模型原理与训练 / 系统课时
从 Logits 算出交叉熵损失
从 Logits 算出交叉熵损失
GPT 在每个位置输出的是覆盖整个词表的一组 Logits,而不是直接给出概率。训练时需要把这些未归一化分数转换为概率分布,再取真实词元对应概率的负对数。交叉熵正是把这条计算链压缩成一个可优化的标量损失。
学习目标
- 理解 Logits、Softmax 概率与交叉熵之间的计算关系
- 手算并验证一个位置的负对数似然损失
- 判断高置信度错误、数值稳定性与平均损失的关键边界
从 Logits 得到概率分布
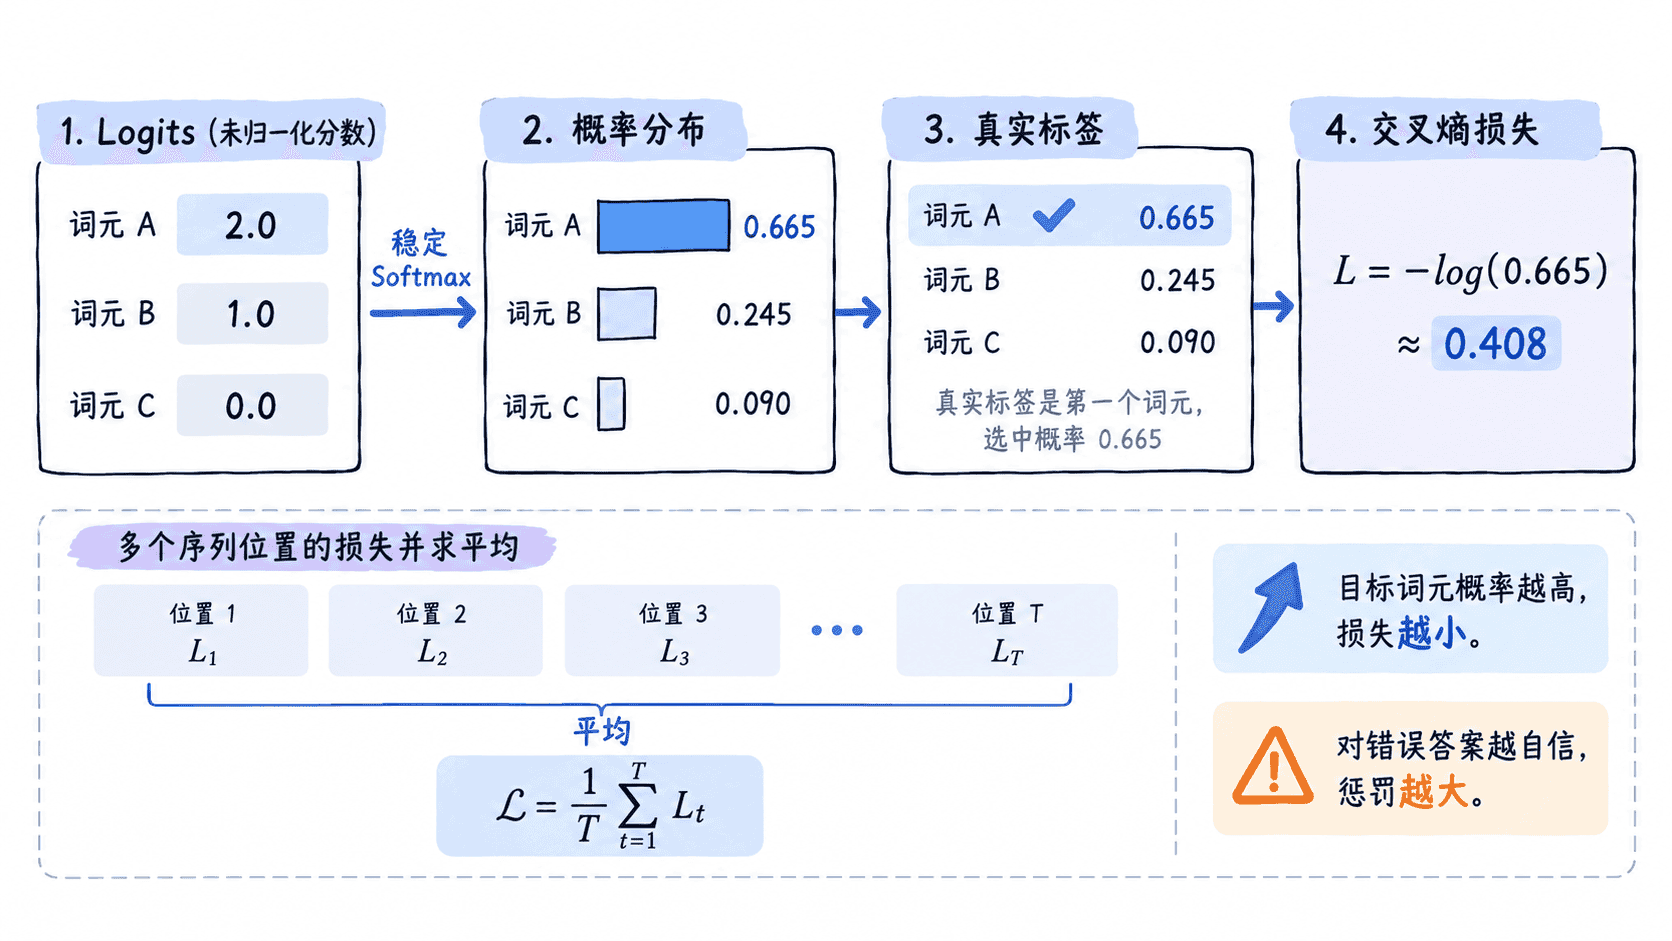
假设某个位置的词表只有三个候选词元,模型输出 Logits 为 。Logits 可以是任意实数,大小只表示相对偏好,三项既不要求非负,也不要求总和为 1。
Softmax 将它们转换成概率。实际计算通常先减去最大 Logit ,避免指数运算溢出:
所有 Logits 同时减去相同常数不会改变 Softmax 的最终概率,因此这一步只改善数值稳定性。
取真实标签的负对数
假设真实标签恰好是索引 0。Softmax 后只需要取目标词元的概率 ,单个位置的负对数似然为:
下面使用 Python 标准库完整计算这一过程:
import math

logits = [2.0, 1.0, 0.0]
target_index = 0

# 先减最大值,避免较大的 Logit 在指数运算时溢出。
maximum = max(logits)
exp_values = [math.exp(value - maximum) for value in logits]
total = sum(exp_values)
probabilities = [value / total for value in exp_values]

loss = -math.log(probabilities[target_index])

print("probs:", " ".join(f"{p:.6f}" for p in probabilities))
print(f"loss: {loss:.6f}")
预期输出
probs: 0.665241 0.244728 0.090031
loss: 0.407606
真实词元得到约 的概率,因此损失约为 。如果目标概率进一步接近 1, 会趋近 0;如果目标概率趋近 0,损失会快速增大。
为什么错误且自信会被重罚
交叉熵并不只关心“最高分选对没有”,还关心模型给真实答案分配了多少概率。真实词元概率从 降到 时,损失明显增加;如果只剩 ,负对数会变得很大。这使梯度能够持续推动模型重新分配概率,而不是只处理离散的对错结果。
对于一段序列,模型在每个有效位置都有一个目标词元。若共有 个参与训练的位置,常见做法是对这些位置的负对数似然取平均:
Padding 或明确忽略的位置不应计入 ,否则不同批次的补齐长度会改变损失含义。
使用交叉熵接口时的边界
深度学习框架中的交叉熵函数通常直接接收 原始 Logits 和目标类别索引,并在内部组合稳定的 log-softmax 与负对数似然计算。因此训练代码通常不需要先手动调用 Softmax。
语言模型训练中的完整对应关系因此很清楚:每个位置产生一组词表 Logits,交叉熵读取该位置真实下一词元的索引,计算其负对数概率,再对所有有效位置汇总。损失下降意味着模型正在把更多概率质量分配给训练数据中真正出现的下一词元。