
大模型原理与训练 / 系统课时
看懂上下文窗口的成本来源
看懂上下文窗口的成本来源
上下文窗口变长并不只是“多存一些文字”。输入越长,模型在预填充阶段要处理更多 Token,推理过程中还要保存并持续读取更大的 KV Cache。本节从注意力计算、临时激活与缓存三个角度拆开成本,建立判断长上下文显存与延迟瓶颈的基本方法。
学习目标
- 区分长上下文对预填充计算量和逐 Token 解码延迟的不同影响
- 理解激活张量与 KV Cache 为什么会随序列长度增加显存压力
- 能判断一个长上下文请求更可能受计算、显存容量还是内存带宽限制
长上下文同时拉高三类成本
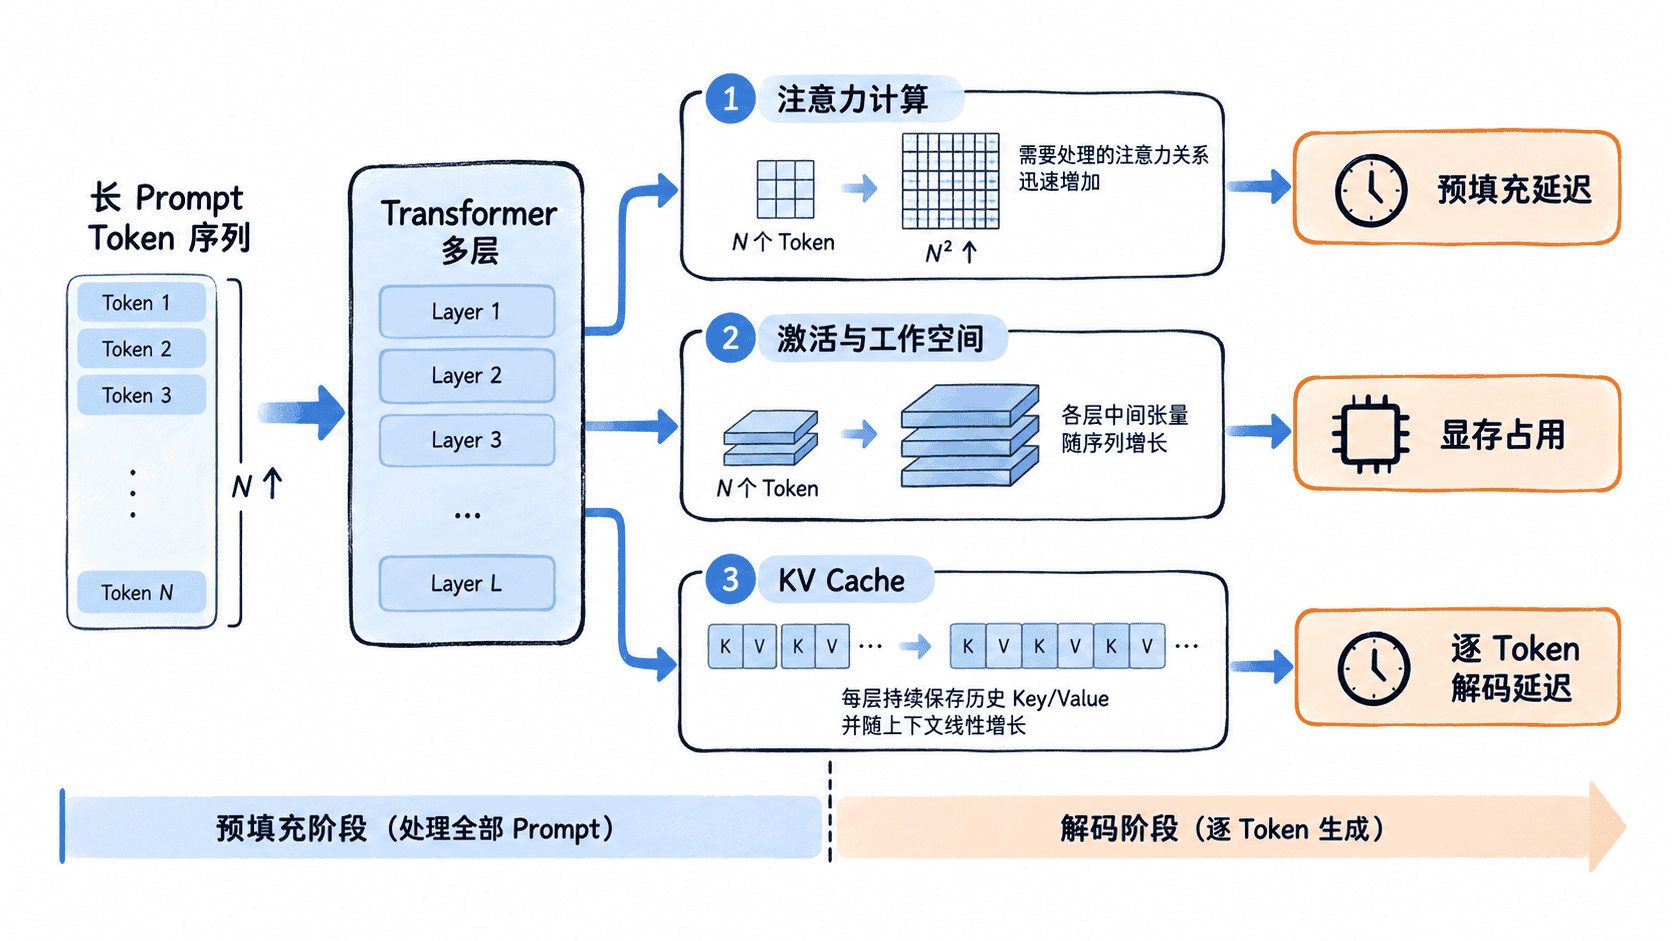
一次自回归推理通常可以分成预填充和解码两个阶段。预填充先并行处理整段输入,建立每层的中间表示和 KV Cache;随后解码每生成一个新 Token,都复用已经缓存的 Key、Value,而不是重新计算全部历史 Token。
因此,上下文从 4K 增长到 32K 时,不能只问“模型支持多少 Token”,而要同时观察三条成本路径:注意力需要处理更多 Token 之间的关系,算子产生更大的中间张量,KV Cache 则要长期保留越来越多的历史状态。
注意力首先抬高预填充计算量
设输入长度为 。标准自注意力需要计算 Query 与 Key 之间的两两相关性,注意力得分矩阵的规模与 成正比。因此从理论结构看,序列长度翻倍时,这部分需要处理的 Token 对数量约变为四倍。
这里最明显地影响的是预填充阶段。模型需要一次性读取整个 Prompt,并为所有位置计算表示。现代实现会使用 FlashAttention 等方法减少显存读写和中间矩阵落盘,所以实际耗时不会简单严格按照平方增长,但“更长输入带来显著更多注意力工作”这一判断仍然成立。
激活和临时工作空间占用更多显存
Transformer 每一层都会产生隐藏状态、Q/K/V、MLP 中间结果等张量。推理时不需要像训练那样长期保存全部反向传播激活,但算子执行期间仍需保留当前阶段必要的输入、输出和临时工作空间。
序列越长,一次参与预填充计算的 Token 越多,这些张量通常也越大。若使用普通注意力实现,还可能显式构造巨大的注意力矩阵;采用内存高效注意力后,可以避免保存完整的 矩阵,从而明显降低峰值显存,但隐藏状态等与 Token 数近似线性相关的占用仍然存在。
这也是为什么“模型权重能放进显卡”并不等于“任意长度上下文都能运行”。真正的峰值显存还必须给运行时张量、算子工作区以及缓存留出空间。
KV Cache 让历史上下文持续占用显存
自回归生成时,每一层都会保存已经处理过的 Key 和 Value。生成下一个 Token 时,只需计算新 Token 的 Q/K/V,再让新的 Query 与历史 Key、Value 交互。这样避免了重复处理整段历史,但代价是历史状态必须一直留在显存中。
在模型层数、KV Head 数、Head 维度和数值精度固定时,单请求 KV Cache 可以近似写成:
其中 是层数, 是已经缓存的 Token 数, 是 KV Head 数, 是单个 Head 的维度, 表示 Key 和 Value 两份缓存, 表示每个元素占用的字节数。由此可以看到,KV Cache 对上下文长度近似线性增长。
批量推理时还要再乘上并发序列数量。一个单请求能够容纳 64K 上下文的部署,在同时服务几十个请求时,往往会先被 KV Cache 消耗掉大量显存。因此推理引擎会使用分页式 KV Cache、块管理、低精度缓存或请求调度来提高显存利用率。
解码阶段还会遇到内存带宽压力
KV Cache 解决了重复计算问题,却没有让历史完全“免费”。每生成一个新 Token,新 Query 仍需读取已有的 Key 和 Value。上下文越长,需要扫描的数据越多,所以单 Token 解码时间可能随历史长度上升。
这类阶段经常不是纯计算能力不足,而是大量缓存数据必须从显存读取,逐渐受到内存带宽限制。于是一个典型长上下文请求可能呈现两种不同瓶颈:Prompt 很长时,首 Token 前的预填充延迟明显增加;生成持续进行时,庞大的 KV Cache 又会提高后续每个 Token 的延迟和显存占用。
判断长上下文成本时,应把“窗口上限”与“可承受的服务成本”分开。注意力决定预填充计算会迅速变重,激活与工作空间影响峰值显存,而 KV Cache 同时约束并发容量和长序列解码效率。模型宣称支持更大的上下文,只说明能够表达这个长度,并不意味着所有长度都具有相同的吞吐、延迟和部署成本。