
大模型原理与训练 / 系统课时
准备微型语料与词元器
准备微型语料与词元器
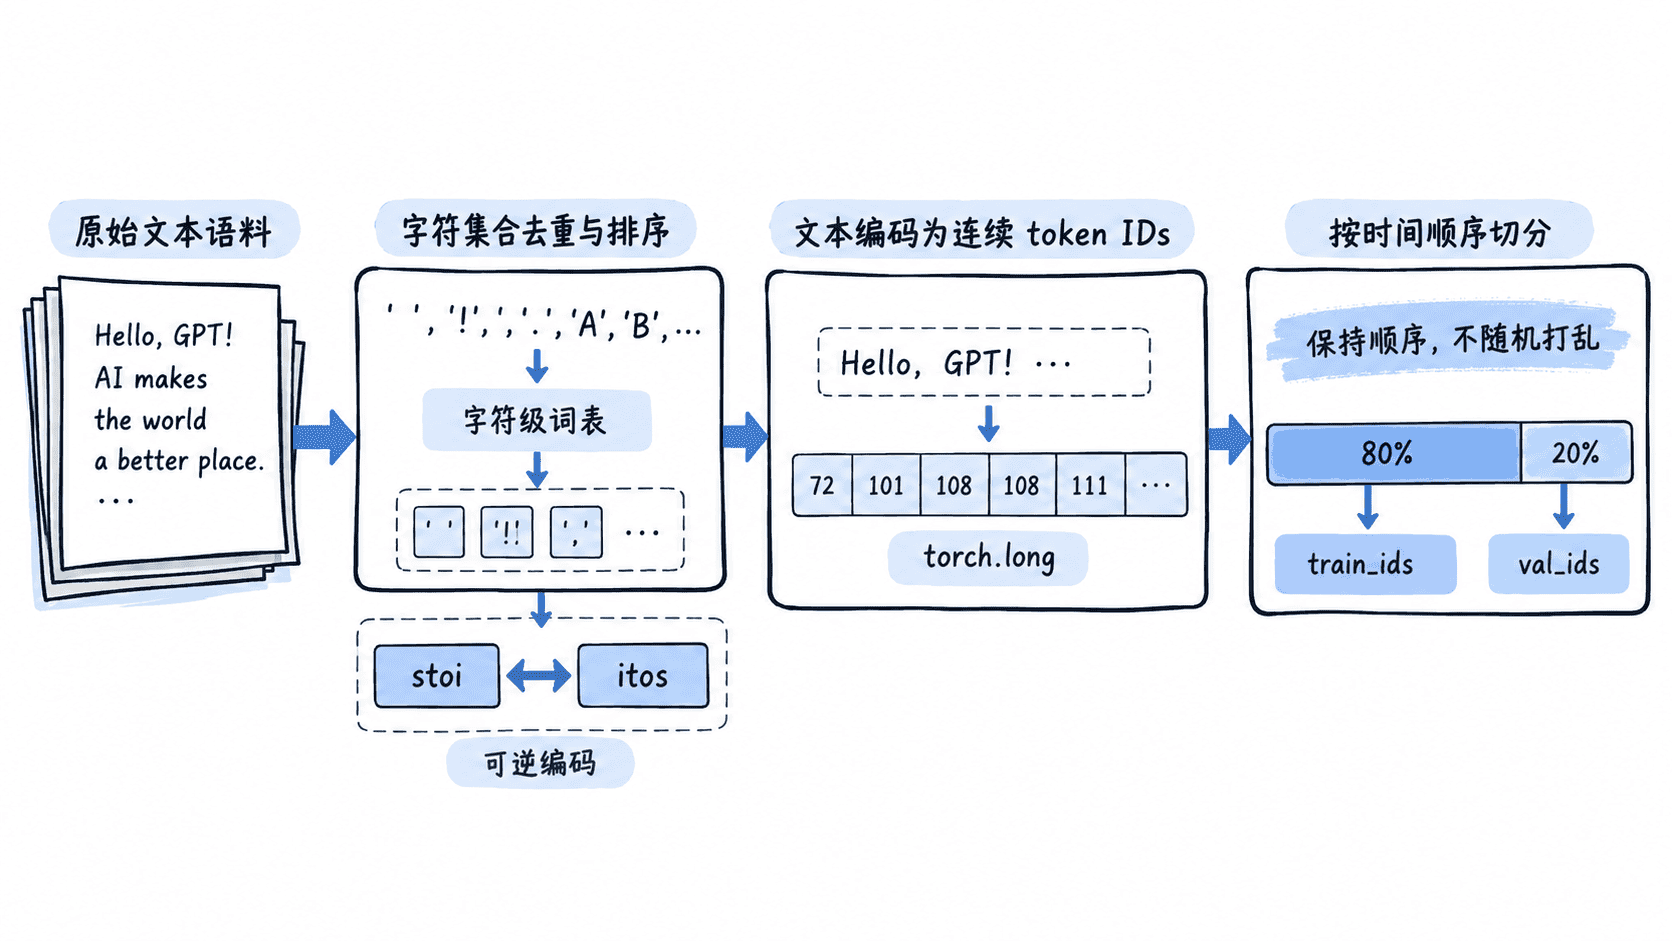
这一节把一小段文本变成微型 GPT 可以直接消费的整数序列,并把词元映射、训练序列和验证序列落盘。重点不是训练出好模型,而是得到一份可重复、可检查、后续课时能直接复用的数据输入。
学习目标
- 用字符级词元器建立可逆的文本与 token id 映射
- 把连续 token 序列划分为训练集和验证集并持久化
- 检查词表大小、数据类型和编码解码是否满足后续 GPT 实验要求
固定最小数据约定
为了把注意力集中在 GPT 机制上,这里选用字符级词元器。每个不同字符对应一个整数 id,优点是实现短、映射透明、不会依赖外部分词库;缺点是序列通常比子词分词更长,因此它适合机制验证,不代表生产模型的最佳选择。
后续语言模型需要的是一条保持原始顺序的一维 token 序列。训练时再从这条序列中截取长度为 block_size 的窗口,并把窗口右移一位得到预测目标,所以此处不要提前随机打乱 token。
生成并保存可复用数据
下面的脚本只依赖 Python 与 PyTorch。语料故意很小,运行后会生成 tokenizer.json、train_ids.pt 和 val_ids.pt,足够支撑后续嵌入、注意力和训练循环的形状验证。
from pathlib import Path
import json
import torch

text = "hello gpt\nhello transformer\n"

# 字符级词元器把映射关系完全暴露出来,便于核对后续张量。
chars = sorted(set(text))
stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for ch, i in stoi.items()}

def encode(s: str) -> list[int]:
    return [stoi[ch] for ch in s]

def decode(ids: list[int]) -> str:
    return "".join(itos[i] for i in ids)

ids = torch.tensor(encode(text), dtype=torch.long)
split = int(len(ids) * 0.8)
train_ids = ids[:split]
val_ids = ids[split:]

out_dir = Path("data-mini-gpt")
out_dir.mkdir(exist_ok=True)
torch.save(train_ids, out_dir / "train_ids.pt")
torch.save(val_ids, out_dir / "val_ids.pt")

# JSON 只保存可移植的词元映射;整数键转成字符串以符合 JSON 对象规则。
tokenizer = {
    "stoi": stoi,
    "itos": {str(i): ch for i, ch in itos.items()},
}
(out_dir / "tokenizer.json").write_text(
    json.dumps(tokenizer, ensure_ascii=False, indent=2),
    encoding="utf-8",
)

print("vocab_size:", len(chars))
print("train_tokens:", len(train_ids))
print("val_tokens:", len(val_ids))
print("round_trip:", decode(encode(text)) == text)
print("saved:", "tokenizer.json train_ids.pt val_ids.pt")
预期输出:
vocab_size: 15
train_tokens: 22
val_tokens: 6
round_trip: True
saved: tokenizer.json train_ids.pt val_ids.pt
round_trip: True 是最重要的基本检查:文本经过编码再解码后必须完全一致。保存的两个张量都是一维 torch.long,这正是 nn.Embedding 期望的索引类型。
切分与采样不要混为一谈
这里先按连续顺序做 80%/20% 切分,再在各自分区内部采样训练窗口。这样验证序列不会被训练窗口跨界读取。真正扩大语料时,应先确定训练、验证边界,再用训练数据拟合或训练分词器;本例为了让极小语料中的字符都可编码,直接从整段演示文本建立词表。
对自回归训练而言,一个窗口可以写成 x = ids[i:i+block_size],目标则是 y = ids[i+1:i+block_size+1]。因此某个分区至少要有 block_size + 1 个 token 才能产生一个完整样本,后续设置上下文长度时必须受这个条件约束。
后续实验需要保持的接口
后续模块只需要约定三件事:vocab_size 与词表一致,输入张量使用整数 id,训练与验证分别读取自己的序列。若把字符级词元器替换成 BPE 或其他子词方案,只要仍然提供可逆的 encode、decode 和稳定的词表大小,GPT 主体代码无需跟着改写。