
大模型原理与训练 / 系统课时
用 GQA 降低注意力缓存
用 GQA 降低注意力缓存
自回归生成时,模型会把历史词元的 Key 和 Value 留在 KV Cache 中,序列越长、层数越多,缓存越大。GQA 的核心不是减少查询头,而是让多组查询头共享较少的键值头,在尽量保留多头表达能力的同时显著降低缓存与内存带宽压力。
学习目标
- 说清 MHA、MQA 与 GQA 在查询头和键值头上的共享关系。
- 根据查询头数与键值头数估算 KV Cache 的相对变化。
- 理解 GQA 为什么常用于长上下文和高吞吐推理,以及它的质量边界。
从 KV Cache 的来源看问题
在标准多头注意力 MHA 中,每个注意力头通常都有自己的 Query、Key、Value 投影。推理第一个词元时会算出全部 K、V;生成后续词元时,旧词元的 K、V 不必重复计算,因此被缓存起来。
对单层、单个序列做近似估算,KV Cache 的元素数量与 序列长度 × KV 头数 × 每头维度 × 2 成正比,其中最后的 2 表示同时保存 Key 和 Value。若数据类型和每头维度不变,缓存大小几乎随 KV 头数线性变化。
这意味着:查询头数决定模型同时从多少“视角”发起注意力,而 KV 头数直接影响需要保存多少组历史 K、V。GQA 正是利用了这两个数量不必相等这一点。
GQA 怎样共享键值头
假设模型有 32 个 Query 头,但只有 8 个 KV 头。GQA 会把 32 个 Query 头分成 8 组,每组 4 个 Query 头共享同一对 K、V 投影。注意力计算仍然保留 32 个 Query 头,只是在读取历史键值时,每 4 个 Query 头复用一组缓存。
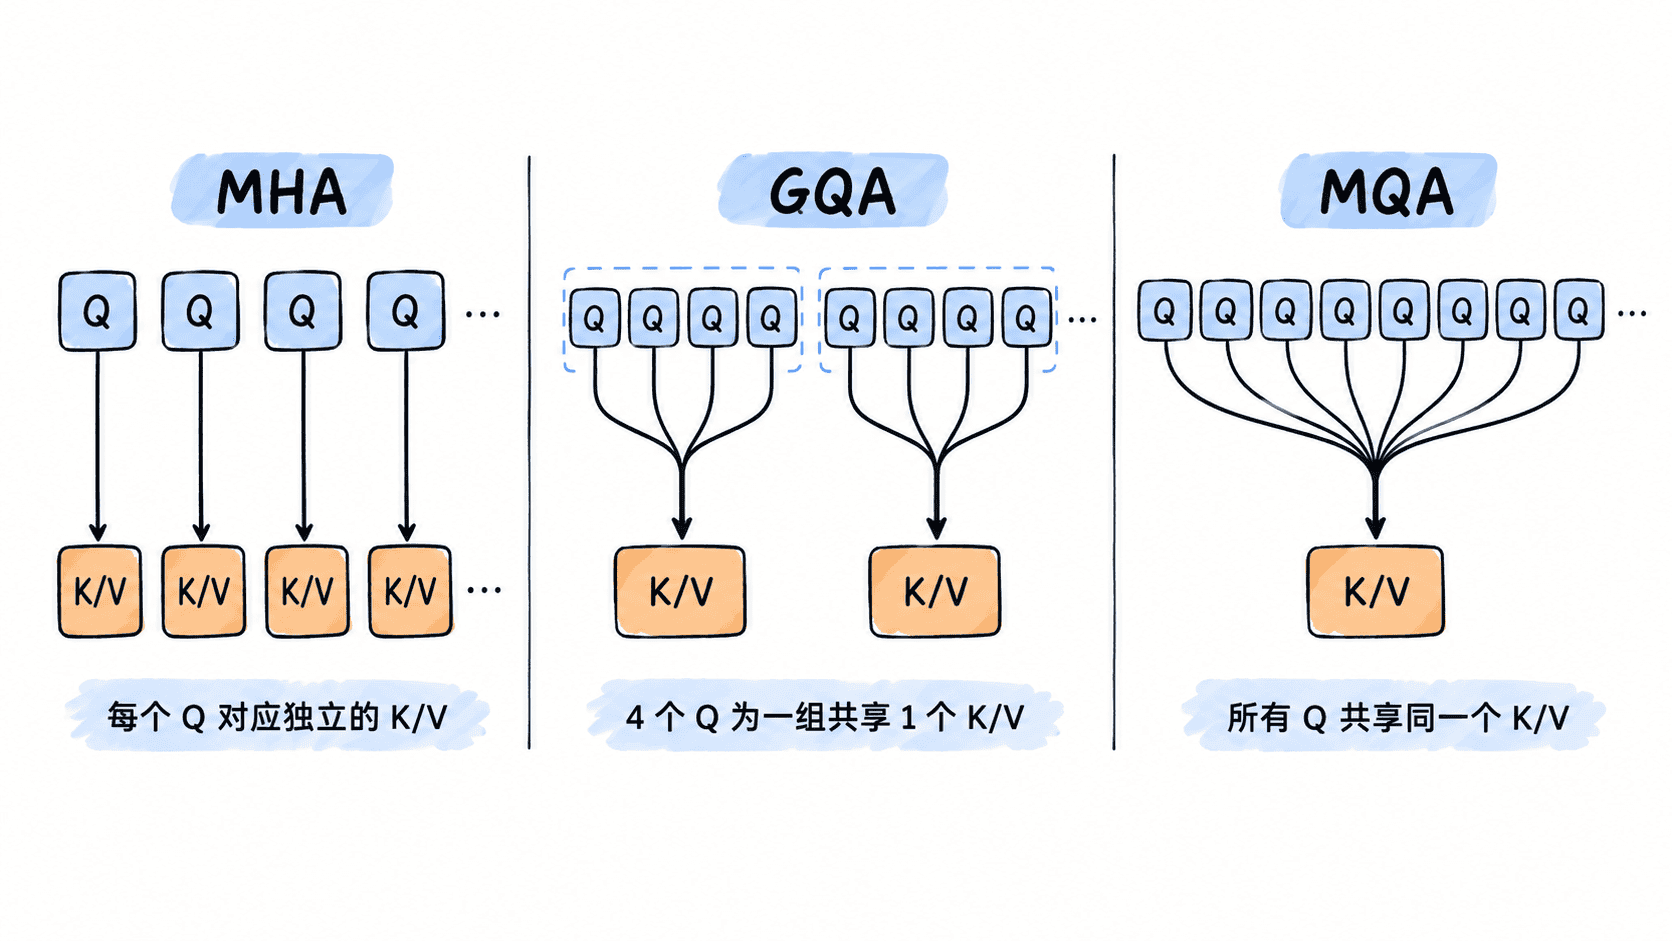
三种形式可以用头数关系快速区分:
| 形式 | Query 头数 | KV 头数 | KV Cache 特征 |
|---|---|---|---|
| MHA | 多个 | 与 Query 头相同 | 最大,表达最独立 |
| GQA | 多个 | 少于 Query 头且大于 1 | 成组共享,折中 |
| MQA | 多个 | 1 | 最小,共享最强 |
如果 MHA 使用 32 个 KV 头,而 GQA 只使用 8 个,在其他条件相同的近似下,K/V 部分缓存可降到原来的 8 / 32 = 1/4。真实显存还包含模型权重、激活、运行时缓冲区等,因此整机显存不会同步降到四分之一。
为什么共享后仍能工作
Query 负责表达“当前头想找什么”,Key 和 Value 则提供“历史位置能被怎样匹配与读取”。GQA 保留较多 Query 头,因此不同头仍能形成不同的查询方向;共享 K、V 会减少历史表示的独立份数,但不等于把多个 Query 头合并成一个头。
这种设计通常比 MQA 保留更多键值表示能力,又比 MHA 少存大量 K、V。对长上下文推理尤其有利,因为上下文长度增加时,KV Cache 会持续增长,内存容量和内存带宽往往先于算力成为瓶颈。
怎样判断共享比例是否合适
可以先看组大小:Query 头数 / KV 头数。组越大,缓存越省,但更多 Query 头要共享同一组 K、V;组越小,行为越接近 MHA,缓存收益也越弱。
工程上通常不会在已有模型上随意把 KV 头砍掉,因为投影权重与训练分布已经固定。原生采用 GQA 的模型会在训练阶段学习这种共享结构;若从 MHA 改造为 GQA,往往还需要合并或初始化 K/V 投影并继续训练,才能恢复质量。
因此,GQA 的价值可以概括为:保留多查询头的表达自由度,用更少的 KV 头换取更小的缓存和更低的内存带宽压力。在长上下文、批量并发和显存紧张的推理场景中,这个折中尤其重要。