
大模型原理与训练 / 系统课时
用因果 Mask 阻断未来信息
用因果 Mask 阻断未来信息
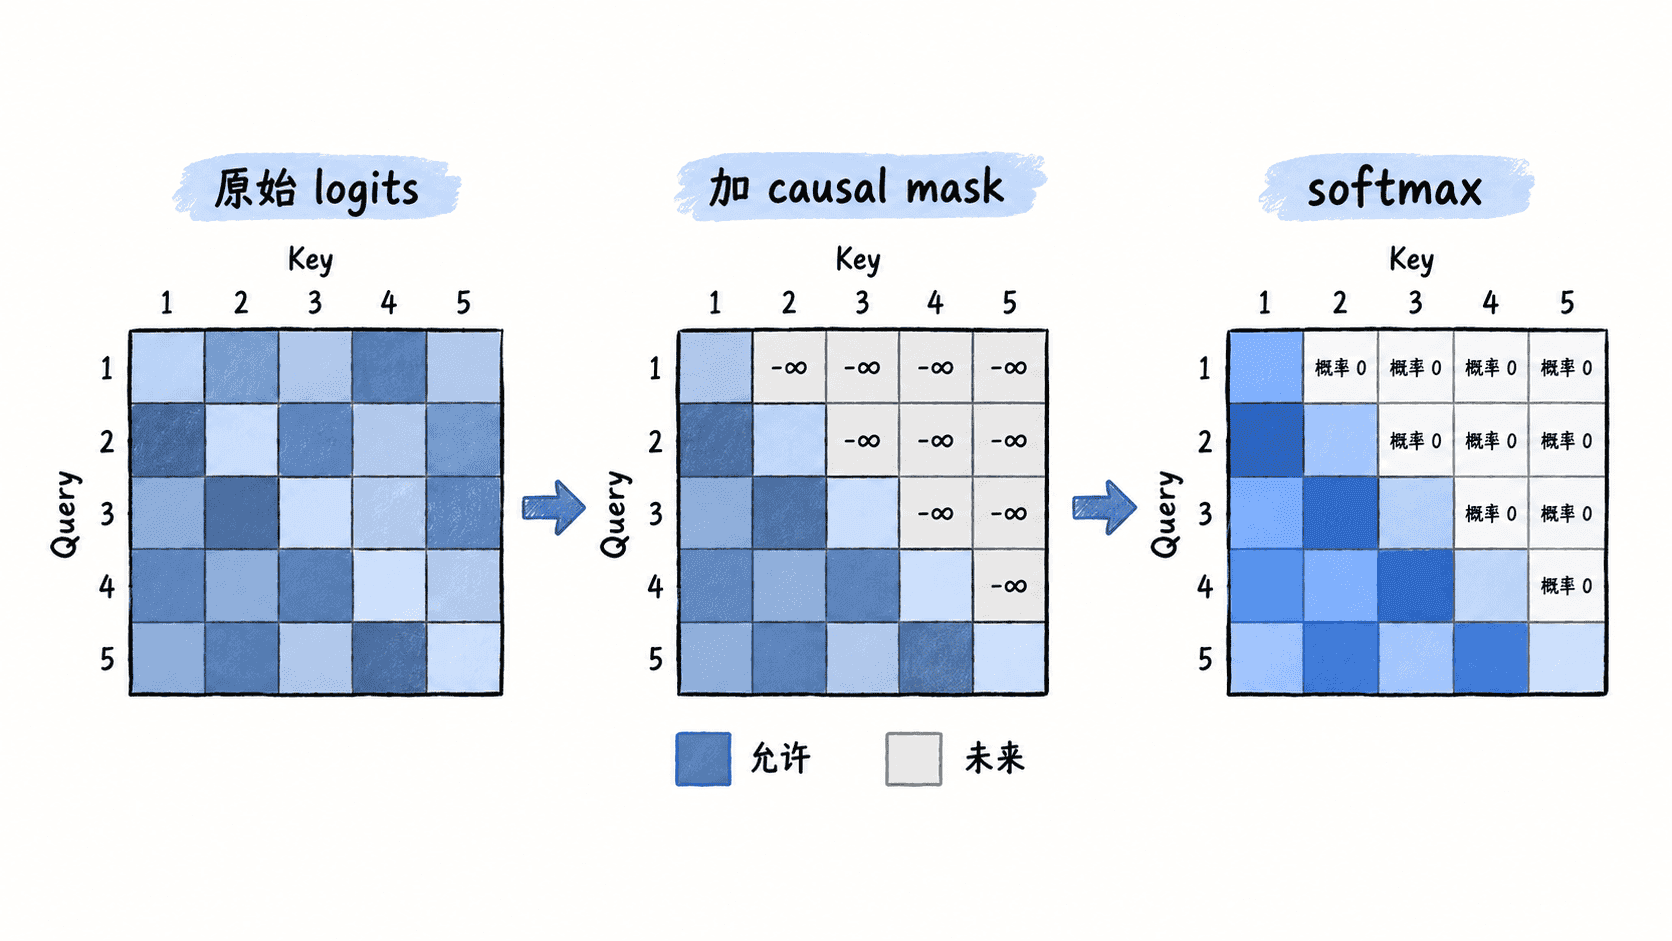
自回归模型训练时会一次看到整段序列,但位置 的预测只能依赖自己和更早的词元。因果 Mask 的作用,就是在注意力进入 Softmax 之前把所有“看向未来”的路径封死,让并行训练仍然遵守逐词生成时的信息边界。
学习目标
- 解释自回归训练为什么必须屏蔽未来词元
- 看懂因果 Mask 如何修改注意力分数与概率
- 区分正确掩码位置与常见错误做法
为什么并行训练会带来信息泄漏
训练 GPT 一类模型时,通常把一段长度为 的序列整体送入 Transformer,同时计算每个位置的下一个词预测。这样做效率很高,但也带来一个约束:第 个位置不能从第 、 等未来位置读取信息。
假设序列是“我 喜欢 吃 苹果”。当模型用“我 喜欢 吃”预测“苹果”时可以读取前三个位置;但在较早位置预测“喜欢”时,如果注意力能直接看见后面的“吃 苹果”,损失虽然会变小,却是在偷看答案。这样的模型在推理阶段拿不到未来词元,训练与生成就会失配。
Mask 实际加在哪里
单头注意力先得到分数矩阵 。因果 Mask 也是一个与注意力位置关系兼容的矩阵 :当 Key 位置 不晚于 Query 位置 时取 0;当 时取负无穷。随后计算 。
关键顺序是先加 Mask,再做 Softmax。被屏蔽位置的分数变成负无穷,指数化后贡献为 0,因此不会参与归一化。若先做 Softmax 再把未来概率清零,剩余概率之和会小于 1,还需要额外归一化,既绕远也更容易实现错。
以 4 个词元为例,允许关系如下:
| Query 位置 | 可关注的 Key 位置 | 被屏蔽位置 |
|---|---|---|
| 1 | 1 | 2、3、4 |
| 2 | 1、2 | 3、4 |
| 3 | 1、2、3 | 4 |
| 4 | 1、2、3、4 | 无 |
这就是一个包含主对角线的下三角结构。主对角线必须保留,因为当前位置的隐藏状态参与预测下一个词;真正禁止的是当前位置右侧的未来位置。
掩码如何改变概率分布
设某个 Query 对四个 Key 的原始注意力分数是 。如果当前 Query 位于第 2 个位置,那么后两个 Key 属于未来信息,应先改成 。
Softmax 后,前两个位置会重新归一化,后两个位置严格为 0。注意这不是“降低未来词权重”,而是从可选集合中彻底移除未来位置。训练时即使整段序列并行存在,每个位置实际能读取的信息仍与逐步生成保持一致。
两个容易写错的边界
第一,不能把主对角线也屏蔽。标准 GPT 的目标是用位置 的隐藏状态预测位置 的词元,因此位置 可以关注自己以及更早位置。
第二,Padding Mask 与因果 Mask 解决的是不同问题。因果 Mask 阻止读取未来;Padding Mask 阻止读取补齐出来的无效位置。批量训练可同时使用两者,最终屏蔽集合相当于二者的并集。
只要记住一个判断标准:对任意位置 ,它的注意力概率只能分配给不晚于 的有效词元。满足这个约束,模型就能在并行训练时保持与自回归生成一致的信息边界。