
大模型原理与训练 / 系统课时
手算一次缩放点积注意力
手算一次缩放点积注意力
缩放点积注意力可以拆成四步:计算 、按 Key 维度缩放、逐行做 Softmax、再对 V 加权求和。下面只用两个位置和二维向量手算一遍,并在每一步同时检查数值含义和张量形状。
学习目标
- 手算 、缩放和逐行 Softmax
- 用注意力权重完成对 V 的加权求和
- 通过形状、权重和输出范围检查计算是否合理
准备一个最小矩阵
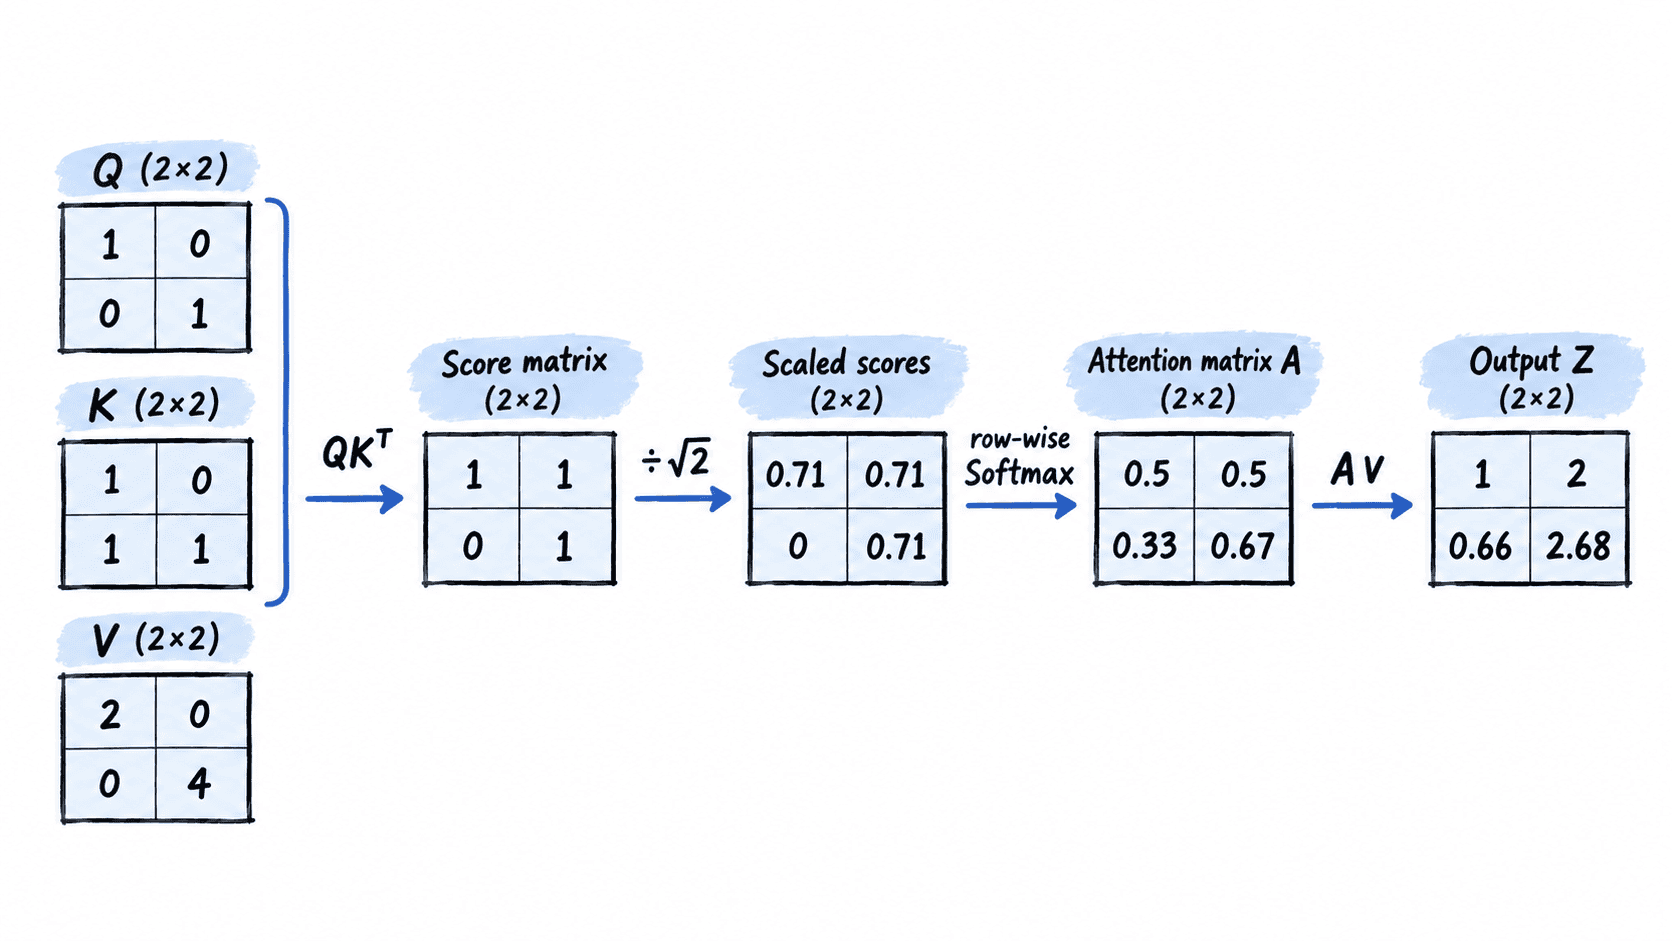
设 Q、K、V 都包含两个位置,每个向量都是二维,所以 。用“每一行代表一个位置”的方式写出数据:
| 矩阵 | 第 1 行 | 第 2 行 | 形状 |
|---|---|---|---|
| Q | [1, 0] | [0, 1] | 2×2 |
| K | [1, 0] | [1, 1] | 2×2 |
| V | [2, 0] | [0, 4] | 2×2 |
Q 有两个 Query,K 有两个可供匹配的 Key,V 有两个可以被聚合的 Value。最终应该为两个 Query 各生成一个二维输出,因此结果形状也应是 2×2。
计算相关性并缩放
先计算每个 Query 与每个 Key 的点积。第一个 Query [1, 0] 分别与两个 Key 相乘,得到 1 和 1;第二个 Query [0, 1] 得到 0 和 1。因此:
| Query | 对 Key 1 的分数 | 对 Key 2 的分数 |
|---|---|---|
| Q1 | 1 | 1 |
| Q2 | 0 | 1 |
这就是 。它的形状是 2×2:行数来自 Query 数量,列数来自 Key 数量。
接下来按照缩放点积注意力的规则计算:
因为 ,所以除数为 。缩放后的两行分数分别约为 [0.707, 0.707] 和 [0, 0.707]。
缩放不会改变一行内分数的大小顺序。它控制的是进入 Softmax 前的幅度,避免维度较大时点积数值变得过大,从而让 Softmax 权重过早接近极端的 0 和 1。
逐行执行 Softmax
Softmax 必须对每个 Query 所在的行独立计算,因为每个 Query 都需要在全部 Key 之间分配自己的注意力。
第一行两个分数相同,所以归一化后为 [0.500, 0.500]。第二行是 [0, 0.707],指数归一化后约为 [0.330, 0.670]:
| Query | Key 1 权重 | Key 2 权重 | 行和 |
|---|---|---|---|
| Q1 | 0.500 | 0.500 | 1.000 |
| Q2 | 0.330 | 0.670 | 1.000 |
得到的注意力矩阵 A 仍然是 2×2。这里最容易犯的错误是把 Softmax 沿列执行;那样就不再表示“一个 Query 如何在所有 Key 之间分配注意力”。
用权重对 V 加权求和
现在用每一行注意力权重去组合两个 Value。对第一个 Query:
对第二个 Query:
因此最终输出可以写成两行:[1.00, 2.00] 和 [0.66, 2.68]。第一行平均采用两个 Value;第二行更偏向第二个 Value,所以它的第二维明显更接近 4。
注意这里真正被加权求和的是 V。 和 Softmax 只负责产生“各取多少”的权重,并不直接构成最终输出内容。
用三项检查发现计算错误
先检查形状。若 Q 的形状为 ,K 为 ,那么 必须得到 ;再与 V 相乘以后,输出行数应与 Query 数量一致。
再检查 Softmax。每一行权重都应该非负,而且总和约等于 1。若行和不为 1,通常意味着归一化过程或 Softmax 轴选错了。
最后检查输出。每一个输出向量都是若干 Value 的非负加权平均,因此不应凭空产生超出这些 Value 凸组合范围的异常数值。按“形状 → 行和 → 输出范围”依次检查,矩阵方向、Softmax 轴和最终加权这三类常见错误通常都能被快速发现。