
大模型原理与训练 / 系统课时
判断延迟吞吐与显存取舍
判断延迟吞吐与显存取舍
部署大模型时,很难同时把单请求延迟、系统吞吐和显存占用都压到最优。提高并发和批大小可能让 GPU 利用率更高,却也可能增加排队与 KV Cache;一味追求低延迟又可能让硬件长期吃不满。本节建立一套统一的取舍框架,用于判断真正的瓶颈在哪里。
学习目标
- 区分延迟、吞吐与显存三个指标各自回答的问题
- 解释批处理、并发和上下文长度为什么会同时改变三类指标
- 根据交互式、批处理和长上下文场景选择合理的优化优先级
三个指标回答不同问题
延迟描述一个请求等多久,常见观察项包括首词元延迟、每词元生成时间以及完整响应耗时。面向聊天、代码补全等交互场景时,用户通常对延迟非常敏感。
吞吐描述单位时间内系统完成多少工作,可以用请求数或输出词元数衡量。离线摘要、批量抽取等任务通常更关心整体处理量,而不是某一个请求是否最快返回。
显存则决定模型能否装载,以及同一时刻还能容纳多少请求状态。推理时不能只看模型权重,因为活跃请求还会占用 KV Cache、临时张量和推理框架所需的运行空间。
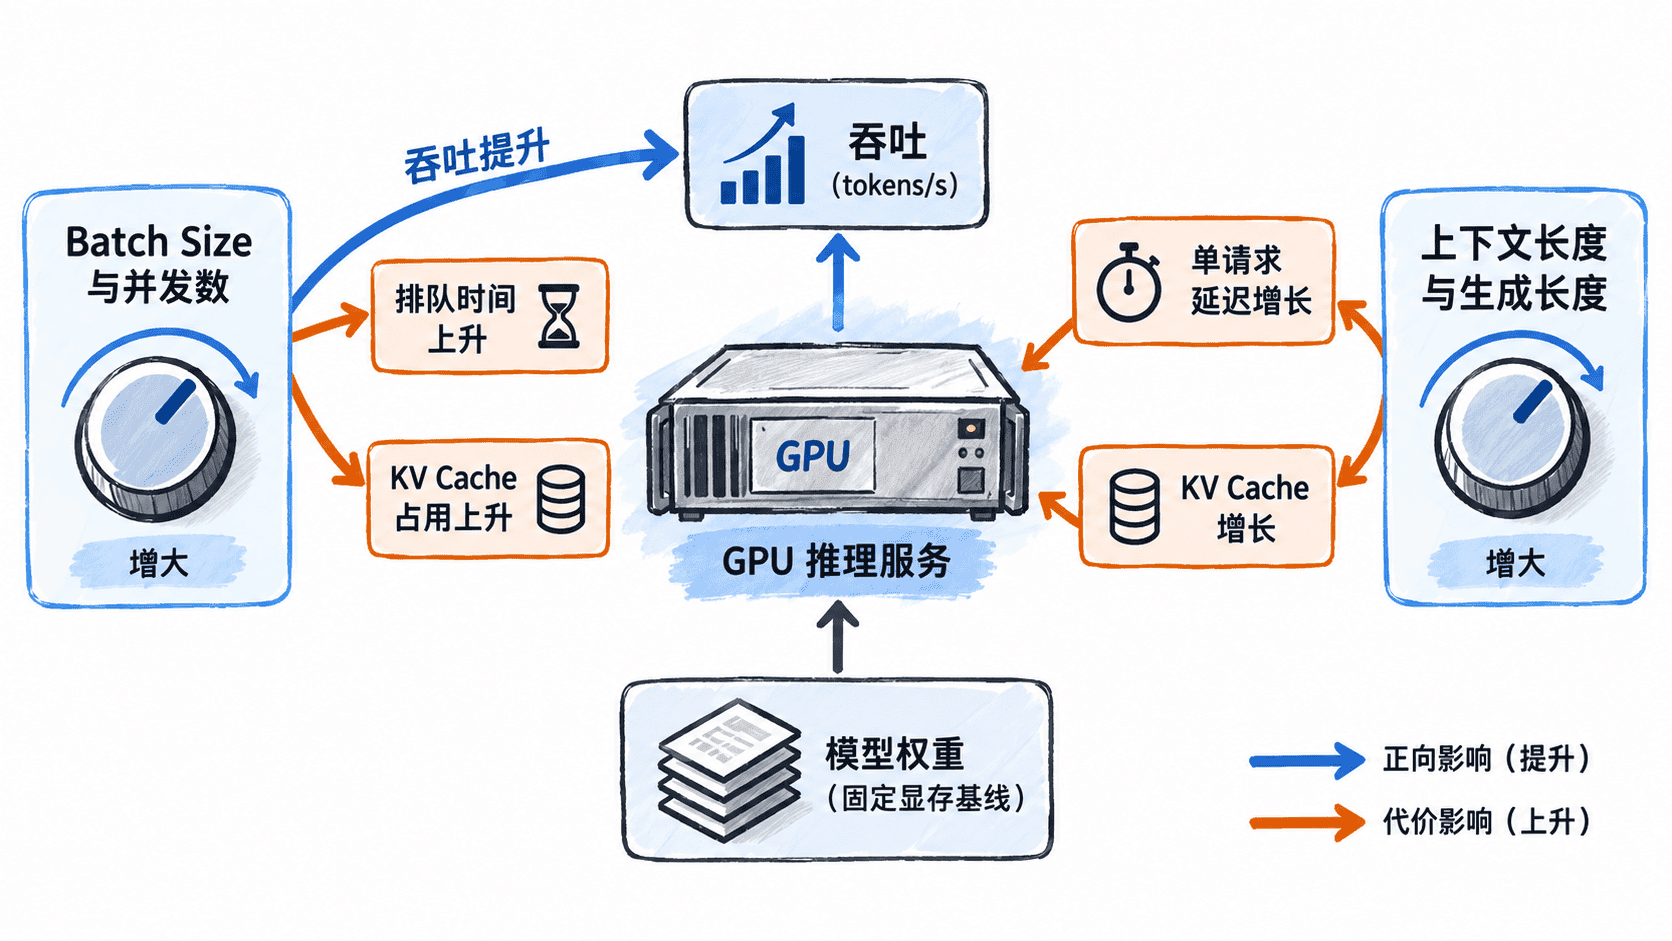
如果只说“性能更好”而不说明优化的是哪一个指标,判断往往会失去意义。一个方案完全可能让总吞吐提高,同时让单个请求等待得更久。
显存预算先决定可行边界
推理显存可以用一个简化关系建立直觉:
模型权重通常构成较稳定的基线。KV Cache 则随着活跃请求数、已处理上下文长度以及生成长度增长;运行时还需要为中间结果、算子工作区和推理框架留下余量。
因此一张 GPU 在“模型刚好能装下”时,并不代表已经具备可用的在线服务容量。如果权重占满绝大部分显存,剩余空间不足以容纳多个请求的 KV Cache,那么实际并发能力仍然很弱。
长上下文模型尤其需要警惕这一点。上下文窗口是模型允许的上限,不等于部署时可以让所有并发请求都以最大长度运行。容量规划必须围绕真实输入长度分布和并发目标进行。
提高吞吐为什么可能增加延迟
推理服务器常通过批处理把多个请求放到同一轮 GPU 计算中。这样可以提高硬件利用率,并把部分固定开销摊到更多请求上,所以总体吞吐通常更有机会提升。
代价是请求可能需要等待其他请求组成批次,而且更大的活跃批次会消耗更多 KV Cache。GPU 已经接近饱和后继续增加并发,还可能只是让请求进入更长的队列,而不是带来等比例的处理能力。
所以并发不是越高越好。真正应寻找的是一个工作区间:GPU 有足够利用率,同时排队时间、尾延迟和显存峰值仍满足服务目标。
不同场景的优先级不同
| 场景 | 首要目标 | 常见策略 | 主要代价 |
|---|---|---|---|
| 交互式聊天 | 低首词元与低生成延迟 | 控制队列、适度批处理、限制过长请求 | GPU 利用率可能不是最高 |
| 离线批处理 | 高总体吞吐 | 增大批次与并发,让 GPU 保持繁忙 | 单请求完成时间可能增加 |
| 长上下文多用户 | 控制显存并保持可接受延迟 | 管理上下文长度、KV Cache 与并发上限 | 可同时服务的请求数受限 |
这三类目标没有统一的最佳参数。聊天系统把吞吐提升 10% 却让首词元延迟翻倍,可能是失败的优化;离线任务为了降低单请求延迟而把 GPU 利用率压到很低,也可能得不偿失。
用统一顺序做容量判断
实际评估时,可以按固定顺序缩小问题范围:
- 先定义服务目标,例如首词元延迟、每词元延迟、P95 完成时间或目标吞吐。
- 确认模型权重加载后还剩多少显存,得到可用于请求状态的基本预算。
- 根据典型上下文长度估算单请求 KV Cache 压力,判断理论并发是否现实。
- 逐步提高批大小或并发,观察吞吐是否继续增长,以及排队和尾延迟是否恶化。
- 当显存、计算能力或调度中的某一项先达到边界时,再针对该瓶颈选择量化、缓存优化、批处理策略或其他加速技术。
延迟、吞吐和显存不是三个独立的调参目标,而是同一套推理资源在时间与空间上的不同表现。先明确业务最不能牺牲的指标,再寻找约束条件下的最优工作点,比单独追求最高 tokens/s 或最低显存数字更可靠。