
大模型原理与训练 / 系统课时
解释安全拒答与能力保留张力
解释安全拒答与能力保留张力
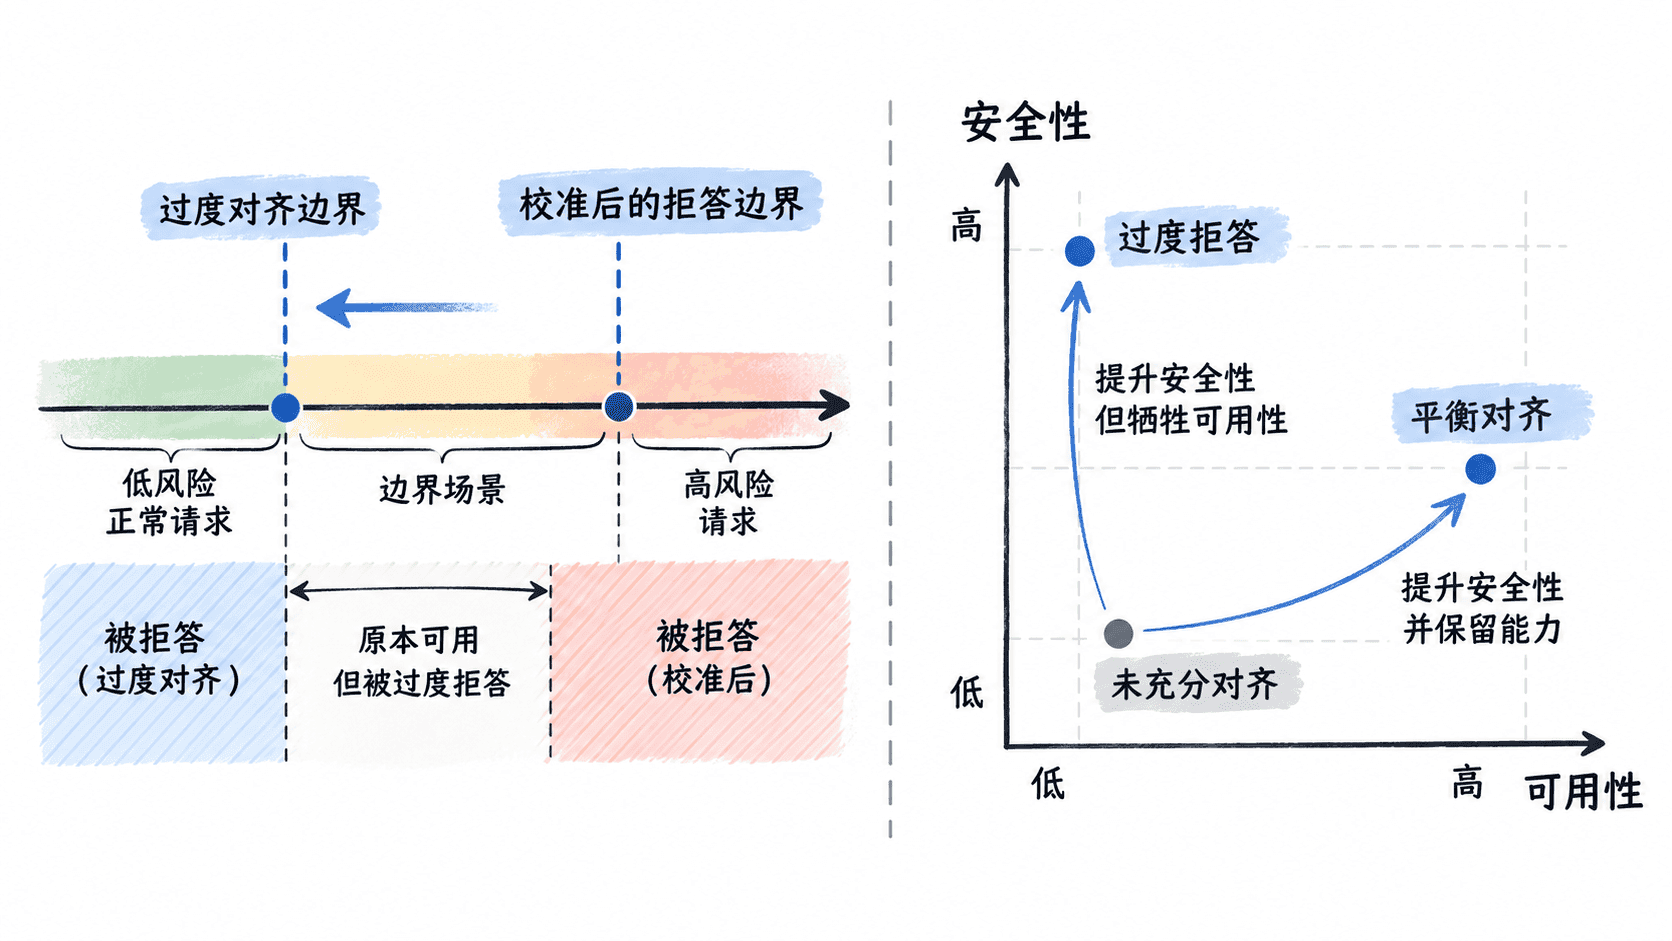
安全对齐的目标不是让模型“拒答越多越安全”,而是让拒答边界与真实风险匹配。边界过宽会误伤正常请求,边界过窄又会放过高风险内容。本篇从安全性与可用性两侧解释过度拒答、能力退化和分布偏移,并给出判断对齐效果的基本框架。
学习目标
- 解释安全拒答为何本质上是风险边界的选择,而不是单纯提高拒答率
- 区分过度拒答、能力退化与分布偏移三类问题的表现和来源
- 用安全性与可用性两组指标评估一个对齐策略是否真正有效
安全拒答本质上是边界选择
模型收到请求后,需要在“直接回答、受约束地回答、拒绝”之间做行为选择。安全对齐会改变这种选择的概率:高风险输入更倾向于拒绝,低风险输入仍应保留原有能力,边界场景则需要根据上下文精细判断。
真正困难的地方在于,风险不是一个只由关键词决定的标签。同一主题中可能同时存在正常解释、合规操作和高风险意图。如果训练把“某些词出现”直接学成“必须拒绝”,拒答边界就会向低风险区域扩张,形成过度拒答。
三类代价如何出现
过度拒答指本来可以安全回答的请求被拒绝。常见原因是训练数据或偏好信号把表面特征与危险意图绑定得过紧,模型没有学会区分“讨论某个敏感主题”和“执行高风险行为”。它首先损害的是正常用户任务完成率。
能力退化不是安全对齐的必然结果,但当训练目标过度惩罚某类输出、对齐数据覆盖过窄,或更新幅度过大时,模型可能连原本允许的推理、解释和领域知识也一起压低。此时问题不只是“更爱拒绝”,而是即使选择回答,质量也可能下降。
安全训练通常只能覆盖有限的提示形式,而真实请求会换语言、换表达、加入上下文或组合多个任务。如果训练分布和真实使用分布差异过大,模型可能在测试集上看似安全,却在新表达上误拒或漏拒。这类分布偏移需要通过改写、跨语言、长上下文和边界场景专门检测。
| 问题 | 主要表现 | 应观察的信号 |
|---|---|---|
| 过度拒答 | 正常请求被直接拒绝 | 低风险集拒答率、任务完成率 |
| 能力退化 | 允许回答时质量仍下降 | 正确率、推理质量、指令遵循 |
| 分布偏移 | 换表达后行为明显失稳 | 改写集、跨语言集、长上下文集表现 |
评估不能只看总拒答率
总拒答率没有单独的好坏含义:在高风险集合上,合理拒答率上升通常是积极信号;在低风险集合上,同样的上升却意味着可用性损失。评估时应先按风险层级拆分样本,再分别观察高风险漏拒、低风险误拒和正常任务质量。
边界样本尤其重要。它们可以检测模型是否只记住关键词,而没有理解意图和上下文。若模型面对轻微改写就从正常回答跳到完全拒绝,说明策略校准还不稳定,即使平均指标看起来不错,也不能认为问题已经解决。
更好的目标是最小必要拒答
高质量安全行为应尽量保留允许的帮助,只限制真正不应提供的部分。例如,一个请求同时包含安全背景知识和不允许的操作细节时,模型可以拒绝危险部分,同时继续提供合规解释或替代方案。这样做比“整段一律拒绝”更能兼顾安全与能力。
因此,安全对齐应优化的是风险匹配的行为边界,而不是拒答数量本身。一个更好的模型既能在高风险处稳定收缩能力,也能在低风险处保持原有任务完成能力,并在分布变化时维持这种区分。