
大模型原理与训练 / 系统课时
用监督样本塑造指令遵循
用监督样本塑造指令遵循
指令微调的核心不是简单收集大量问答,而是把任务要求、必要上下文和目标回答组织成稳定的监督样本。本篇拆解 instruction、input、response 三部分如何变成训练信号,并说明模板一致性与任务分布为何会直接影响模型最终“听不听懂、答得像不像”。
学习目标
- 理解 instruction、input、response 在监督样本中的不同职责
- 解释样本如何被序列化并转化为回答区域的学习信号
- 判断模板质量和任务分布可能造成的指令遵循偏差
一条监督样本包含什么
最常见的抽象结构可以拆成三个字段。instruction 描述模型要完成什么任务;input 提供完成任务所需的附加材料,可以为空;response 则给出希望模型学习生成的目标答案。
| 字段 | 职责 | 示例内容 |
|---|---|---|
| instruction | 定义任务和约束 | 将下面句子翻译成英文 |
| input | 提供待处理上下文 | 今天天气很好。 |
| response | 给出目标输出 | The weather is nice today. |
这里的重点不是字段名本身。真正送入模型前,这些信息通常会按照某种模板拼成一段 token 序列;对话模型还可能使用 system、user、assistant 等角色标记。只要序列化规则明确且训练与推理保持一致,就能承担相同作用。
样本怎样变成监督信号
模型读取序列时仍然执行逐 token 的下一词预测。与普通连续文本训练不同,指令微调需要明确哪些 token 是条件,哪些 token 是希望模型学会生成的目标。在常见的 response-only 训练中,instruction 和 input 提供上下文,而损失主要计算在 response 对应位置。
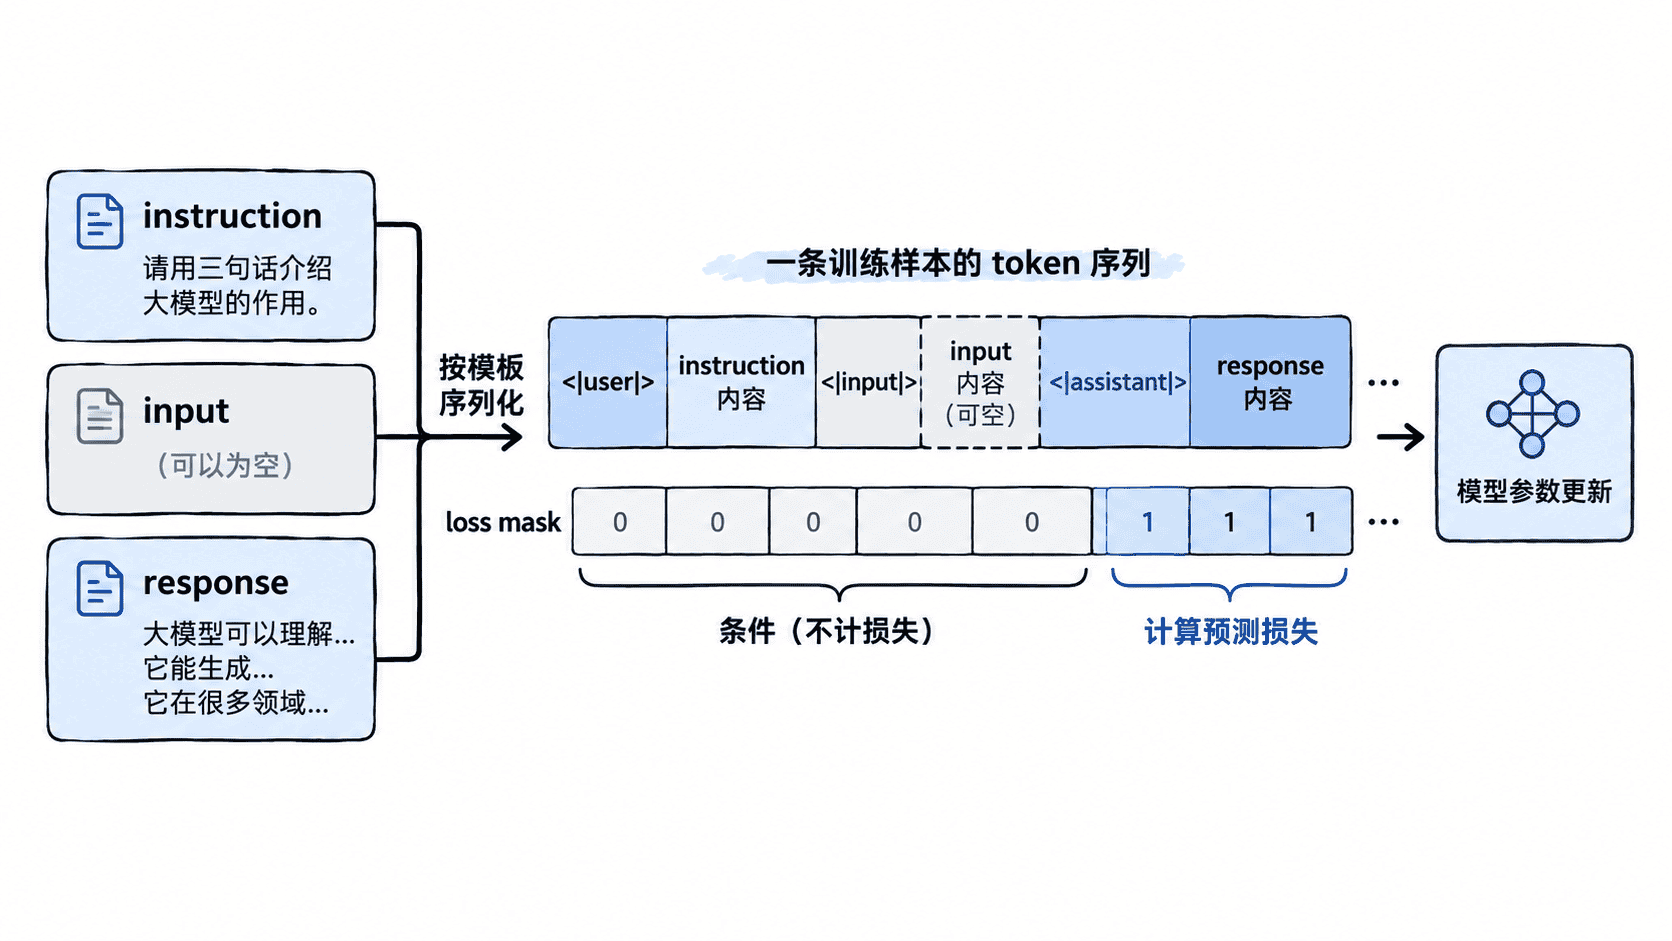
这种设计让模型反复学习同一种条件关系:先理解任务与上下文,再生成符合示范的答案。也存在对整段序列计算损失的训练方式,因此“只训练 response”不是所有实现的强制规则;真正重要的是训练方案必须明确监督区域,并与希望塑造的行为一致。
模板质量会改变模型学到的行为
如果训练样本的模板稳定,模型更容易识别哪里是用户请求、哪里是上下文、哪里应开始回答。反过来,角色标记混乱、分隔符不一致或训练模板与推理模板明显不同,都可能让模型在部署时出现多输出提示词、角色混淆或无法正确结束回答等问题。
内容质量同样重要。response 如果经常忽略 instruction 中的格式约束,模型学到的就是“约束可以被忽略”;如果样本答案冗长,即使任务只要求简短回答,模型也会逐渐形成偏长的输出习惯。监督微调实际上是在用示范定义“什么样的回答值得模仿”。
任务分布决定模型擅长什么
模型不会因为见过少量指令样本就自动获得均衡的通用指令能力。如果训练集中大多数样本都是摘要,模型会更熟悉摘要式响应;如果几乎没有结构化输出、拒答或多轮上下文任务,这些行为就缺少直接监督。
因此,构建数据集时不仅要检查单条样本是否正确,还要观察整体任务分布:任务类型是否覆盖目标场景、难度是否有层次、输出长度是否过度集中、不同格式要求是否足够多样。数量很大的重复任务并不能替代有代表性的覆盖。
高质量指令微调数据最终要同时回答两个问题:单条样本是否准确示范了期望行为,以及整批样本是否代表模型未来真正要处理的任务分布。 前者决定示范是否正确,后者决定模型把有限的微调能力重点塑造在哪里。