
大模型原理与训练 / 系统课时
把主干改成 Decoder-only
把主干改成 Decoder-only
GPT 的主干可以看成一次结构上的减法:移除独立 Encoder 和交叉注意力,让所有上下文进入同一条因果序列,再堆叠 Transformer Block 完成预测。本篇沿着一次前向计算走完整条链路,明确嵌入、Block、归一化与语言模型头分别负责什么。
学习目标
- 画出 Decoder-only 从 token 输入到 logits 输出的完整主链路
- 解释为什么 GPT 只需要因果自注意力而不需要交叉注意力
- 说明 Transformer Block、最终归一化和语言模型头之间的职责边界
从序列输入到隐藏表示
GPT 接收的是一串 token ID。模型首先把离散 ID 映射成连续向量,并加入位置信息,使同一个 token 出现在不同位置时能够得到不同的上下文表示。
随后,整条序列直接进入一组重复堆叠的 Transformer Block。这里没有“先经过 Encoder,再把 Encoder 输出交给 Decoder”的第二条支路,提示词、历史上下文以及训练时的目标前缀都存在同一条主干上。
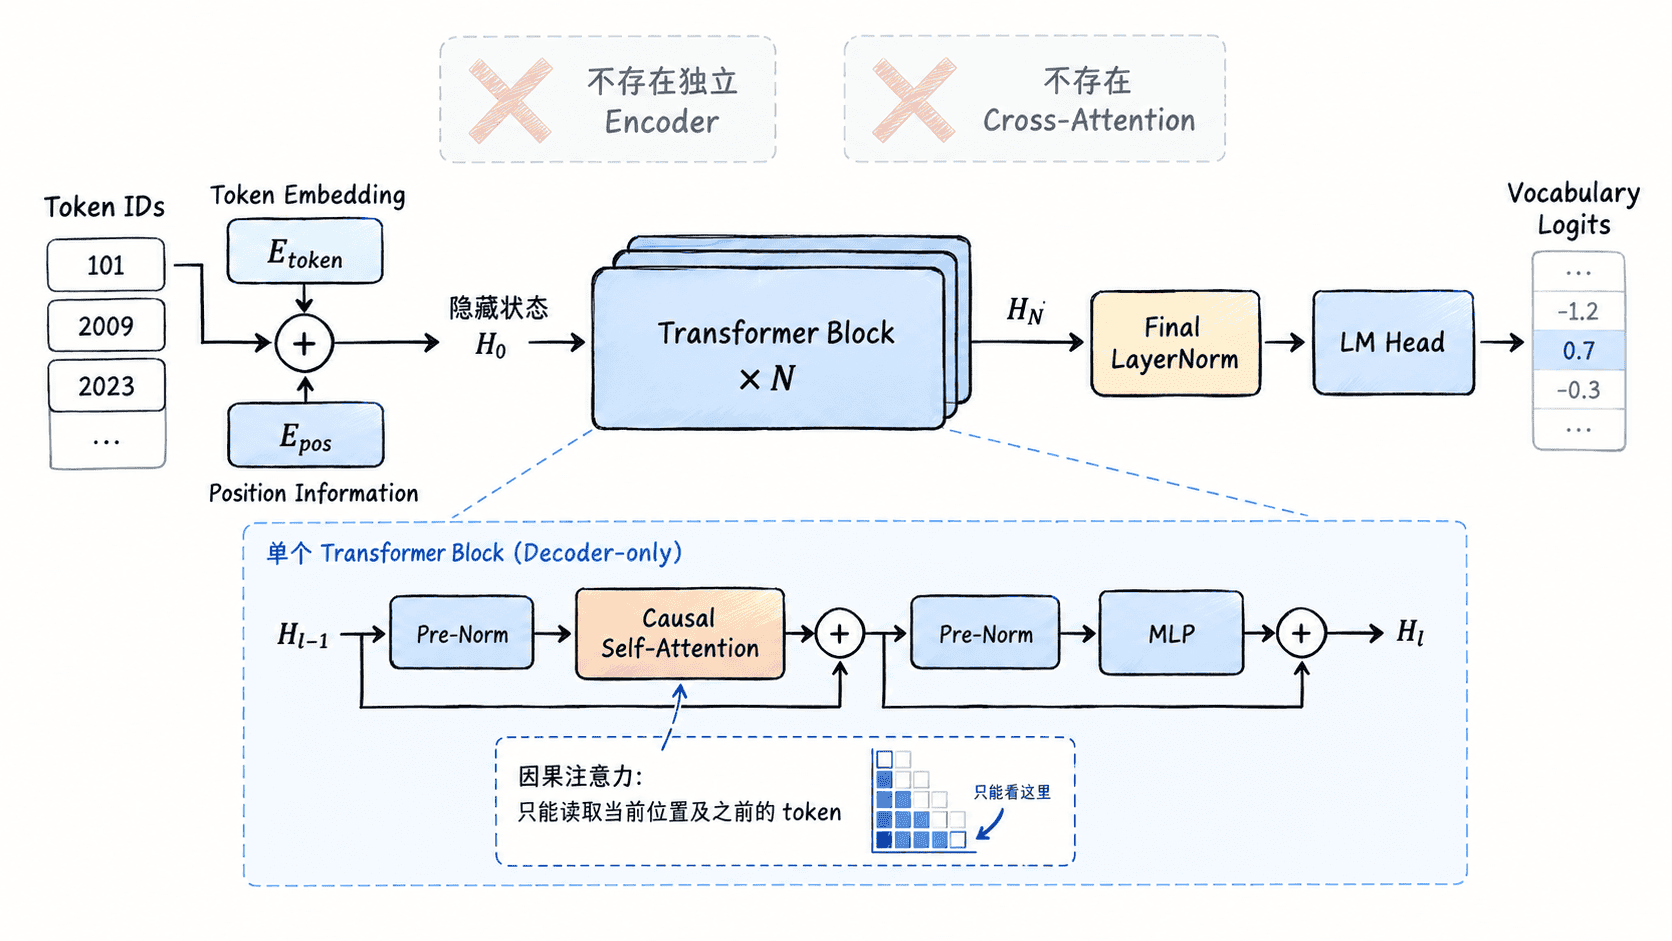
这张图中的主链路可以概括为:输入 token → 嵌入表示 → 多个 Decoder-only Block → 最终归一化 → 语言模型头 → 词表 logits。GPT 的大部分计算量都集中在中间重复堆叠的 Block 中。
Block 只保留因果自注意力
经典 Transformer Decoder 通常含有两种注意力:对目标序列自身执行的因果自注意力,以及读取 Encoder 输出的交叉注意力。GPT 删除 Encoder 后,交叉注意力失去了输入来源,因此整个 Block 只需保留因果自注意力与前馈网络。
因果掩码让位置 只能读取位置 到 。例如序列已经包含“机器 学习 很”,计算“很”所在位置的表示时可以利用前面的“机器”和“学习”,但不能读取尚未作为上下文出现的未来 token。
这种限制正好对应语言模型的目标:根据已有前缀预测下一个 token。训练时可以一次把整段序列送入模型并并行计算多个位置,只要注意力掩码保证每个位置没有偷看未来即可。
残差与归一化维持深层信息流
每个 Block 不只是“注意力加 MLP”。注意力子层负责让不同历史位置交换信息,MLP 则在每个位置上独立进行非线性特征变换;残差连接让新计算结果与原隐藏状态相加,使深层网络仍能保留并传递已有信息。
现代 GPT 类模型常采用 Pre-Norm 形式,即在注意力或 MLP 之前进行归一化。具体实现会因模型家族而异,但理解主干时可以抓住不变关系:注意力负责跨 token 混合,MLP 负责位置内变换,残差负责保留主信息通路。
经过最后一个 Block 后,通常还会有一次最终归一化。它不是新的注意力层,而是在隐藏状态送入输出层之前整理数值尺度,使后续词表预测建立在稳定的表示上。
语言模型头把表示变成词表分数
主干输出的每个位置仍然是隐藏向量,不能直接表示“下一个 token 是什么”。语言模型头会把隐藏维度投影到词表维度,为词表中的每个 token 产生一个 logit。
如果词表大小为 50,000,那么每个序列位置最终都会得到 50,000 个分数。训练时,这些分数与该位置应该预测的真实下一个 token 计算损失;生成时,则只需要取当前序列最后一个位置的 logits,再按照贪心、采样或其他解码策略选择下一个 token。
一些 GPT 实现会让输入 Token Embedding 与输出语言模型头共享权重,这叫权重绑定。它能够减少参数量,但属于实现选择,并不是判断 Decoder-only 架构的必要条件。
为什么单一主干足够生成文本
Decoder-only 的关键不是简单地“少了一半 Transformer”,而是把原来可能分开的输入与输出信息统一成一个因果序列。对话里的系统提示、用户问题、模型已经生成的回答,都可以按照顺序排列在同一上下文中,由同一组 Block 反复处理。
因此,判断一个 GPT 式主干时应抓住三条结构特征:只有一条 token 信息流;Block 内使用因果自注意力而没有读取独立 Encoder 的交叉注意力;最后通过语言模型头把隐藏状态映射成下一 token 的词表分数。沿着这条链路,就能继续理解 GPT 的训练目标和逐 token 生成过程。