
大模型原理与训练 / 系统课时
解释 GPT 为何能连续生成
解释 GPT 为何能连续生成
GPT 每次前向计算本质上只预测下一个词元,但把新词元不断追加回上下文,就能形成连续文本。本篇把单步预测串成完整生成循环,并解释停止条件、上下文回填以及生成偏离为何会逐步放大。
学习目标
- 说明单步下一词元预测如何组成自回归生成循环
- 理解生成词元回填上下文后如何影响后续预测
- 区分正常随机变化与由早期偏离引起的误差累积
从一次预测变成连续生成
给定已有词元 ,GPT 计算下一个词元的条件分布 。从这个分布中选出一个词元后,生成过程并没有结束,而是把它追加到原序列,再执行下一次预测。
因此,连续生成可以概括为一个循环:读取当前上下文、预测下一个词元、选择词元、追加到上下文、检查是否停止,然后再次执行模型。模型并不是一次性规划出整个回答。
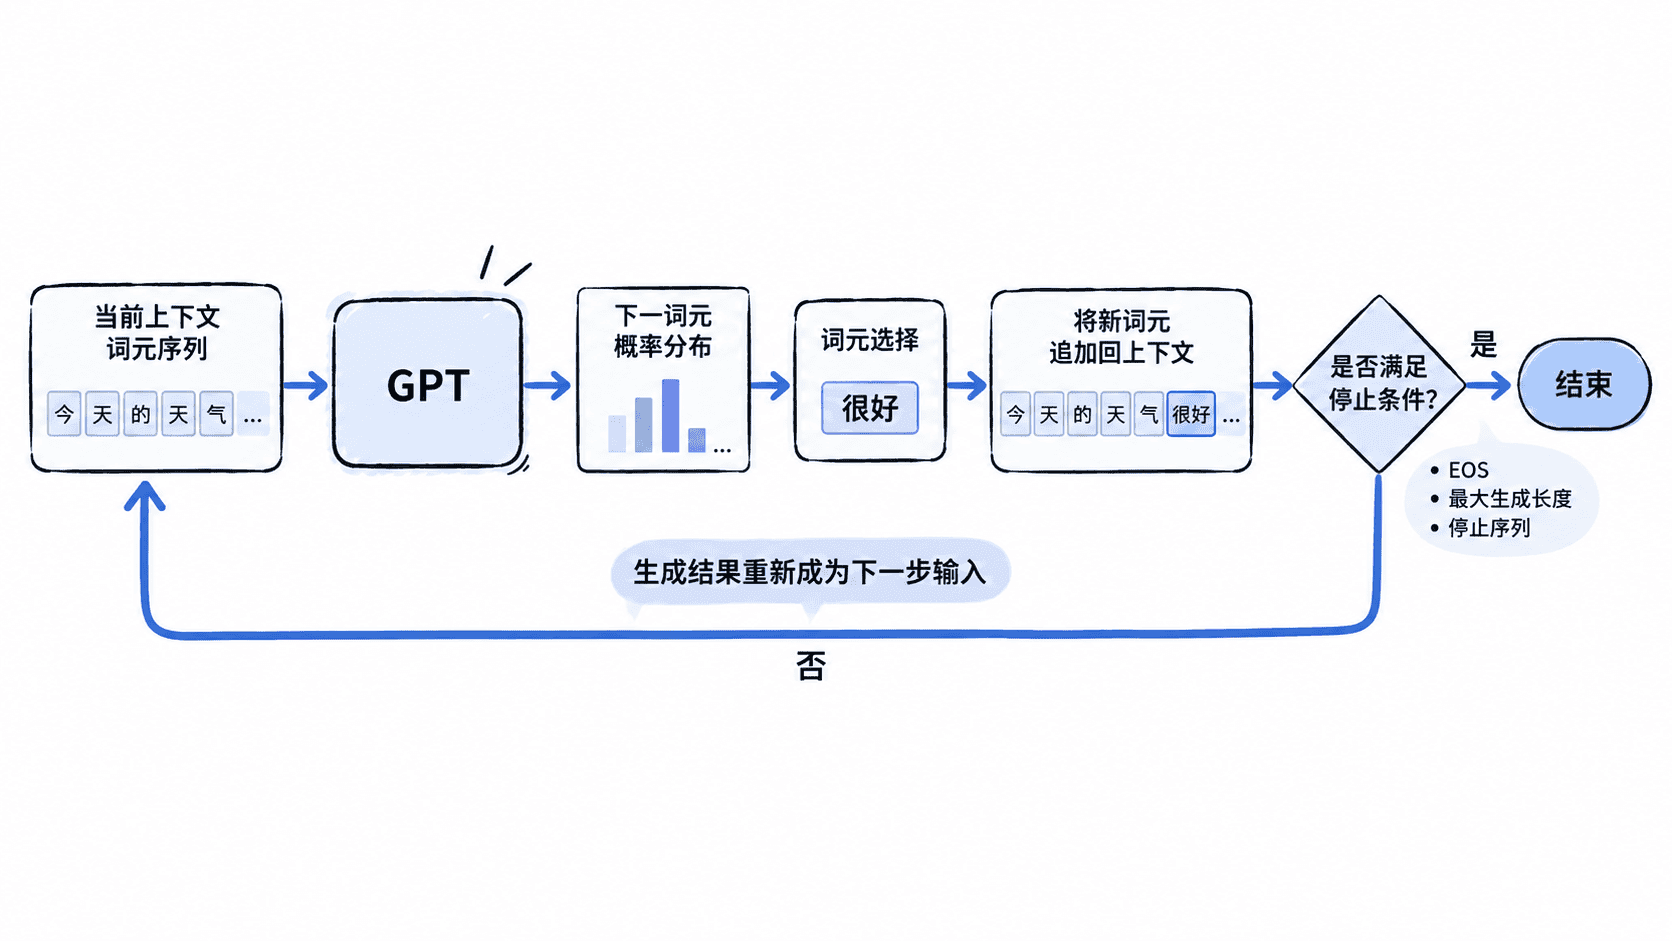
假设提示词编码后得到上下文 A,模型先选择词元 B,那么第二次前向计算看到的已经是 A+B;若随后选择 C,第三次看到的就是 A+B+C。每一步的条件概率都依赖此前已经接受的全部可见词元。
| 生成轮次 | 模型可见上下文 | 本轮产出 |
|---|---|---|
| 1 | A | B |
| 2 | A + B | C |
| 3 | A + B + C | D |
上下文回填改变后续概率
新词元一旦被接受,就会成为后续预测的条件。哪怕模型参数完全不变,只要历史词元不同,下一步的概率分布就可能明显改变。这也是同一个开头能够沿不同路径继续生成的根本原因。
实际推理通常会使用 KV Cache,避免每轮都重新计算全部历史位置的注意力键和值。它改变的是计算效率,不改变自回归语义:第 个词元仍然以此前可见词元为条件。
当累计上下文达到模型允许的上下文窗口上限时,推理系统必须停止、截断较早内容,或者采用应用层自己的上下文管理策略。被移出有效窗口的信息不会继续以原始词元形式参与后续预测。
生成在什么条件下停止
最自然的停止信号是模型生成预定义的结束词元 EOS。除此之外,推理程序通常还会设置最大新增词元数,防止模型长时间持续生成;应用也可以在检测到指定停止序列时提前结束。
这三个条件解决的问题不同:EOS 是模型学到的结束信号,最大长度是外部安全边界,停止序列则由具体应用协议决定。模型即使没有主动生成 EOS,也可能因为达到外部限制而结束。
为什么早期偏离会逐步放大
训练时,模型通常在真实语料提供的正确历史词元上学习下一词元预测;推理时,它看到的历史却包含自己刚刚生成的内容。于是某一步一旦选择了不理想的词元,下一步就会在这个新上下文上继续预测。
例如原本高质量路径可能是 A→B→C,而一次采样选择了概率稍低的 D,后续计算就变成基于 A→D,而不是重新回到 A→B。随着生成继续,语义、事实或格式都可能越来越偏离原来的高概率路径。
这不意味着所有分叉都是“错误”。开放式文本本来就可能有多个合理续写,采样也正是为了保留多样性。真正需要关注的是:早期产生的不合理内容会进入后续条件,因此模型没有独立于历史自动纠正全部偏差的保证。
把连续生成看成受控循环
理解 GPT 生成时,最重要的心智模型不是“一次预测一整段文字”,而是“单步预测反复执行”。每轮只决定新的一个词元,新词元立即写回上下文,直到 EOS、停止序列或长度限制终止循环。
因此,连续文本的连贯性来自同一套下一词元预测能力被反复调用;生成路径的差异和误差累积,也都可以追溯到同一个事实:模型下一步所看到的上下文,包含了它此前自己的选择。