
大模型原理与训练 / 系统课时
用去重过滤控制数据质量
用去重过滤控制数据质量
预训练语料不是“越多越好”。重复页面会放大记忆倾向,低质文本会浪费计算,评测污染会让指标失真,敏感内容还会带来安全与合规风险。本篇给出一条可落地的数据质量控制链路,帮助你理解各类过滤分别解决什么问题。
学习目标
- 区分重复、低质、污染与敏感数据造成的不同训练风险。
- 理解精确去重、近似去重、质量过滤与污染检测的基本思路。
- 能按“先廉价过滤、再高成本检测”的原则设计预训练语料处理流程。
先分清四类问题
重复数据指相同或高度相似的内容被多次收录。网页镜像、转载、分页归档和模板页面都会制造重复。它会让少量样本获得异常高的训练权重,增加逐字记忆风险,并降低新增 token 带来的有效信息量。
低质数据不一定重复,但信息密度低或格式噪声高,例如乱码、导航菜单、关键词堆砌、机器生成的垃圾页面和只有极少正文的页面。继续训练这些 token 会消耗算力,却很难提升泛化能力。
污染数据通常指训练集包含本应独立评测的数据,例如公开 benchmark 的题目、答案或其改写版本。模型见过测试题后,评测分数可能虚高,因此污染控制解决的是“评测是否可信”,而不仅是文本质量。
敏感数据包括个人身份信息、密钥、账号凭据、受限制内容等。它们需要在数据进入训练前被识别、删除或脱敏,处理目标是降低隐私、安全和合规风险。
把过滤做成分层流水线
不同检测手段的成本差异很大。工程上通常不会一开始就对所有文本运行昂贵模型,而是先用廉价规则缩小数据规模,再对剩余内容执行近似匹配和语义级判断。
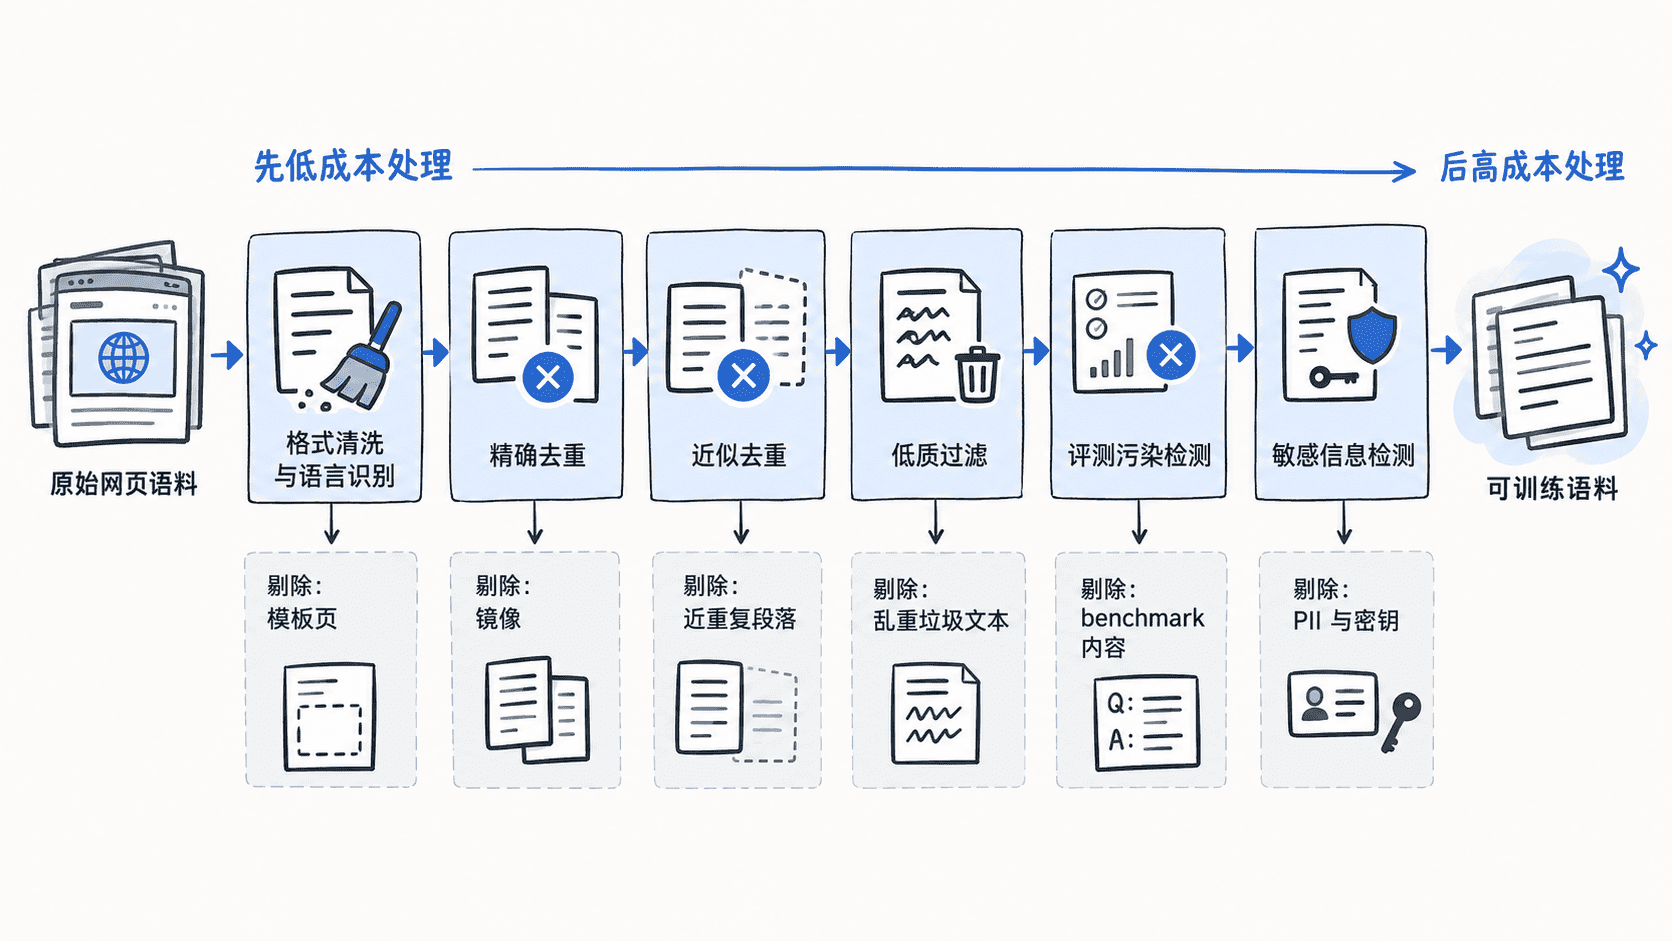
第一层通常做编码、HTML 残留、异常长度、语言等基础清洗;第二层用内容哈希删除完全相同的文档;第三层再用 MinHash、局部敏感哈希或向量相似度处理近似重复。质量分类器、污染检测和敏感信息识别成本更高,适合放在后面。
去重不是只比较字符串
精确去重最简单:先规范化文本,再对内容计算哈希,相同哈希只保留一份。它便宜、确定性强,但只能抓住完全一致或规范化后完全一致的样本。
近似去重则处理“内容基本相同,但标题、顺序、少量词句不同”的情况。常见做法是把文档切成 n-gram 或 shingles,计算集合签名,再用 MinHash 或局部敏感哈希寻找高相似候选。阈值越低,召回的近重复越多,但误删独立内容的风险也越高。
去重还要避免跨集合泄漏。训练集与验证集、测试集之间应单独做相似度检查,尤其是公开题库、代码评测和问答 benchmark。只在训练集内部去重,无法发现测试样本已经出现在训练语料中的问题。
质量过滤要看信号组合
单一规则通常不可靠。短文本不一定低质,长文本也不一定高质,因此更稳妥的做法是组合多个信号,例如正文比例、字符分布、重复率、语言置信度、异常符号比例以及分类器得分。
阈值也不是越严格越好。过度过滤会把少数语言、口语表达、代码片段或特定领域文档一起删掉,使训练分布变窄。合理做法是先在抽样数据上查看“被删掉的是什么”,再根据错误类型调整规则,而不是只看最终保留比例。
用统计而不是直觉验收
过滤完成后至少检查三组指标:数据规模变化、重复率变化和样本分布变化。还应对每个过滤阶段做人工抽样,确认被删除样本确实大多属于目标问题,并观察语言、来源、领域等分布是否被意外扭曲。
真正有效的数据治理不是追求“最干净”的语料,而是在信息量、覆盖面、隐私安全和评测可信度之间取得可解释的平衡。对大规模预训练而言,知道每一步删掉了什么、为什么删,比单纯把过滤阈值调得很高更重要。