
大模型原理与训练 / 系统课时
看懂注意力为何需要 QKV
看懂注意力为何需要 QKV
注意力要解决的不是“把上下文平均一下”,而是让当前位置主动判断:我现在需要什么、哪些位置与我相关、真正要取回什么信息。Q、K、V 正是把这三个职责拆开,让相关性计算与信息聚合可以分别学习。
学习目标
- 解释 Query、Key、Value 在注意力中的不同职责
- 按“Q 与 K 匹配 → 权重归一化 → V 加权聚合”复述注意力流程
- 理解为什么同一个词元需要投影成三类不同向量
从一次检索理解 QKV
可以把注意力看成一次“带权检索”。当前位置先拿着一个查询去问上下文:“谁最可能提供我需要的信息?”每个候选位置提供一个用于匹配的键,同时保留一份真正可被取回的内容。
因此,三种向量的角色可以这样区分:
| 向量 | 回答的问题 | 在计算中的职责 |
|---|---|---|
| Q(Query) | 我现在想找什么? | 代表当前目标位置的检索需求 |
| K(Key) | 我这里有什么特征可供匹配? | 与 Q 计算相关性分数 |
| V(Value) | 如果选中我,应取回什么? | 按注意力权重参与最终聚合 |
在自注意力中,Q、K、V 都来自同一批输入表示,但经过不同的可学习线性投影。它们不是三份不同的词元,而是同一个位置在三个不同职责下的表示。
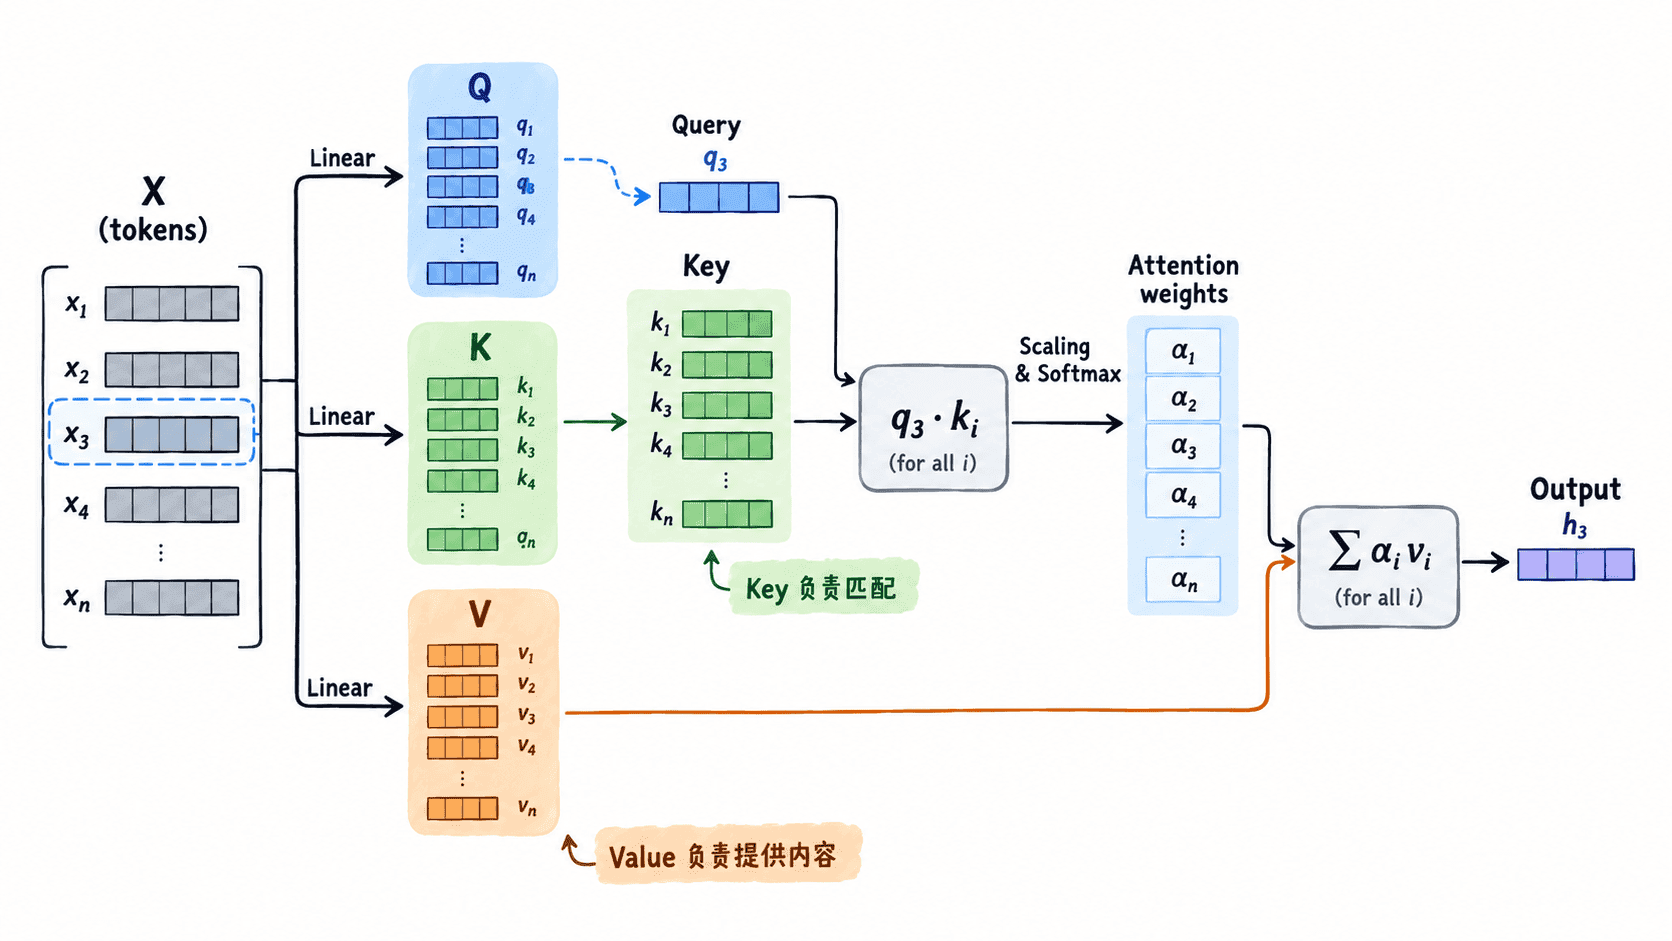
相关性如何变成上下文
对目标位置 和候选位置 ,先计算 Query 与 Key 的缩放点积:
其中 是 Key 的维度。除以 ,是为了避免维度增大后点积幅度过大,使 Softmax 过早进入接近 0 或 1 的极端区域。
随后,对同一个 Query 对应的全部分数做 Softmax,得到权重 。这些权重均为非负数,并且同一行之和为 1。最终输出是所有 Value 的加权和:
这条公式揭示了 QKV 最重要的分工:Q 与 K 决定取多少,V 决定取什么。K 本身不会直接成为最终聚合内容,它只参与计算相关性。
为什么匹配和内容要分开
如果同一个向量既承担“用于匹配”的职责,又承担“被取回内容”的职责,模型就必须让同一表示同时适合比较相关性和传递信息。这两个目标并不总是一致。
把 K 与 V 分开后,模型可以分别学习“怎样更容易被正确找到”和“被找到以后应该提供什么”。Q 单独投影也同样重要,因为不同目标位置即使面对同一段上下文,也可能正在寻找完全不同的信息。
例如,同一个词元可以对某个 Query 非常相关,对另一个 Query 几乎无关。注意力不是给每个词元预先固定一个重要性,而是由当前 Q 与所有 K 的组合动态计算权重。
不要把 QKV 误解成三份输入
Q、K、V 的本质是角色分工,而不是简单复制三遍输入。若输入矩阵为 ,单头自注意力中常写成 、、,其中三个投影矩阵都通过训练学习。
还要区分“注意力权重”和“输出表示”:权重只表示各候选位置应占多大比例,真正送往后续网络的是各个 V 按这些比例聚合后的结果。抓住“Q 提问、K 匹配、V 提供内容”这条链路,再理解多头注意力时,就可以把它看成多个子空间中的 QKV 检索并行发生。