
机器学习与深度学习 / 系统课时
概率与随机性
概率与随机性
模型面对的往往不是确定答案,而是在有限信息下判断各种结果出现的可能性。理解概率、条件概率和随机变量,可以帮助你正确解读分类概率、风险分数和带随机性的预测结果,而不是把模型输出误认为绝对结论。
学习目标
- 理解概率如何量化不确定性,并能解释基本概率值
- 掌握条件概率表达的信息更新过程
- 理解随机变量如何把随机结果转换为模型可以计算的数值
用概率描述不确定结果
概率用 0 到 1 之间的数表示事件发生的可能程度。事件 的概率记作 :接近 0 表示较不可能,接近 1 表示较可能。概率 1 称为几乎必然。在连续均匀模型中,恰好取到 0 的概率为 0,但 0 仍是取值范围中的点。概率 0 与逻辑不可能须区分。
例如,一个二分类模型对某条记录输出“属于正类的概率为 0.8”,含义不是这条记录有 80% 的部分属于正类,而是模型根据当前输入和自身参数,把正类分配了 0.8 的概率质量。
互补事件满足:
因此,如果模型只考虑“正类”和“负类”两个互斥结果,并给出 ,那么对应的 。
条件概率表示获得信息后的变化
现实预测通常带有条件。我们关心的不是一个用户总体上是否流失,而是在已经观察到登录频率、消费记录等特征之后,他流失的概率。这种关系写作 ,读作“在 B 已发生的条件下 A 的概率”。
当 时:
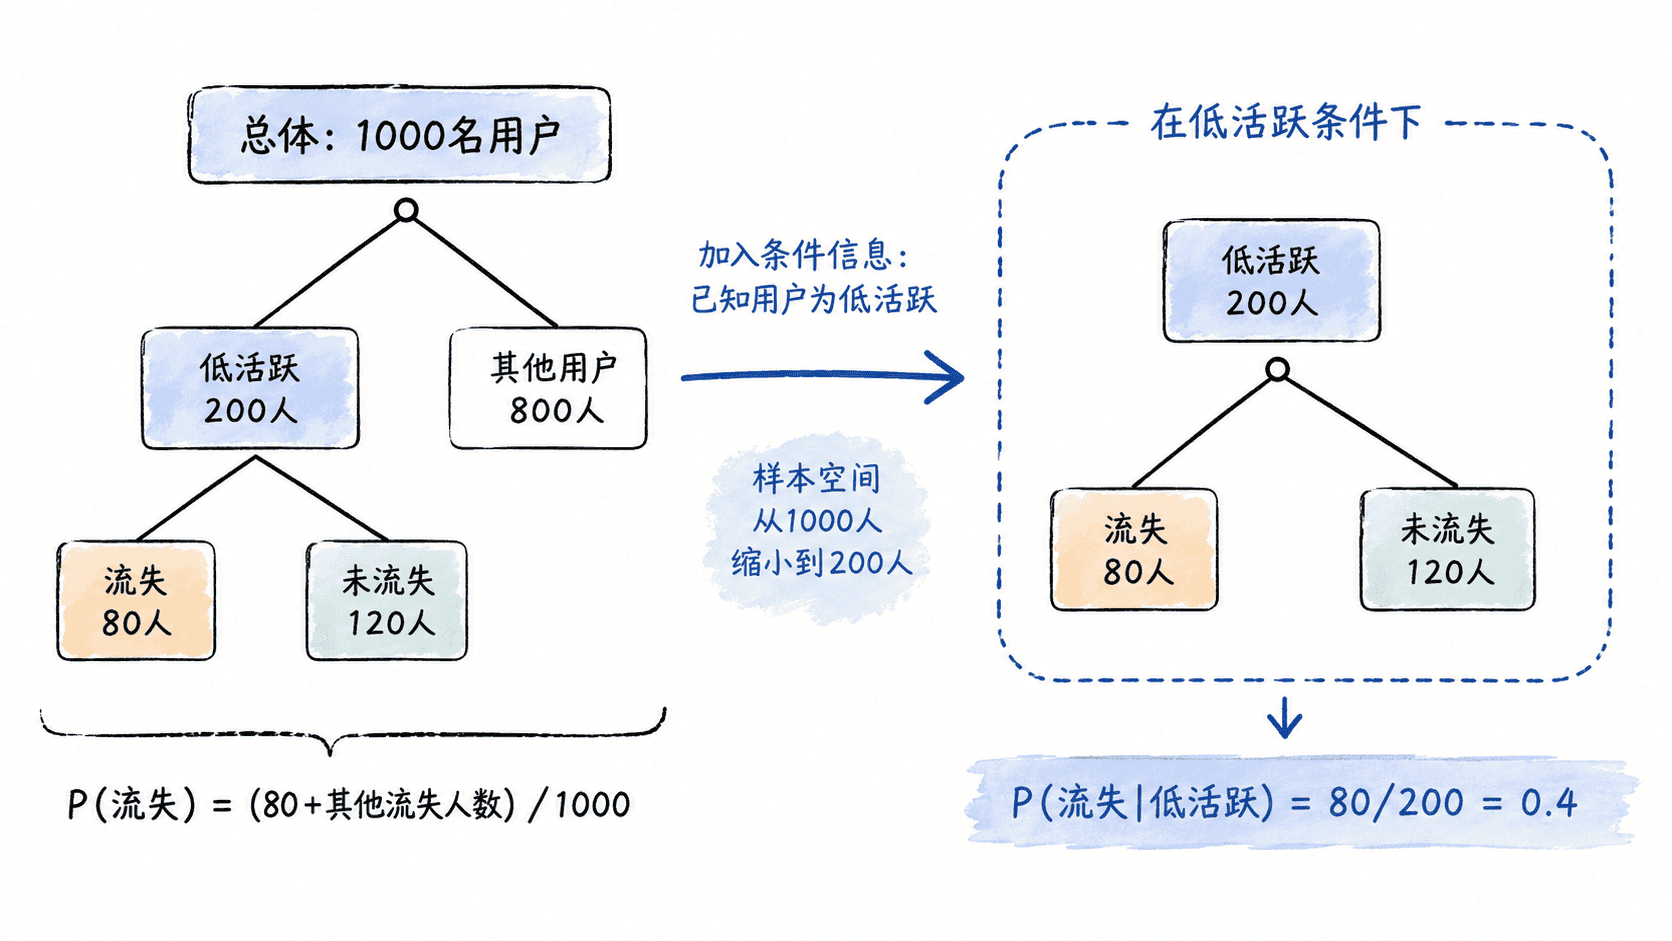
假设 1000 名用户中有 200 人属于低活跃用户,其中 80 人最终流失。那么在“低活跃”这一条件下,流失概率为:
这 0.4 是该批记录的条件频率。总体条件概率是否也约为 0.4,要看样本来源、样本量和时间稳定性。若全体共有 120 人流失,那么反过来的“流失者中低活跃”是 80/120,不是 80/200。
from fractions import Fraction

def conditional(intersection, condition):
    if condition <= 0 or not 0 <= intersection <= condition:
        raise ValueError("条件计数必须为正且包含交集计数")
    return Fraction(intersection, condition)

low, both, total_churn = 200, 80, 120
print("流失 | 低活跃:", conditional(both, low))
print("低活跃 | 流失:", conditional(both, total_churn))
print("总体流失:", conditional(total_churn, 1000))
依次得到 2/5、2/3、3/25。条件计数为 0 时,这个离散比值没有定义。机器学习模型本质上经常在近似这种条件关系,例如根据输入特征 估计 。
随机变量把结果映射成数值
随机变量不是“值随便变化的变量”,而是把随机试验的结果映射为数值的规则。比如把“用户是否流失”定义为随机变量 :流失取 1,不流失取 0,那么 就是一个二值随机变量。
若 、,它的期望为:
对于这种只取 0 和 1 的变量,期望正好等于取值为 1 的概率。这也是二分类任务中概率输出与标签变量之间能够自然对应的原因之一。
图像类别可以用猫、狗、鸟等状态记录。要按实值随机变量的定义处理,可给状态编码或为每个类别建立 0/1 指示变量。编码编号的均值通常没有语义,不要把类别编号当作有序数值。
从预测概率到最终决策
概率输出和最终决策是两层不同的问题。模型可能给出 ,业务系统再使用阈值决定是否判为正类。如果阈值是 0.5,则判为正类;如果高风险操作要求阈值达到 0.9,则同一个概率不会触发动作。
因此,模型估计的概率描述标签在给定输入下的分配,可能未校准,也不等同于模型对自身误差的估计。阈值属于决策层,需用实际代价和适用范围另行确定。不同错误代价、业务目标和风险容忍度,都可能要求不同阈值。
理解概率后,可以把模型预测看成“在已有信息条件下,对随机结果分配概率”,而不是把每个输出都理解成确定事实。这一视角是继续学习损失函数、统计推断和概率模型的基础。