
机器学习与深度学习 / 系统课时
人工智能的发展历程
人工智能的发展历程
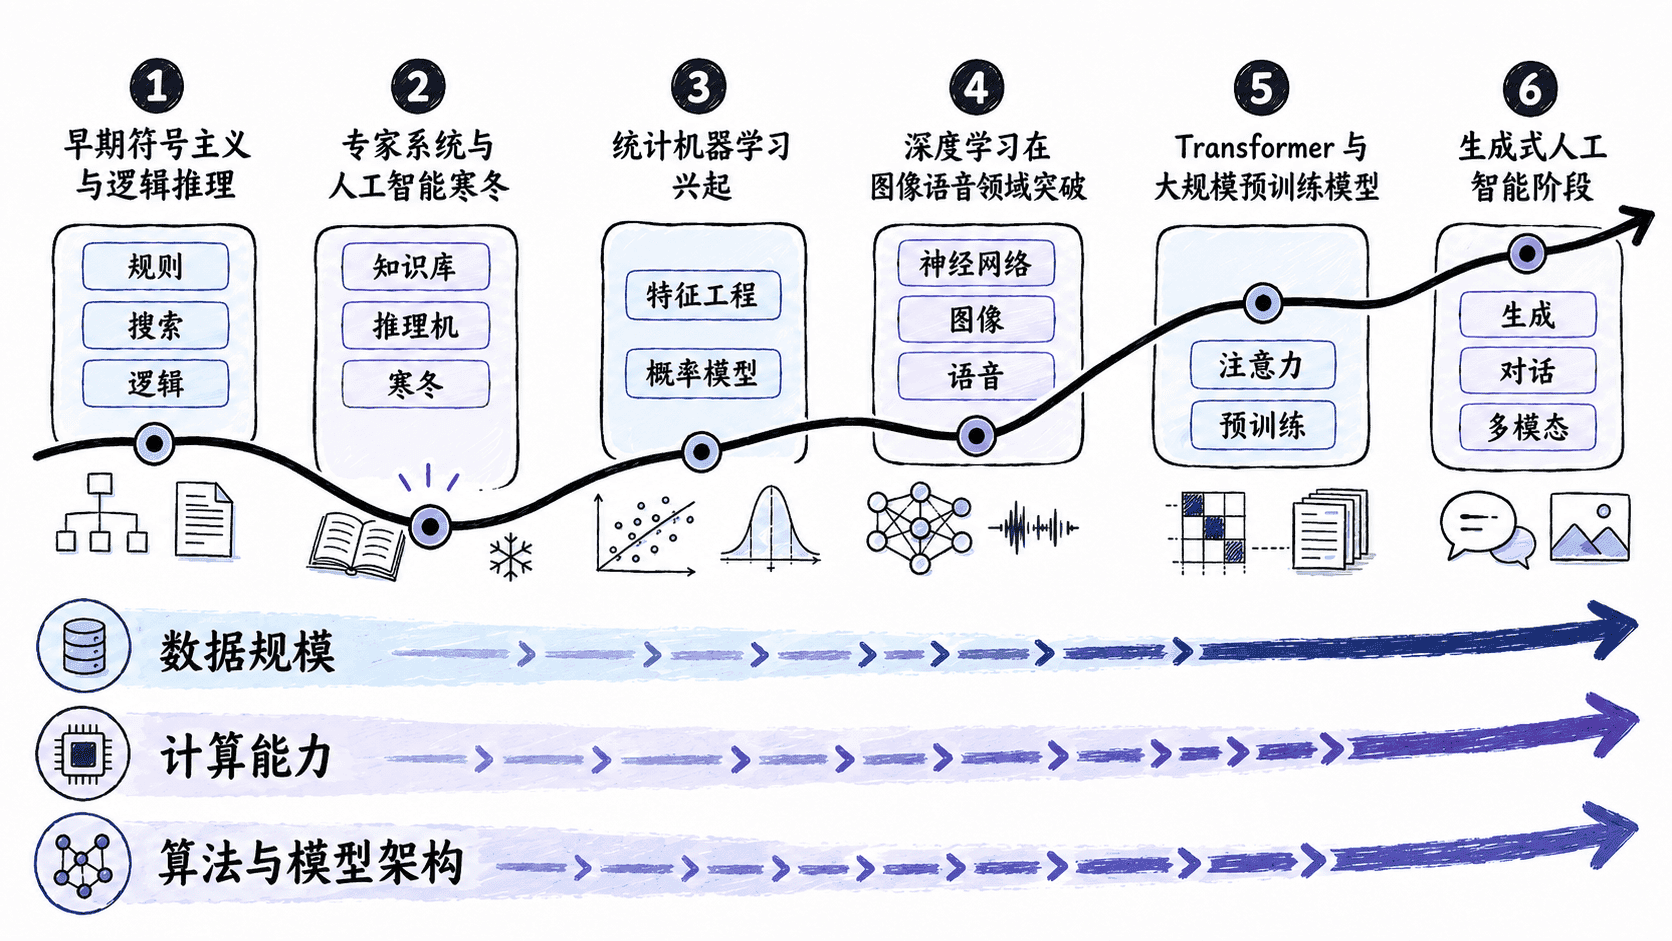
人工智能的发展并不是一条持续上升的直线。不同阶段曾先后把希望寄托在人工规则、统计学习和深度神经网络上,又多次受到算力、数据和工程条件限制。理解这些转折,有助于看清今天的生成式人工智能从何而来。
学习目标
- 识别人工智能发展中的几个主要技术阶段
- 理解符号主义、机器学习与深度学习的核心差异
- 说明数据、算力和算法为何会共同推动技术突破
用几项可核对的工作定位历史
| 年代 | 工作 | 看它解决了什么 |
|---|---|---|
| 1950 | 图灵讨论模仿游戏 | 用可操作的交互问题代替宽泛的机器思考定义 |
| 1955/1956 | 达特茅斯项目提案与次年研讨 | 1955 年提出项目,1956 年召开;AI 逐渐形成研究领域 |
| 2012 | AlexNet 图像分类论文 | 说明深层卷积、GPU 训练与大规模标注图像的组合价值 |
| 2017 | Transformer 论文 | 用注意力架构做机器翻译;原论文任务不能替代现代模型能力评估 |
| 2020 | GPT-3 论文 | 比较以提示和少量示例适配多项文本任务的表现和局限 |
这些工作不是互相取代的阶段。符号搜索、统计模型和神经网络长期并存,许多系统会混合使用。
从人工规则开始
早期人工智能研究的重要方向是符号主义。研究者尝试把知识写成符号、事实和规则,再让计算机利用逻辑推理得到结论。国际象棋程序、定理证明和专家系统都曾是这一思路的代表应用。
这种方法在规则清楚、知识范围有限的任务上很有效。例如,如果系统已经拥有完整的诊断规则,就能按系统已表达的事实与规则推出候选结论。覆盖范围和证据质量仍决定结论能否使用。问题在于,现实世界存在大量例外和模糊情况,知识也很难全部由专家手工录入和长期维护。
当早期期望远高于实际能力,而计算资源、数据规模和工程基础又无法支撑复杂应用时,人工智能研究经历过投资和关注下降的时期,通常被称为“人工智能寒冬”。这说明技术进步不仅取决于一个好想法,还受到现实条件约束。
机器学习让系统从数据中学习
随着数字数据不断积累,研究重点逐渐从“把规则全部写给机器”转向“让机器从样本中找到规律”。机器学习通过训练数据调整模型参数,使模型能够对没有见过的新样本进行分类、预测或排序。
垃圾邮件识别就是典型例子。开发者不必穷举所有垃圾邮件规则,而是准备大量已标记邮件,让模型学习哪些词语、结构和发送特征与垃圾邮件相关。以后收到新邮件时,模型根据这些统计模式给出判断。
这一转变扩大了人工智能能够处理的问题范围,但模型效果开始更加依赖数据质量。训练样本存在偏差、标签错误或与真实环境差异过大时,即使算法正确,最终结果也可能不可靠。
深度学习推动感知能力突破
深度学习属于机器学习,其核心工具是具有多层结构的神经网络。随着大规模数据、图形处理器等计算资源以及训练方法不断成熟,深度学习在图像识别、语音识别和自然语言处理领域取得了显著进展。
与许多早期机器学习方法相比,深度神经网络能够直接从原始数据中学习更复杂的内部表示。例如,某些图像网络的较低层常响应局部边缘或纹理,较深层能结合更大范围信息,而不必完全依赖人工设计特征。
大模型改变了通用能力的组织方式
近年来,大规模预训练模型进一步改变了人工智能的应用方式。以 Transformer 架构为基础的语言模型可以先在海量数据上学习通用模式,再用微调更新参数,或用提示改变本次输入而不更新参数。这两种适配方式的成本、稳定性和复用范围不同。
这与过去“一个任务训练一个专用模型”的模式形成明显差异。同一个基础模型可以承担多种任务,并通过自然语言交互调用能力。生成式人工智能因此迅速进入搜索、办公、软件开发、设计和客户服务等场景。
不过,能力更通用并不意味着结果天然可靠。大模型仍可能生成错误事实、继承训练数据中的偏差,也无法仅凭流畅表达证明答案正确。因此,验证、约束和人类监督仍然是实际应用的一部分。
推动突破的三个条件
回顾发展历程可以发现,重要突破通常不是单一算法突然出现的结果。算法、数据和算力需要同时达到足够水平:更好的模型结构决定机器能学习什么,更丰富的数据提供学习材料,更强的计算资源则让大规模训练真正可执行。
这也解释了为什么某些思想会在提出多年后才产生巨大影响。一个方法在理论上成立,并不代表当时就具备训练数据、硬件性能和工程基础。今天的人工智能仍会受到同样规律影响:评估新进展时应看任务、训练成本、数据条件和工程约束,避免直接比较来自不同数据与评价口径的数字。