
机器学习与深度学习 / 系统课时
过拟合与正则化
过拟合与正则化
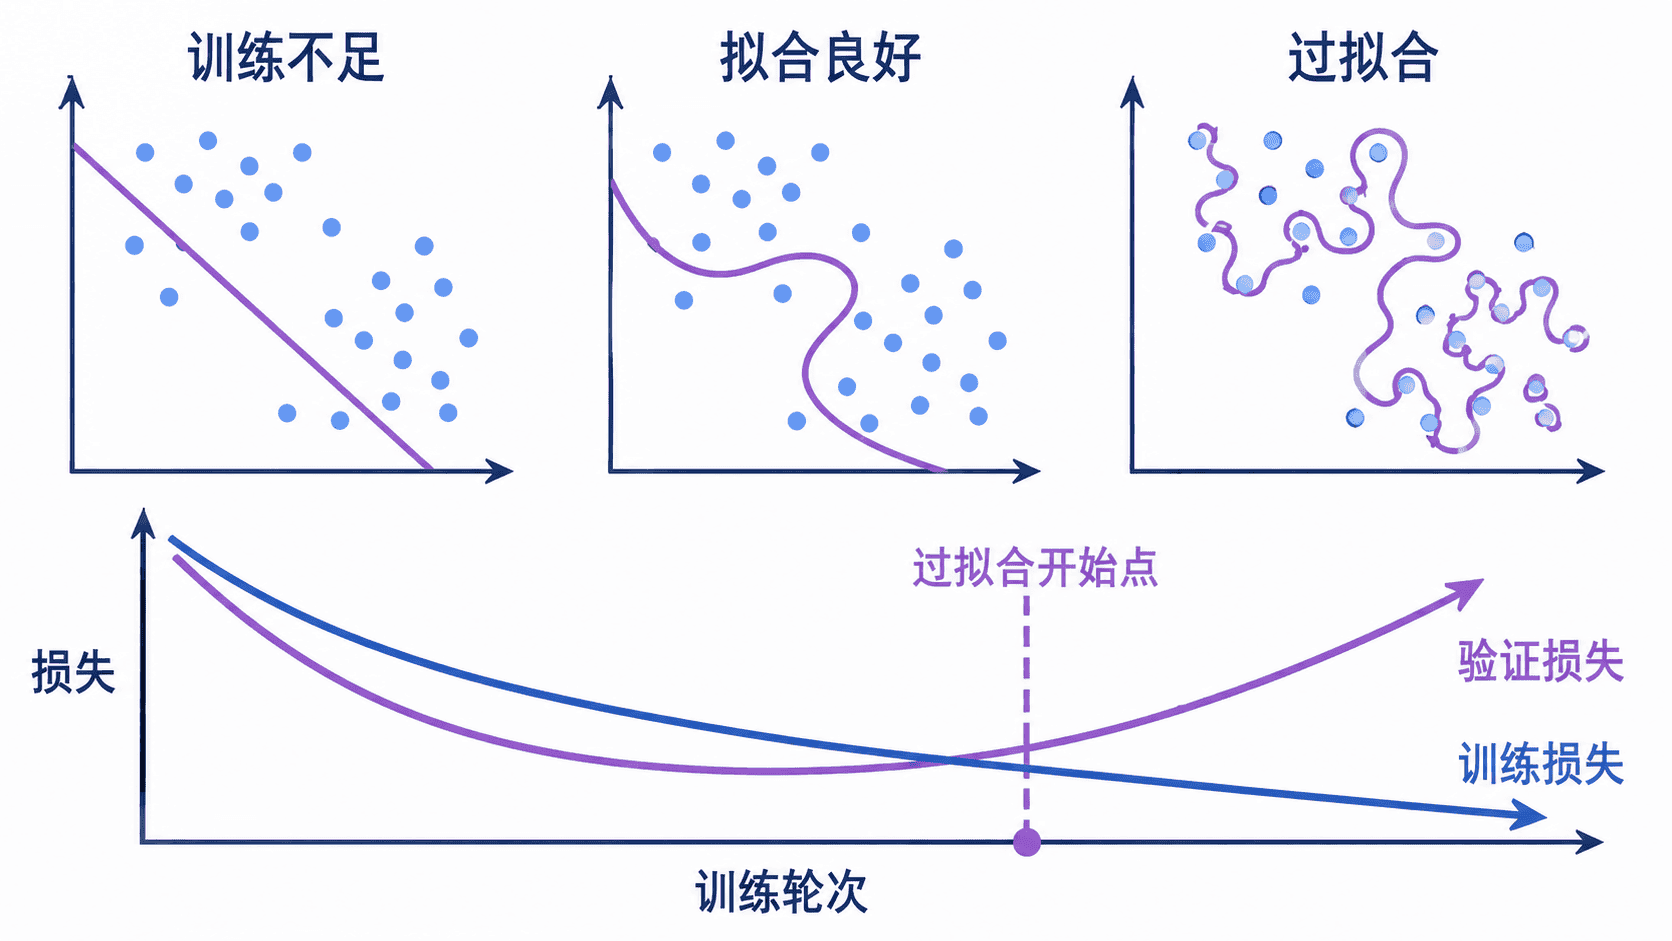
模型训练损失下降,说明它更符合当前训练样本。要判断能否泛化,还要在符合任务范围的独立验证数据上观察。先排查划分、标签与指标,再用可比较实验验证正则化是否有帮助。
学习目标
- 区分过拟合的信号与数据分布、划分或评估问题。
- 解释 L2、Dropout、数据增强和早停的作用与边界。
- 对同一批训练和验证数据实测模型容量与 L2 惩罚的影响。
怎样识别过拟合
典型信号是训练误差继续下降,代表目标环境的验证误差开始上升。模型可能在拟合训练噪声或偶然关系。若验证集来自新设备、后续时段或不同采样规则,也可能存在分布偏移,单看训练和验证的差距无法区分原因。先核对数据是否按实体或时间隔离,以及训练和验证指标是否在一致的评估模式和口径下计算。 Google 机器学习速成课程过拟合说明
常见缓解方法
| 方法 | 做法 | 实施检查 |
|---|---|---|
| L2 正则化 | 在数据损失上加 ,使大权重承担更大代价 | 明确是否惩罚偏置与损失是求和还是求平均。AdamW 的解耦权重衰减不能当作所有优化器中同一个 L2 项 |
| Dropout | 训练时随机令部分激活为零,PyTorch 会在训练时缩放保留值 | 调用 model.eval() 切到评估模式。torch.no_grad() 关闭梯度记录,但不会切换 Dropout 的模式 |
| 数据增强 | 只在训练数据上用保留任务标签的变换生成新输入 | 例如左右翻转会破坏方向识别的标签,应调整标签或避免该变换。先切分源样本,避免衍生样本跨集合 |
| 早停 | 监控验证指标,超过耐心轮数仍无足够改善时停止 | 记录最佳轮次并显式保存、恢复最佳检查点。停止时手里的参数可能来自更晚一轮 |
这些方法控制拟合程度,也可能压制有用信号。用固定验证流程比较,保留训练和验证的任务指标、样本数以及改动原因。 scikit-learn Ridge 目标 PyTorch Dropout 行为 PyTorch AdamW
可运行实验:高阶特征与 L2
九个训练标签来自直线加固定扰动,验证点是同一区间的另一组点,此处用已知直线作为合成验证标签。NumPy 示例比较一次多项式、八次多项式和带 L2 的八次多项式。矩阵中第一列是常数项,对应的偏置不受惩罚。代码用增广最小二乘求解平方误差和加 L2。选用平均平方误差作为评估口径,拟合中的惩罚系数按平方误差和约定。
python
import numpy as np


def design(x, degree):
    return np.vander(x, N=degree + 1, increasing=True)


def fit(x, y, degree, penalty=0.0):
    features = design(x, degree)
    regularizer = np.eye(degree + 1)
    regularizer[0, 0] = 0
    augmented_x = np.vstack((features, np.sqrt(penalty) * regularizer))
    augmented_y = np.concatenate((y, np.zeros(degree + 1)))
    return np.linalg.lstsq(augmented_x, augmented_y, rcond=None)[0]


def mse(x, y, weights):
    residual = design(x, len(weights) - 1) @ weights - y
    return np.mean(residual ** 2)


x_train = np.linspace(-1, 1, 9)
noise = [0.12, -0.15, 0.10, -0.08, 0.20, -0.18, 0.16, -0.12, 0.11]
y_train = 1 + 2 * x_train + noise
x_val = (x_train[:-1] + x_train[1:]) / 2
y_val = 1 + 2 * x_val

line = fit(x_train, y_train, degree=1)
large = fit(x_train, y_train, degree=8)
regularized = fit(x_train, y_train, degree=8, penalty=0.01)
print("high-degree train lower:", mse(x_train, y_train, large) < mse(x_train, y_train, line))
print("high-degree validation worse:", mse(x_val, y_val, large) > mse(x_val, y_val, line))
print("L2 reduces validation MSE:", mse(x_val, y_val, regularized) < mse(x_val, y_val, large))
text
high-degree train lower: True
high-degree validation worse: True
L2 reduces validation MSE: True
这个例子展示高阶模型可以精确拟合有限训练点,同时在其间的验证点偏离目标关系。它也展示一种正则化能减轻偏离。实际任务中按第 03 章的流程比较候选;决定最终配置后再进行独立测试。
本课练习
打印三种模型的训练与验证 MSE。将惩罚系数改成 100,观察权重和误差。再写出早停所需的监控指标、改善阈值、耐心轮数和检查点恢复步骤。
按自己的节奏,确认真正理解。