
机器学习与深度学习 / 系统课时
Transformer 架构
Transformer 架构
上一课用单头注意力计算了位置之间的信息汇总。Transformer 将注意力、前馈网络、残差连接和归一化组合为可堆叠的模块。不同架构对各层可见位置的约束不同,决定它们如何编码输入或生成输出。
学习目标
- 描述词元表示经过 Transformer 块到达输出头的形状变化。
- 区分仅编码器、仅解码器和编码器—解码器架构。
- 运行微型因果块,检查后续词元变化是否影响早期输出。
从词元到隐藏表示与输出头
文本先转成词元编号,嵌入层得到形状 (批量, 序列长度, 隐藏宽度) 的表示。位置可通过加到嵌入上的位置向量表示,也可用作用在注意力中的相对位置或旋转机制。没有位置机制也没有非对称掩码时,标准自注意力对输入重排是等变的:重排输入会对应重排输出。因果遮罩本身则限制了先后访问关系。 Transformer 原论文 旋转位置编码原论文
一个常见块包含多头自注意力与逐位置前馈网络。自注意力汇总不同位置的信息,前馈网络对每个位置做共享的非线性变换。残差要求被相加的表示形状一致。归一化可以放在子层前或后,取决于具体架构。语言模型的输出头可将每个位置的隐藏表示映射为词表 logits。 Transformer 原论文 PyTorch TransformerEncoderLayer
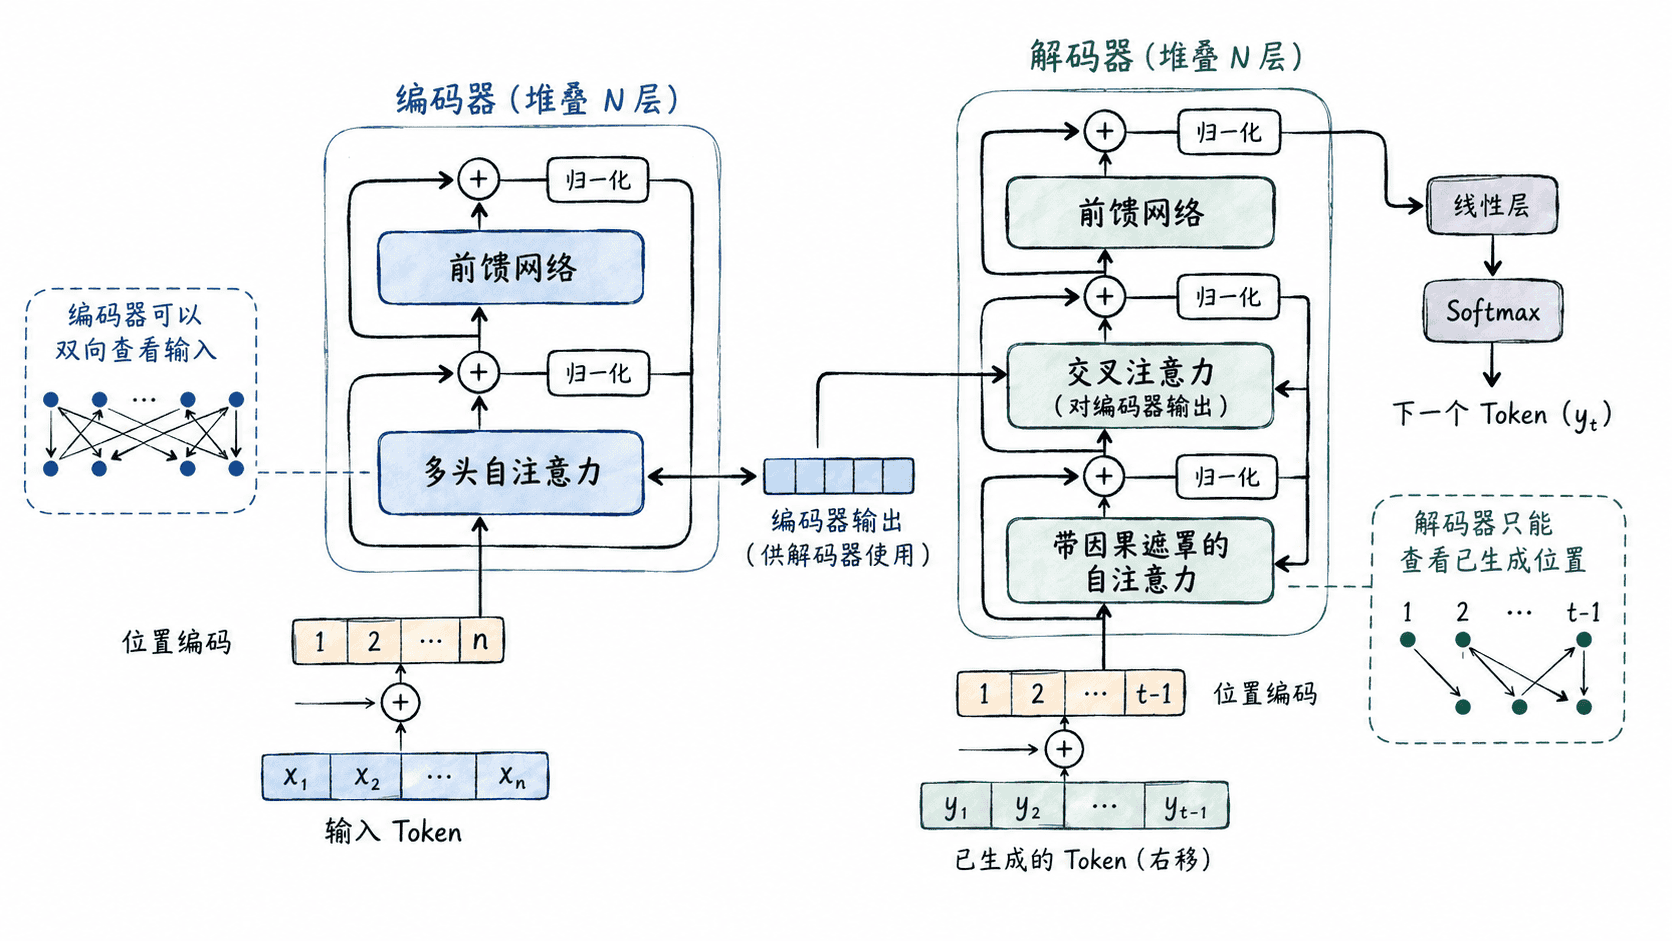
三类架构的信息流
| 架构 | 位置可见性 | 常见任务 |
|---|---|---|
| 仅编码器 | 常使用双向自注意力,屏蔽填充等无效位置 | 文本分类、提取和上下文表示 |
| 仅解码器 | 常使用因果自注意力读取自身与前缀,当前位置的 logits 对齐下一词元 | 文本续写和因果语言建模 |
| 编码器—解码器 | 编码器先读取源输入,解码器有因果自注意力,并以目标侧隐藏表示作 Query、源侧编码作 Key 和 Value 进行交叉注意力 | 翻译、摘要等条件生成 |
在训练时,移位的真实目标已经在手,可并行计算多个位置。生成时,下一个词元要依赖前面刚生成的词元,仍然是逐步解码。实现可缓存已有位置的键和值以减少重复计算,缓存占用和长序列成本仍需评估。 Transformer 原论文 Transformers 键值缓存说明
实跑微型因果块
用 PyTorch 的 TransformerEncoderLayer 作为只有自注意力和前馈的构件,加上显式因果遮罩模拟仅解码器的一层。此处没有交叉注意力,也没有训练。遮罩中 True 表示该位置被挡住,和上一课调用的 SDPA 布尔参数极性相反。测试只改变最后一个词元,比较前两个位置的输出。 PyTorch TransformerEncoderLayer PyTorch MultiheadAttention
import torch
from torch import nn


torch.manual_seed(7)
token_embed = nn.Embedding(8, 4)
position_embed = nn.Embedding(3, 4)
block = nn.TransformerEncoderLayer(
    d_model=4, nhead=2, dim_feedforward=8, dropout=0.0,
    batch_first=True, norm_first=True,
).eval()
head = nn.Linear(4, 8)
blocked = torch.triu(torch.ones(3, 3, dtype=torch.bool), diagonal=1)


def run(tokens):
    positions = torch.arange(tokens.shape[1])
    hidden = token_embed(tokens) + position_embed(positions)
    return head(block(hidden, src_mask=blocked))


with torch.no_grad():
    first = run(torch.tensor([[1, 2, 3]]))
    changed_tail = run(torch.tensor([[1, 2, 4]]))
print("logits shape:", tuple(first.shape))
print("same prefix:", torch.allclose(first[:, :2], changed_tail[:, :2], atol=1e-6))
print("changed last:", not torch.allclose(first[:, 2], changed_tail[:, 2], atol=1e-6))logits shape: (1, 3, 8)
same prefix: True
changed last: True本例只处理长度为 3 的序列。更长序列要按实际输入构造因果与填充约束,并保证位置表示支持相应长度。随机初始化的输出只用于检查信息流,无法用来解释具体词义。
本课练习
将 blocked 改成全假,再比较前两个位置是否仍保持不变。用第 08-03 节的例子写出三个输出位置对应的训练目标。下一课会沿着这个形状解释模型怎样得到实际的参数。