
机器学习与深度学习 / 系统课时
认识数据与特征
认识数据与特征
假设我们要在房屋首次挂牌时估计未来成交价。模型的输入必须在挂牌时已经可得。历史成交结果可以在训练和评估时提供标签,同一套规则也要能处理尚未成交的房屋。
学习目标
- 按任务区分样本、特征和标签,说明各自在什么时候可得。
- 比较表格、文本和图像的组织形式以及它们进入模型的方式。
- 从同一组记录按固定字段顺序构建输入和目标,识别未来信息泄漏。
从一条样本认识数据集
这里把一次挂牌作为一个样本。若同一套房两次挂牌,就可能有两条记录。是否保留两个样本要由业务问题与评估方式决定。样本里的面积、卧室数、挂牌时的楼龄和区域,可以作为输入特征。若定义目标为这次挂牌最后的成交价,对应的历史实际成交价就是标签。特征和标签都对应同一个样本,行顺序也要对齐。按挂牌时估价时,模型只收到输入特征。
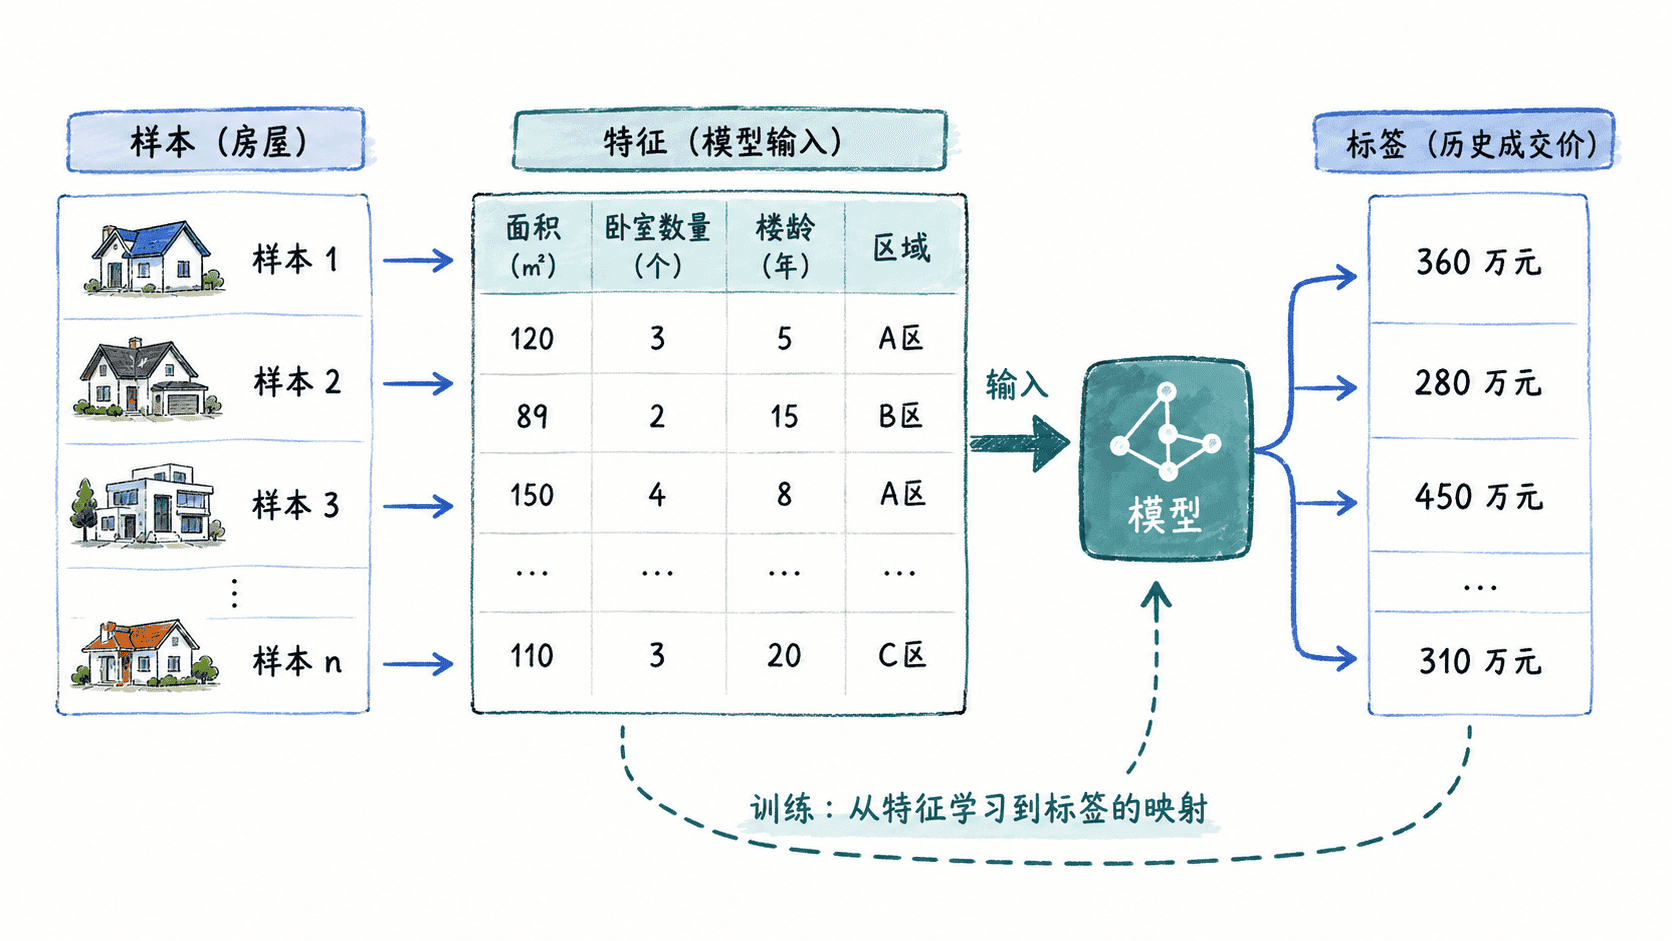
以下数据只用于演示。最后一列在成交后产生,额外保留它是为了排查泄漏。
| 挂牌记录 | 面积(㎡) | 卧室数 | 楼龄(年) | 区域 | 成交价(万元) | 成交后税费(万元) |
|---|---|---|---|---|---|---|
| L1 | 92 | 2 | 8 | A区 | 315 | 6.3 |
| L2 | 128 | 3 | 3 | B区 | 468 | 9.36 |
| L3 | 75 | 2 | 15 | A区 | 252 | 5.04 |
数据的组织形式
结构化记录有可明确描述的字段、类型和单位,例如表格里一行一笔订单。也有半结构化记录,例如 JSON 日志中的固定字段与可变属性。图片、自由文本和音频通常没有固定的业务列,仍分别具有空间、词序或时间结构。可为它们建立元数据表,但像素、词元序列和波形要按各自的表示方式交给模型。一个任务也可以把挂牌表、房屋照片和描述文本放在同一个样本中。
按字段选择输入与标签
下面用 Python 标准库把表里的混合类型记录拆成 X_raw 和 y。它们分别保留三条记录的原始输入和成交标签。编号用于跟踪,税费留在原始记录中。features_for 同时适用于尚无标签的预测记录。
FEATURES = ("area_m2", "bedrooms", "age_years", "district")
TARGET = "sale_price_10k"


def features_for(row):
    return [row[name] for name in FEATURES]


rows = [
    {"listing_id": "L1", "area_m2": 92, "bedrooms": 2, "age_years": 8,
     "district": "A区", "sale_price_10k": 315, "closing_tax_10k": 6.3},
    {"listing_id": "L2", "area_m2": 128, "bedrooms": 3, "age_years": 3,
     "district": "B区", "sale_price_10k": 468, "closing_tax_10k": 9.36},
    {"listing_id": "L3", "area_m2": 75, "bedrooms": 2, "age_years": 15,
     "district": "A区", "sale_price_10k": 252, "closing_tax_10k": 5.04},
]
X_raw = [features_for(row) for row in rows]
y = [row[TARGET] for row in rows]
new_listing = {"district": "C区", "age_years": 6, "bedrooms": 2, "area_m2": 100}

print("first row:", X_raw[0])
print("labels:", y)
print("new listing:", features_for(new_listing))first row: [92, 2, 8, 'A区']
labels: [315, 468, 252]
new listing: [100, 2, 6, 'C区']用预测时点排查泄漏
判断某个字段能否用作特征时,问它的历史版本在实际预测时点能否取得。成交税费由结果决定且晚于挂牌,会把未来信息带进训练。挂牌价可能在预测时可用,之后更新的价格仍需按预测时点取正确快照。整理历史数据时,记录采集时间和关联规则,防止把事后修改回填到旧记录。 scikit-learn 数据泄漏说明
评估时先划分数据,再在训练集上学习预处理和参数。若部署要预测未来的挂牌,考虑按时间留出评估。若要评估对没见过的房屋的表现,同一房屋的多次挂牌应一起分到同一侧。未成交样本暂时没有可用于这个任务的成交价,不能填 0 当真值。只保留已成交记录训练时,也要明确这种筛选会限制模型能回答的问题。 scikit-learn 训练和测试数据隔离
本课练习
把挂牌价、最终成交日期、区域和房屋编号分别归类为候选特征、仅用于关联的字段或不可用字段。说明预测时点,再写出哪些标签能从历史记录得到。下一课会把区域字符串和数值列变成固定形状的输入。