
机器学习与深度学习 / 系统课时
目标检测
目标检测
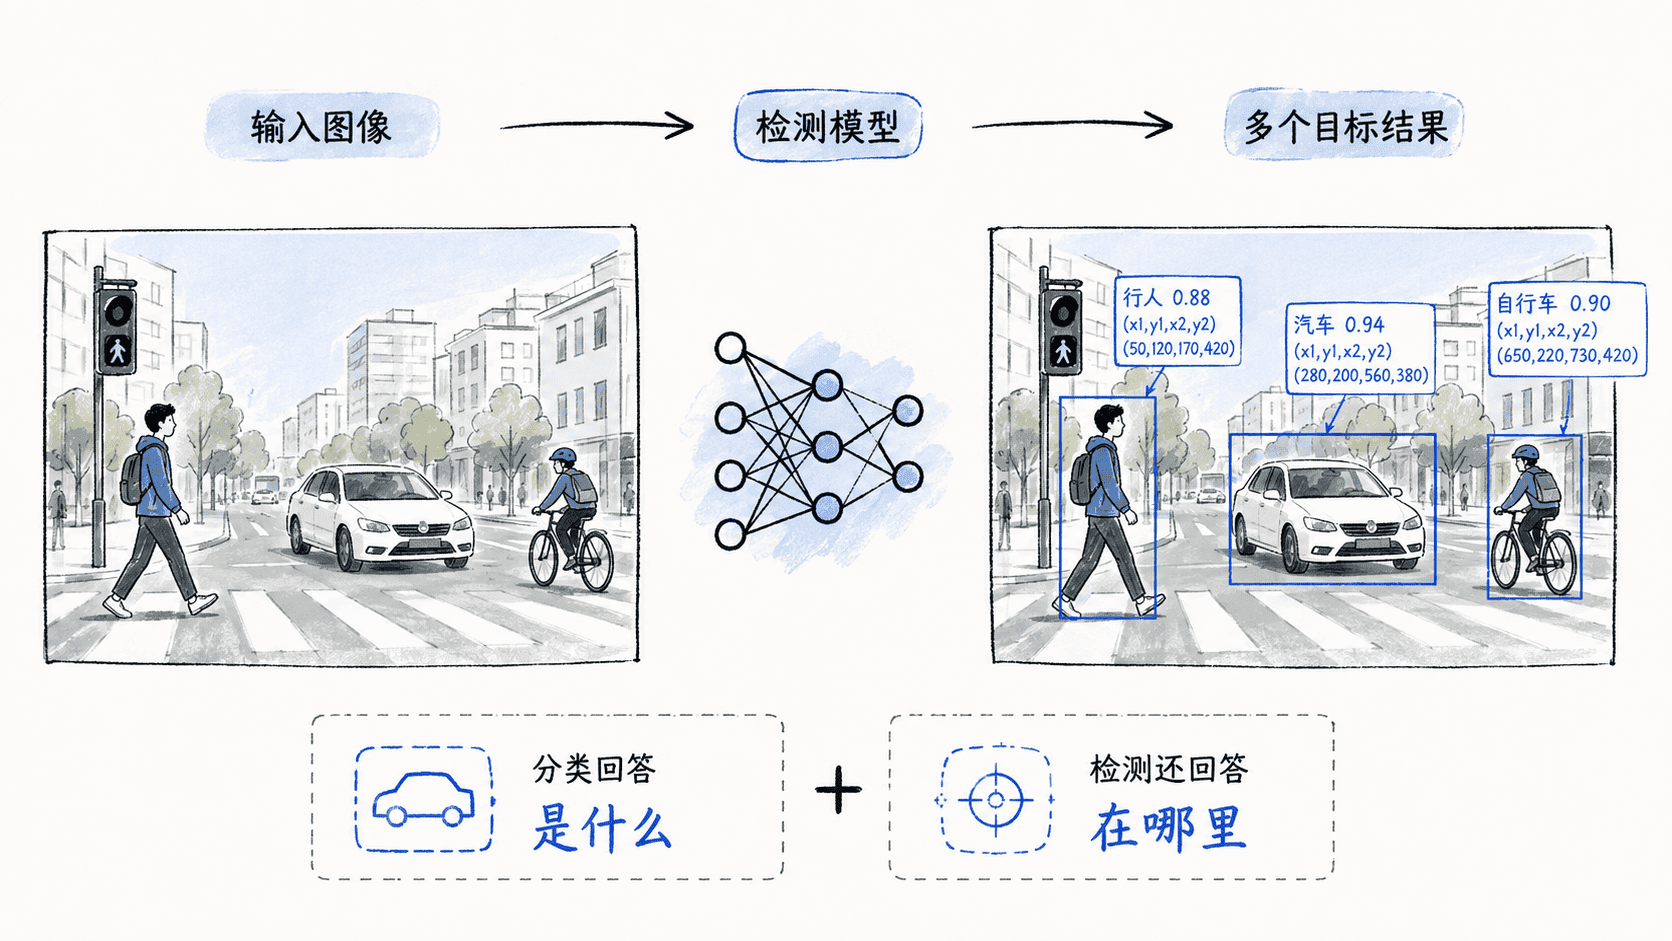
整图分类可以判断图里有汽车。目标检测还需要为每辆车给出一个框、类别和分数。本课分别核对模型坐标、候选去重和评估定位的规则。
学习目标
- 识别检测结果的框格式、坐标系、类别和分数。
- 计算交并比(IoU),理解按类执行的非极大值抑制(NMS)。
- 区分候选过滤、框去重和与真实框匹配的三种阈值。
先对齐坐标系
常见框格式包括 xyxy(左上与右下)、xywh(左上与宽高)及中心点加宽高。有的接口用像素,有的使用 0 到 1 的归一化坐标。还要确认坐标属于原图、缩放图还是填充后模型输入。本文用连续的 xyxy 边界,宽度为 x2-x1、高度为 y2-y1。只有旧接口明确采用包含端点的整数约定时才用不同公式。 Torchvision 框 IoU 接口
例如原图为宽 640、高 360。等比缩小到宽 320、高 180,再在上下各填充 70 像素到 320 × 320。模型输入中的 (50,100,150,200),去掉填充再除以缩放比例 0.5,回到原图的 (100,60,300,260)。真实系统保存实际缩放和左右上下偏移,考虑取整、裁切与出界框,统一坐标后再叠图和评估。
重叠、分数和去重
IoU 等于交集面积除以并集面积。两框不重叠或只有边界接触时 IoU 为 0,相同的有效框 IoU 为 1。无宽高的框应先拒绝或按接口约定处理。检测分数可以来自类别概率、目标存在性或定位质量等组合,具体由模型定义。高分并不保证框贴合,也不代表可跨模型直接比较。
按类的贪心 NMS 先按分数排序,保留当前最高分框,再去掉同类中与它的 IoU 大于阈值的较低优先级框。不同类可以保留重叠框。相邻目标密集时,高重叠可能来自两个真实对象,NMS 也可能删掉其中一个。某些检测模型采用不同去重机制或无需 NMS。 Torchvision 按类 NMS
可运行示例:同类去重与跨类保留
下面用标准库模拟已经完成低分过滤的四个框,所有坐标在同一空间。本例分数相同会保留输入顺序。不同库或设备对同分候选的选择未必相同。
from math import isfinite


def area(box):
    x1, y1, x2, y2 = box
    if not all(isfinite(value) for value in box) or x2 <= x1 or y2 <= y1:
        raise ValueError("expected positive xyxy box")
    return (x2 - x1) * (y2 - y1)


def iou(left, right):
    overlap_w = max(0, min(left[2], right[2]) - max(left[0], right[0]))
    overlap_h = max(0, min(left[3], right[3]) - max(left[1], right[1]))
    intersection = overlap_w * overlap_h
    return intersection / (area(left) + area(right) - intersection)


def classwise_nms(detections, threshold):
    if not 0 <= threshold <= 1:
        raise ValueError("NMS threshold must be between zero and one")
    kept = []
    for item in sorted(detections, key=lambda item: item[2], reverse=True):
        _, label, _, box = item
        area(box)
        if not any(label == saved[1] and iou(box, saved[3]) > threshold for saved in kept):
            kept.append(item)
    return kept


def undo_resize(box, scale, pad_x, pad_y):
    area(box)
    if not isfinite(scale) or scale <= 0:
        raise ValueError("resize scale must be positive and finite")
    return tuple((value - pad) / scale
                 for value, pad in zip(box, (pad_x, pad_y, pad_x, pad_y)))


detections = [
    ("a", "car", 0.94, (0, 0, 100, 100)),
    ("b", "car", 0.83, (10, 10, 100, 100)),
    ("c", "bicycle", 0.80, (10, 10, 100, 100)),
    ("d", "car", 0.75, (200, 0, 300, 100)),
]
print(f"a/b IoU={iou(detections[0][3], detections[1][3]):.2f}")
print("kept:", [item[0] for item in classwise_nms(detections, 0.5)])
print("original box:", undo_resize((50, 100, 150, 200), 0.5, 0, 70))a/b IoU=0.81
kept: ['a', 'c', 'd']
original box: (100.0, 60.0, 300.0, 260.0)评估时与标注框匹配
分数阈值决定保留哪些候选,NMS 的 IoU 阈值比较两个预测框,评估的 IoU 阈值比较预测与标注。常见评估在同类中按预测分数匹配框,并对普通非拥挤标注实施一对一匹配。重复预测可能成为误报。AP 依评估协议汇总精确率与召回率。以 COCO 的标准框 AP 为例,它在 0.50 到 0.95、步长 0.05 的多个 IoU 阈值上汇总;报告还应注明面积范围、每图检测上限及忽略标注规则。 COCO 官方评估实现
本课练习
用两框刚好接触的例子验证 IoU 为 0,再比较把 NMS 阈值调到 0.85 后保留的结果。若框无法表达同类对象轮廓或需要逐像素编辑,下一课使用掩码。