
机器学习与深度学习 / 系统课时
准备项目数据
准备项目数据
数据准备决定模型能学到什么,也决定评估结果是否可信。本课以客服工单分类为例,完成样本清洗、去重、标签检查和训练集、验证集、测试集划分,并说明如何避免数据泄漏。
学习目标
- 建立从收集到质量检查的数据处理流程
- 能完成去重、标签校验和可复现划分
- 识别样本偏差、隐私风险和数据泄漏
数据准备的完整链路
数据通常要经过收集、清洗、标注、划分和质量检查。每一步都应保留处理规则和版本,保证后续实验能够重现。
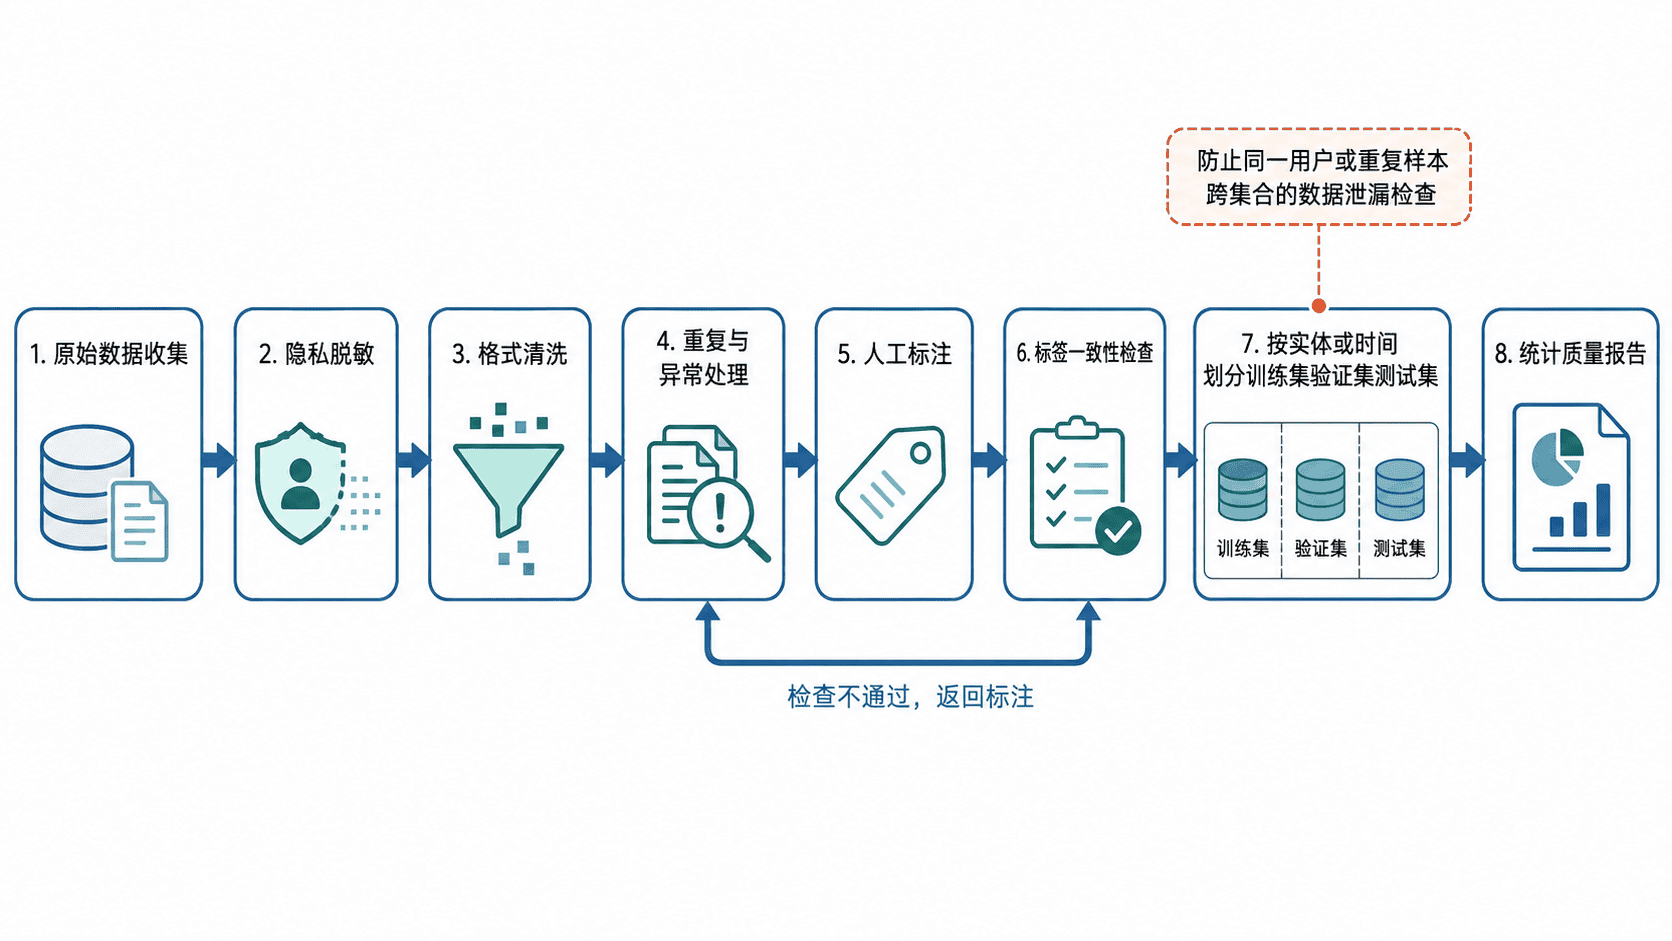
收集时要确认数据来源、授权范围和保留期限。输入只保留预测时可见且任务必需的字段,检查自由文本中的姓名、电话、地址和证件号。分组所需的账号代号与原标识分开存放,按授权限制映射访问。替换标识后仍应检查关联或还原风险。
清洗与划分示例
示例评估未来首次出现的账户。先按创建日期设置训练、验证和测试窗,账户首次出现决定所属集合。后来出现在其他窗口的同账户记录单独计数。每个窗口内部按文本比较标签,冲突整组交人工;与更早窗口同文的后期记录不进入评估。夹具用合成账号代号和日粒度 ISO 日期。
from collections import Counter, defaultdict
from datetime import date

records = [
    ("2026-01-04", "A", " 无法 登录 ", "账号"),
    ("2026-01-05", "A", "无法 登录", "账号"),
    ("2026-01-06", "B", "退款没到账", "退款"),
    ("2026-02-02", "A", "账号锁定", "账号"),
    ("2026-02-02", "C", "验证码缺失", "账号"),
    ("2026-02-04", "D", "退款流程", "退款"),
    ("2026-03-01", "E", "无法 登录", "账号"),
    ("2026-03-02", "F", "重复扣款", "退款"),
    ("2026-03-04", "G", "异地登录", "账号"),
    ("2026-03-05", "H", "重开工单", "账号"),
    ("2026-03-05", "H", "重开工单", "退款"),
]

def partition(records):
    buckets = ("train", "valid", "test")
    groups = {name: defaultdict(list) for name in buckets}
    first_bucket = {}
    rejected = Counter()
    for timestamp, account, raw, label in sorted(records):
        created = date.fromisoformat(timestamp)
        if created < date(2026, 2, 1):
            bucket = "train"
        elif created < date(2026, 3, 1):
            bucket = "valid"
        else:
            bucket = "test"
        if first_bucket.setdefault(account, bucket) != bucket:
            rejected["已有账户跨窗口"] += 1
            continue
        text = " ".join(raw.split())
        if not text or label not in {"账号", "退款"}:
            rejected["空文本或范围外"] += 1
            continue
        groups[bucket][text].append((timestamp, account, text, label))

    clean = {name: [] for name in buckets}
    seen = set()
    for name in buckets:
        for text, rows in groups[name].items():
            if text in seen:
                rejected["文本跨集合重复"] += len(rows)
            elif len({row[3] for row in rows}) > 1:
                rejected["标签冲突待复核"] += len(rows)
            else:
                clean[name].append(rows[0])
                rejected["集合内重复"] += len(rows) - 1
        seen.update(groups[name])
    return clean, dict(rejected)

splits, rejected = partition(records)
print({name: len(rows) for name, rows in splits.items()})
print(rejected)
三个集合各剩 2 条。排除的 5 条包括旧账号跨窗口 1 条、集合内重复 1 条、跨集合同文 1 条和标签冲突 2 条。后期数据不会反过来改变更早窗口的留存内容。生产环境还要核对转发、同一事故模板等近重复,明确哪些属于同一事件并评估排除后的人群偏差。
标注质量与一致性
标签定义必须先于大规模标注。每个类别都应说明适用条件、排除条件和边界示例,否则不同标注者会按个人理解给出不同答案。
可以抽取同一批样本交给两名标注者,比较一致率,并集中复核争议样本。若某些样本长期无法一致判断,可能不是标注者问题,而是类别设计重叠或业务规则不清。
避免数据泄漏
随机划分并不总是安全。同一用户的多条相似工单、同一原始文档切出的多个片段,若同时出现在训练集和测试集,会让测试结果虚高。
选择切分应贴合上线目标。要评估新账户,就同时检查实体互斥和训练早于评估。要评估老账户的未来工单,可保留该账户的历史,但特征只用预测当时可用的数据,不能纳入事后处理结果。两种人群可分别报告。测试集一旦确定,不应在反复调参过程中持续查看。
质量检查清单
划分后记录每类支持数、窗口时间、实体交集、排除原因、输入输出版本和数据指纹。账号代号只用于拆分,不作为分类特征。某个类别在评估窗缺失时应补足评估,别用无该类样本的结果作保证。还要随机阅读样本,确认统计正常并不代表内容正确。
数据分布会随业务变化。上线后出现的新产品、新术语和新用户行为,需要进入持续采样和再标注流程,而不是长期依赖最初的一份静态数据。