
机器学习与深度学习 / 系统课时
机器学习是什么
机器学习是什么
机器学习的核心不是让计算机死记答案,而是让它从已有数据中寻找可复用的规律,再把这些规律应用到未见过的新数据上。理解训练、模型和预测之间的关系,可以建立后续学习分类、回归和模型评估所需的基本框架。
学习目标
- 理解机器学习从数据中学习规律的基本思想
- 区分训练数据、学习算法、模型和预测结果的职责
- 判断一个问题是否适合使用机器学习解决
机器学习的本质
传统程序通常由人直接写出规则。例如计算订单总价时,开发者明确规定“单价乘数量再减优惠”。输入发生变化,规则本身仍然由人维护。
机器学习面对的是另一类问题:规则很难完整写出来,但存在大量历史样本。例如识别垃圾邮件时,人可以描述一些特征,却很难穷举所有语言组合。机器学习算法会利用已经标注的邮件,调整模型内部参数,使模型逐渐学会哪些模式更可能对应垃圾邮件。
可以把这个过程概括为:数据提供经验,算法负责寻找规律,模型保存学到的规律,预测则把规律应用到新输入。
训练与预测如何衔接
训练阶段和实际使用阶段承担不同任务。监督训练会使用已知目标,但拟合方式可以是迭代优化,也可以直接统计或求解。无监督学习通常使用样本结构而不依赖已给目标标签。训练完成后得到的模型,可以接收新的输入并输出预测结果。
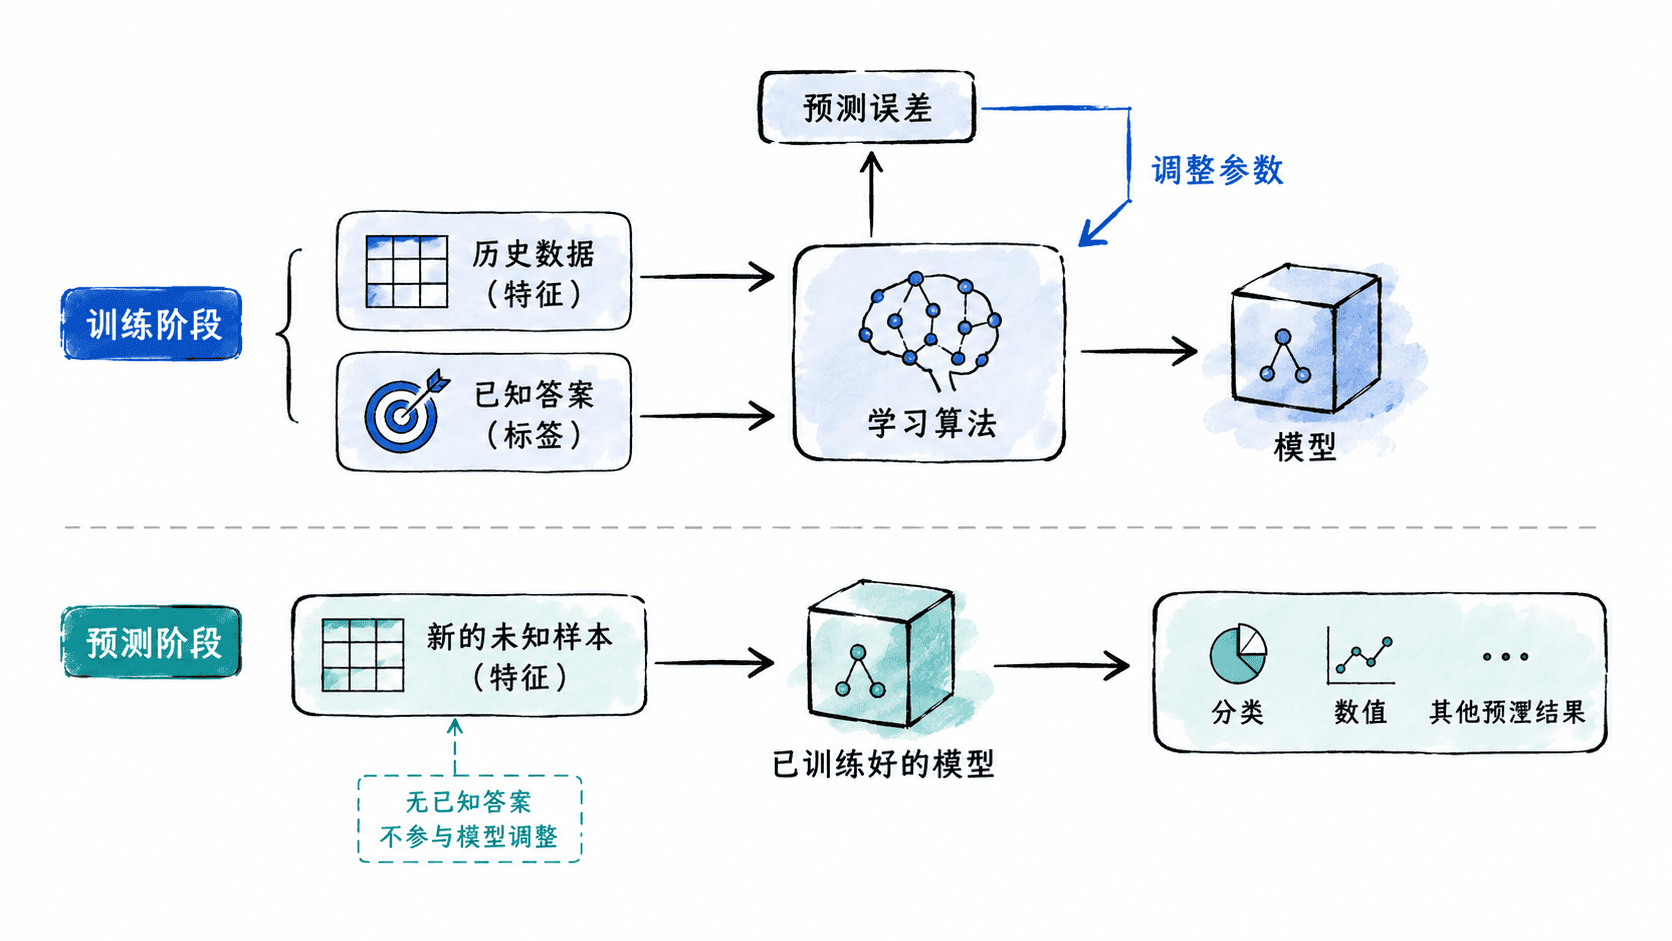
例如预测房价时,历史房屋的面积、位置、房龄等可以作为输入特征,已成交价格作为训练时的目标值。模型从大量样本中学习这些因素与价格之间的关系,之后面对一套尚未成交的房屋,就可以根据其特征给出估计价格。
先与一个可复现的基线比较
用第 2 章的房屋例子。这里以万元为单位,用训练集价格中位数作为常数基线,再估计各区域中位数。新区没出现在训练集时回到常数基线。最后在单独留出的假设成交记录上计算平均绝对误差(MAE)。
from statistics import mean, median

def fit_prices(train):
    if not train:
        raise ValueError("训练集不能为空")
    groups = {}
    for area, price in train:
        groups.setdefault(area, []).append(price)
    return median([price for _, price in train]), {
        area: median(prices) for area, prices in groups.items()
    }

def evaluate(test, predictor):
    if not test:
        raise ValueError("评估集不能为空")
    return mean(abs(price - predictor(area)) for area, price in test)

train = [("东区", 100), ("东区", 120), ("西区", 200), ("西区", 220)]
test = [("东区", 130), ("西区", 230), ("新区", 180)]
overall, groups = fit_prices(train)
print("训练中位数:", overall, groups)
print("常数基线 MAE:", f"{evaluate(test, lambda _: overall):.2f}")
print("分区基线 MAE:", f"{evaluate(test, lambda area: groups.get(area, overall)):.2f}")
常数基线 MAE 为 40.00 万元,分区基线为 20.00 万元。这只是 3 条测试记录的算术示例。真实项目按上线场景划分数据,避免同一房屋或未来成交记录穿过切分。选择模型时用验证集,测试集留到最后。
哪些问题适合机器学习
机器学习通常适合规则难以人工完整描述、但可以获得足够代表性数据的问题。典型任务包括判断邮件是否为垃圾邮件、预测未来销量、识别图片中的物体,以及按照用户兴趣对内容进行排序。
如果一个问题已经存在稳定、简单并且必须严格执行的确定规则,直接编程往往更可靠。例如税率计算、权限校验和固定格式转换通常没有必要交给模型猜测。
还要关注数据是否能代表未来使用环境。即使训练数据很多,如果样本长期偏向某些地区、设备或用户群体,模型也可能只学到局部规律,在真实环境中表现明显下降。
如何判断模型真的学到了
训练数据上的正确率高,并不能证明模型具备实际价值。模型可能只是过度记住训练样本,却无法处理新的数据,这种现象称为过拟合。因此,机器学习流程通常会保留模型训练时没有直接使用的数据,用于检查泛化能力。
最基本的判断方式是比较模型在训练数据和未见数据上的表现。训练与新数据表现差异也可能来自分布变化、数据泄漏或标签口径不一致。先核对切分、基线和评价数据,再判断是否过拟合。
机器学习真正追求的不是“把历史题目全部答对”,而是从有限样本中得到能够迁移到新样本的规律。后续选择算法、划分数据集和评价模型,都是围绕这一目标展开。