
机器学习与深度学习 / 系统课时
注意力机制
注意力机制
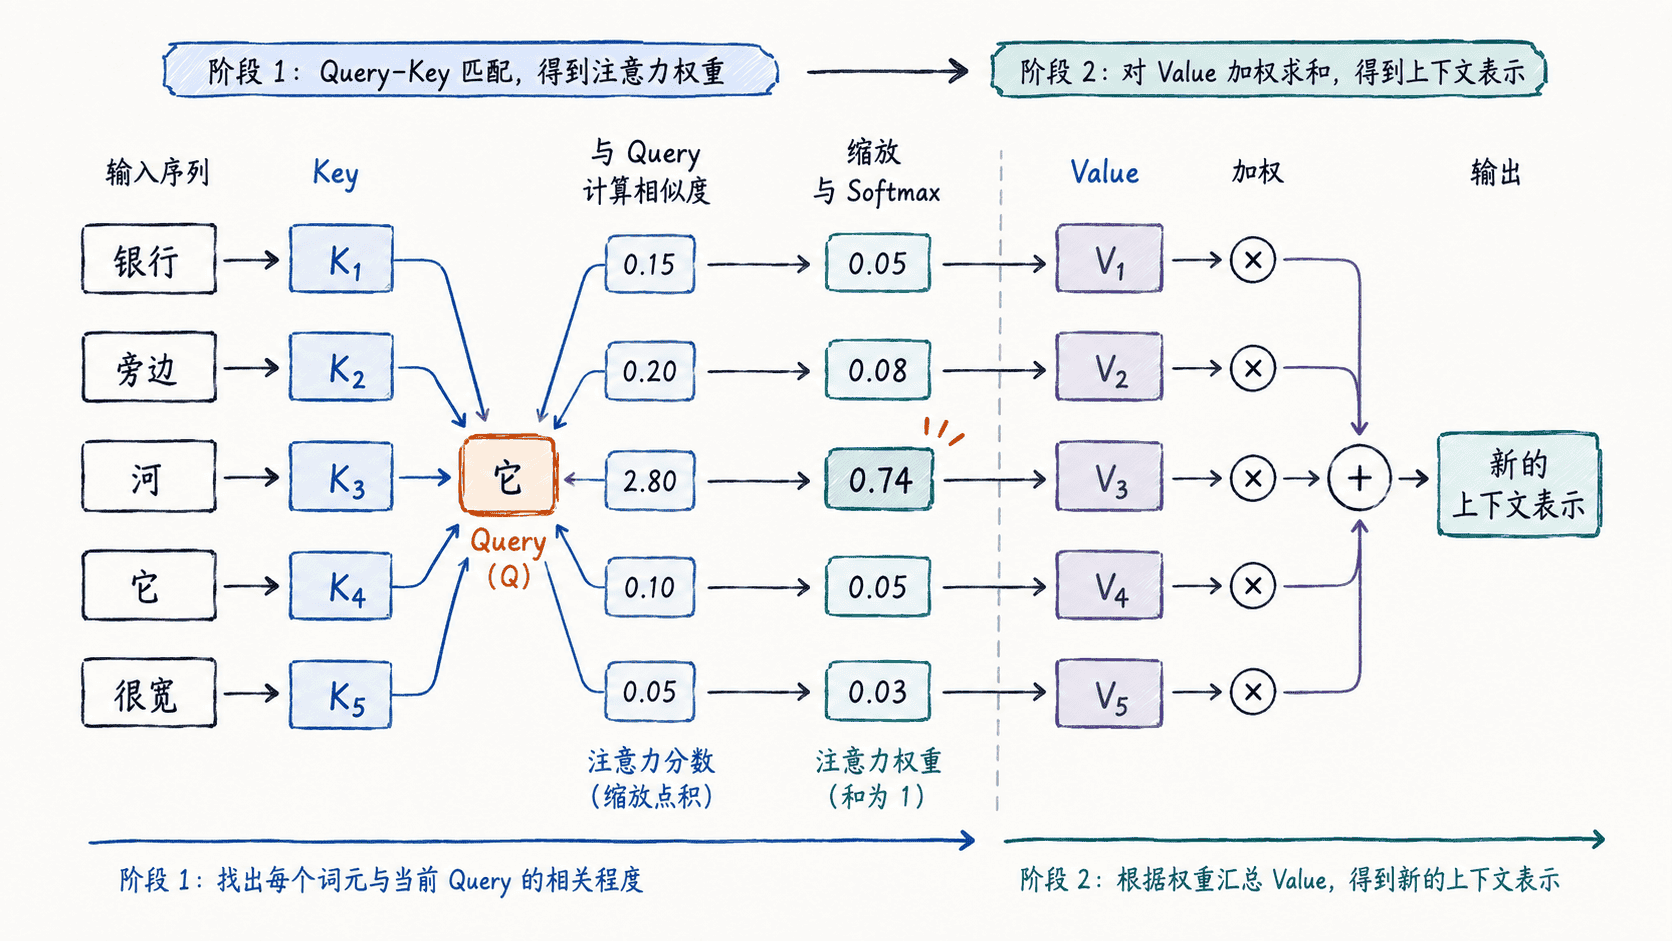
因果语言模型需要从已有位置汇总信息。注意力用查询匹配一组键,再按得到的权重组合对应的值。某个词元和其他位置的权重取决于输入与模型参数,不能只凭注意力权重断定模型使用了什么语言规则。
学习目标
- 分清 Query、Key、Value 与对应的矩阵形状。
- 沿键轴归一化,并把因果与填充约束放到 Softmax 前。
- 用小矩阵计算输出,理解多头和标准注意力的成本。
Query、Key、Value 与输出形状
Query 是用来匹配键的向量,Key 用于被比较,Value 是实际参与汇总的向量。若有 个查询、 个键,查询和键的维度都为 ,值向量宽度为 ,则 、、 的形状依次是 (L, d_k)、(S, d_k)、(S, d_v)。点积矩阵是 (L,S),每行对应一个查询。缩放分数 后,在每行的键轴做 Softmax,再乘 得到 (L,d_v)。缩放用于控制点积分数的量级。 Transformer 原论文
自注意力、交叉注意力和遮罩
自注意力的查询、键、值源于同一层输入。交叉注意力从一组表示取得查询,从另一组表示取得键和值, 与 可以不同。对全序列因果自注意力,位置 可以读取自身和较早位置,不能读取未来。若该位置的输出用来预测第 个词元,读取自身不会泄露目标。再加填充约束时,只允许同时符合因果约束且真实存在的键。 Transformer 原论文
下面代码的布尔矩阵中,True 表示允许。PyTorch scaled_dot_product_attention 的布尔掩码也是这个方向,但 MultiheadAttention 的布尔掩码中 True 表示不允许。实际接入前先确认极性。用负无穷屏蔽分数时,若一整行均无可用键,普通 Softmax 无法归一化。示例直接拒绝这种行,生产应按实现和任务规定跳过或定义输出。 PyTorch SDPA PyTorch MultiheadAttention
实跑三步因果注意力
令三个查询和键向量均为零,因此所有允许位置等权。三个值分别为 2、4、8。第一步只能读 2,第二步平均前两个值,第三步平均三个。NumPy 完成显式计算,再用 PyTorch 对照。
import numpy as np
import torch
import torch.nn.functional as F


def attend(q, k, v, allowed):
    if not allowed.any(axis=1).all():
        raise ValueError("every query needs an allowed key")
    logits = q @ k.T / np.sqrt(k.shape[1])
    logits = np.where(allowed, logits, -np.inf)
    weights = np.exp(logits - logits.max(axis=1, keepdims=True))
    weights /= weights.sum(axis=1, keepdims=True)
    return weights @ v


q = k = np.zeros((3, 2))
v = np.array([[2.0], [4.0], [8.0]])
allowed = np.tril(np.ones((3, 3), dtype=bool))
result = attend(q, k, v, allowed)
torch_result = F.scaled_dot_product_attention(
    torch.from_numpy(q)[None, None], torch.from_numpy(k)[None, None],
    torch.from_numpy(v)[None, None], attn_mask=torch.from_numpy(allowed),
    dropout_p=0.0,
)
np.testing.assert_allclose(torch_result[0, 0].numpy(), result)
print("allowed counts:", allowed.sum(axis=1).tolist())
print("outputs:", np.round(result[:, 0], 3).tolist())allowed counts: [1, 2, 3]
outputs: [2.0, 3.0, 4.667]多头与长序列
多头注意力各头分别投影并计算,再合并各头的结果。头之间可能学习不同关系,具体职责不一定可预先命名。标准密集自注意力在长度为 时需要处理约 个查询与键的位置对。朴素实现会物化这些分数,分块或融合实现可减少中间内存,稀疏注意力等方案还能改变参与计算的位置数。 Transformer 原论文 PyTorch SDPA 实现
本课练习
将最后一个值改成 100,检查前两个输出仍相同。再把最后一个键设为填充,观察第三行只读取前两个值。下一课会将注意力与位置表示、前馈网络和残差放进同一个 Transformer 模块。