
机器学习与深度学习 / 系统课时
支持向量机
支持向量机
前面学到的逻辑回归与决策树使用不同的规则构造分类边界。本课看支持向量机(SVM)怎样用训练样本约束边界、怎样容许训练违例,以及什么时候需要非线性核。
学习目标
- 从几何距离理解线性分类的间隔与支持向量。
- 用软间隔目标解释 和合页损失。
- 在已切分的数据上用 Pipeline 比较线性核和 RBF 核。
线性边界与几何间隔
记二分类标签为 ,分数为 ,其中 。当分数大于或小于 0 时,分别判为两类。样本到边界的几何距离是 。对线性可分数据,可以调整同一边界的 尺度,使约束写成 。这时两条间隔边界为 ,它们之间的总宽度为 。最大化宽度等价于最小化 。 scikit-learn 支持向量机数学说明
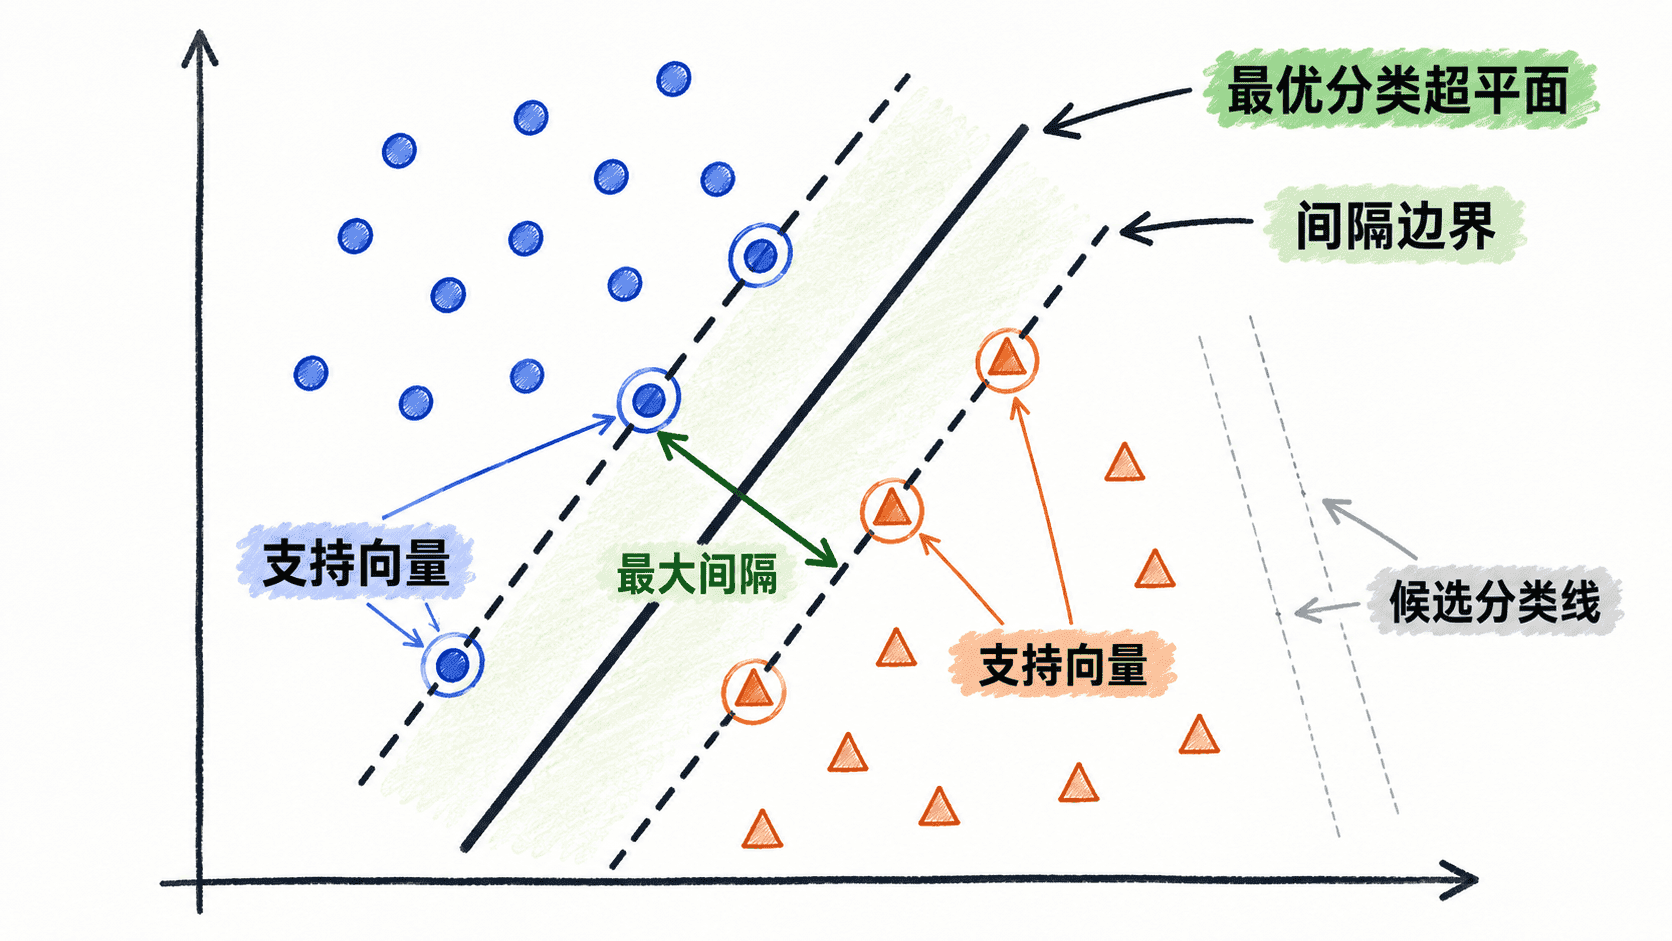
硬间隔可用靠在两侧间隔边界上的点来理解。严格来说,支持向量是对偶解中系数非零的训练样本。软间隔下它们可以在间隔内,甚至在分类边界的错误一侧。图中的间隔带用于建立几何直觉。 scikit-learn 支持向量机数学说明
用 C 权衡软间隔
给每个样本引入松弛量 ,将约束放宽为 。最优时 。目标最小化 ,所以即使预测类别正确,点落在间隔内时也会产生合页损失。 越大,越强调减少这些违例; 越小,对权重的正则化相对越强。样本重叠时仍可能存在训练错误。 scikit-learn 支持向量机数学说明
尺度不同的特征会影响距离和正则化。对可比较的连续列,可将标准化和分类器放在同一 Pipeline,只在训练集或交叉验证的训练折上拟合。对于稀疏文本特征,检查是否需要中心化以及它对内存的影响,再选择表示与线性分类器。 scikit-learn SVM 实践建议 scikit-learn 预处理泄漏说明
RBF 核与非线性边界
径向基函数核常写成 。它能直接计算特征空间的内积,而无须显式构造该空间的坐标。固定输入尺度时,较大的 使核值随距离更快衰减,每个样本的影响更局部;较小的 对应更宽的影响范围。交叉验证时联合比较 与 ,并保留最终独立测试。核 SVC 的拟合成本会随样本量快速增加,高维稀疏任务可先比较线性基线。 scikit-learn SVM 核函数与复杂度 SVC 参数说明
可运行示例:异或形状
这组数据的同类点处在对角方向,无法由一条直线全部分开。第二列数值量级大千倍。两种模型都在相同训练数据上拟合,比较时使用另外四个内插点。Python 示例需安装 scikit-learn,验证使用 1.5.2。
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC


X_train = [[-2, -2000], [-2, 2000], [2, -2000], [2, 2000],
           [-1, -1000], [-1, 1000], [1, -1000], [1, 1000]]
y_train = [0, 1, 1, 0, 0, 1, 1, 0]
X_check = [[-1.5, -1500], [-1.5, 1500], [1.5, -1500], [1.5, 1500]]
y_check = [0, 1, 1, 0]

linear = make_pipeline(StandardScaler(), SVC(kernel="linear", C=10))
rbf = make_pipeline(StandardScaler(), SVC(kernel="rbf", C=10, gamma=1))
linear.fit(X_train, y_train)
rbf.fit(X_train, y_train)

print("linear predicts all correctly:", linear.predict(X_check).tolist() == y_check)
print("rbf predictions:", rbf.predict(X_check).tolist())linear predicts all correctly: False
rbf predictions: [0, 1, 1, 0]Pipeline 预测时只应用已拟合的缩放。若查看 rbf.named_steps["svc"].support_vectors_,它返回的是缩放空间的坐标;support_ 给出训练行索引。默认的 decision_function 产生决策分数,概率估计需要单独处理。四个合成内插点只用于说明两种边界的表达能力。 SVC 输出与属性
本课练习
用同一训练集分别把 RBF 的 改成 0.01 和 100,比较内插点和更远点的决策分数。在真实任务中选择参数时,先规定验证分组、评分指标和最终测试数据。下一课会说明怎样读分类指标。