
机器学习与深度学习 / 系统课时
人工智能的能力边界
人工智能的能力边界
人工智能可以快速生成文本、分类信息、提取模式和提出候选方案,但“能生成”不等于“结论可靠”。本节建立一套判断框架:理解模型为何会不确定、哪些限制无法靠提示词消除,以及什么时候必须把最终决定交回人类。
学习目标
- 解释概率生成为什么会带来不确定性和幻觉风险
- 区分模型自身限制、数据限制与任务本身的判断责任
- 根据风险和可验证性决定“直接使用、验证后使用或人工决策”
模型输出是概率结果,不是真值查询
许多自回归语言模型会根据已有上下文估计下一个 token 的分布,再由解码策略选取输出。生成图像等系统也可能采用其他机制。它擅长生成看起来连贯且符合模式的答案,但并不会自动拥有现实世界中的真值、最新状态或完整证据。
因此,同一个问题换一种表述、修改采样设置,甚至只改变少量上下文,都可能得到不同答案。即使采用确定性解码,同一答案仍可能反复出错。生成概率或措辞的自信程度不能当成答案为真的概率。分类模型的概率需要用留出数据评估校准;改变数据分布后仍须重新验证。
对开放式写作、头脑风暴、代码草稿等任务,这种概率性通常可接受;对金额、法律条款、生产配置、医疗建议等高风险任务,仅凭语言流畅度判断正确性就很危险。
边界通常来自三种限制
第一类是信息限制。模型可能没有访问实时数据库、内部系统、现场传感器或最新文档。缺少这些事实时,它只能基于已有上下文推断,不能把未知信息自动变成事实。
第二类是模型限制。模型可能误解歧义、忽略长上下文中的约束、在陌生分布上失准,也可能生成不存在的引用、接口或数字。提示词可以降低部分错误,却不能保证零错误。
第三类是任务责任限制。有些问题并不存在唯一技术答案,例如招聘取舍、绩效评价、伦理判断、重大投资或是否承担安全风险。这类任务涉及价值选择、责任归属和现实后果,不应由模型独自作出最终决定。
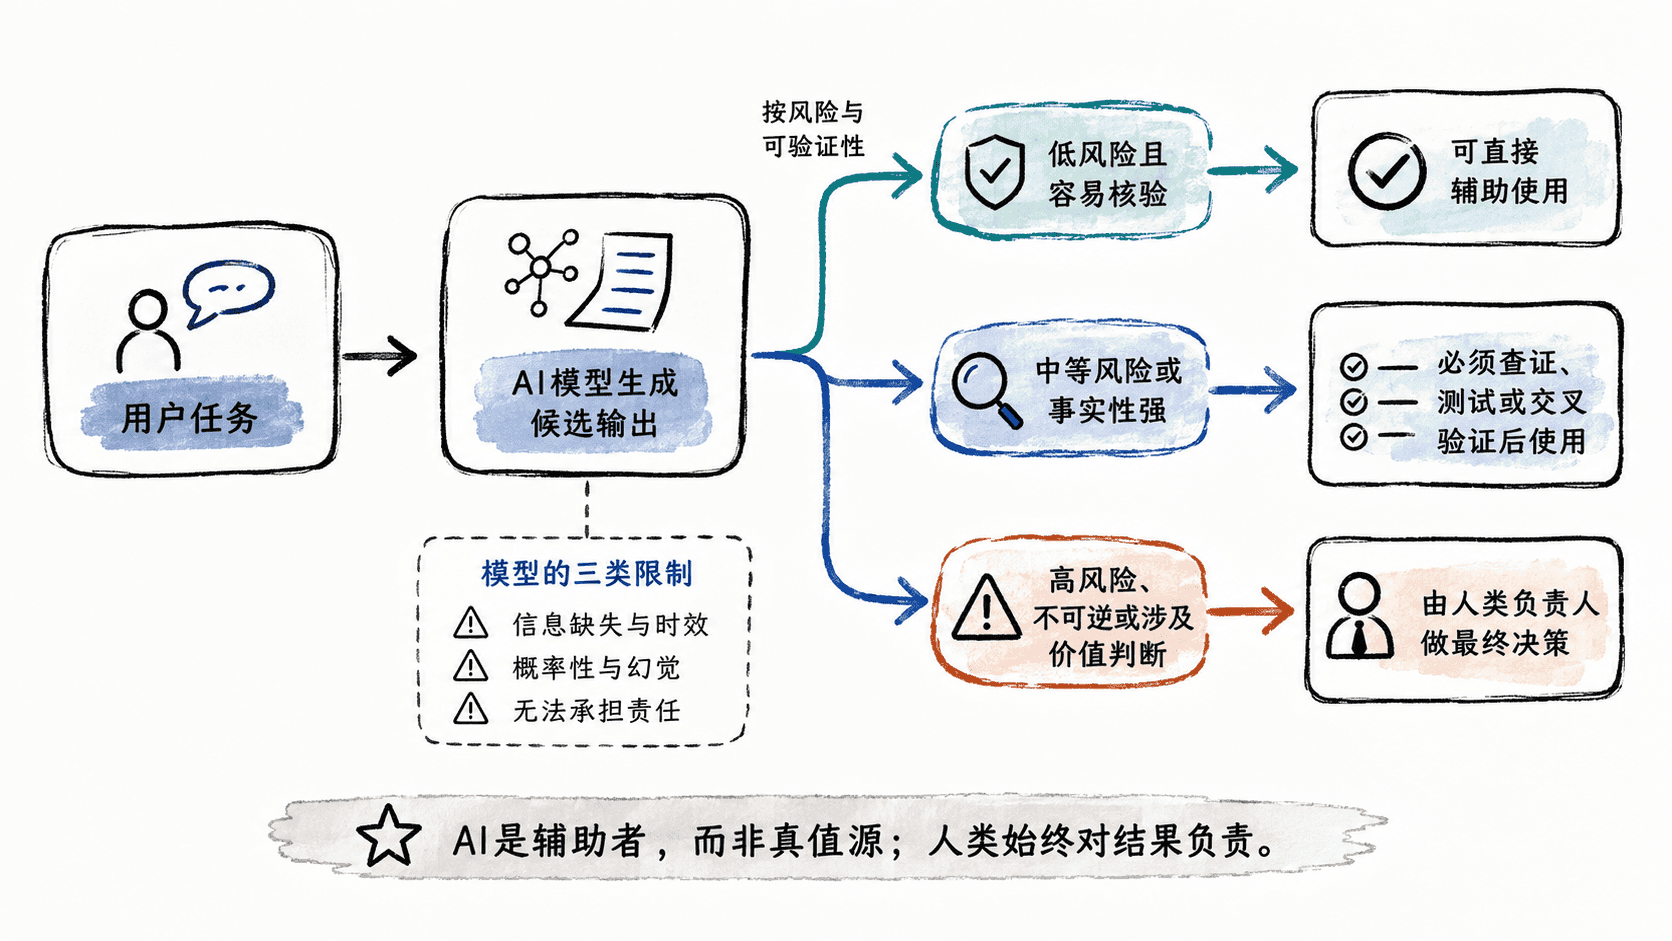
用风险和可验证性决定使用方式
面对一个具体任务,可以先问两个问题:出错的代价有多大,以及结果能否被独立验证。这两个维度通常比“模型看起来有多聪明”更能决定使用边界。
低风险且容易验证的工作,例如改写文案、生成测试数据草稿、整理会议主题,可以让模型承担更多执行工作。事实性较强但能核验的任务,例如解释代码、生成 SQL、汇总资料,应把测试、查询原始文档或人工审阅作为验收步骤。
当错误可能导致人身、财务、法律、安全或重大业务后果,或者任务本身需要价值判断时,模型适合提供信息整理、备选方案和风险提示,但最终判断必须由具备权限和责任的人完成。
把模型草稿与生产动作分开
例如让模型写一条汇总订单的 SQL。先对照实际字段和业务口径,确认是否应排除取消订单、退款是否归到原交易日期。再在只读测试库用包含重复、空值、日期边界和撤销记录的夹具验证预期。准备执行更新语句时,另用独立审批、备份和回滚控制;当证据缺失或权限不清时停止提交。
建立可复用的人机协作检查
实际使用时,可以在采纳模型输出前依次检查:它是否依赖模型无法看到的实时事实,关键结论是否有可追溯证据,结果是否可以通过测试或第二来源验证,以及一旦出错是否存在不可逆后果。
如果事实缺失,先检查能否获取适用且获准访问的资料。检索到文档后核对来源、日期、范围及证据是否支持结论,引用的存在本身不足以验证。如果可以验证,就把验证步骤纳入流程;如果风险高或涉及价值取舍,就保留人工审批。这样做的目标不是拒绝使用人工智能,而是让模型在它擅长的“生成候选、压缩信息、发现模式”范围内提高效率,同时把事实确认与责任判断放在正确的位置。