
机器学习与深度学习 / 系统课时
提示词与上下文
提示词与上下文
同一个模型面对不同输入,输出质量可能差异很大。本课从提示词的组成入手,理解任务指令、上下文、示例和约束分别解决什么问题,并建立一套可以反复使用的改写方法。
学习目标
- 区分任务指令、上下文、示例和输出约束的作用
- 能把模糊需求改写成清晰、可执行的提示词
- 理解上下文长度、相关性和信息顺序对输出的影响
提示词真正控制什么
大语言模型会根据已经看到的内容预测后续内容。提示词为生成提供任务、材料与约束。模型可能遗漏或违背约束,关键格式和执行条件应由应用代码校验。
例如,只说“介绍机器学习”时,模型必须自己猜测读者水平、篇幅和重点;改成“面向没有编程经验的读者,用 200 字解释机器学习,并给一个生活中的例子”,可选择空间就明显缩小了。
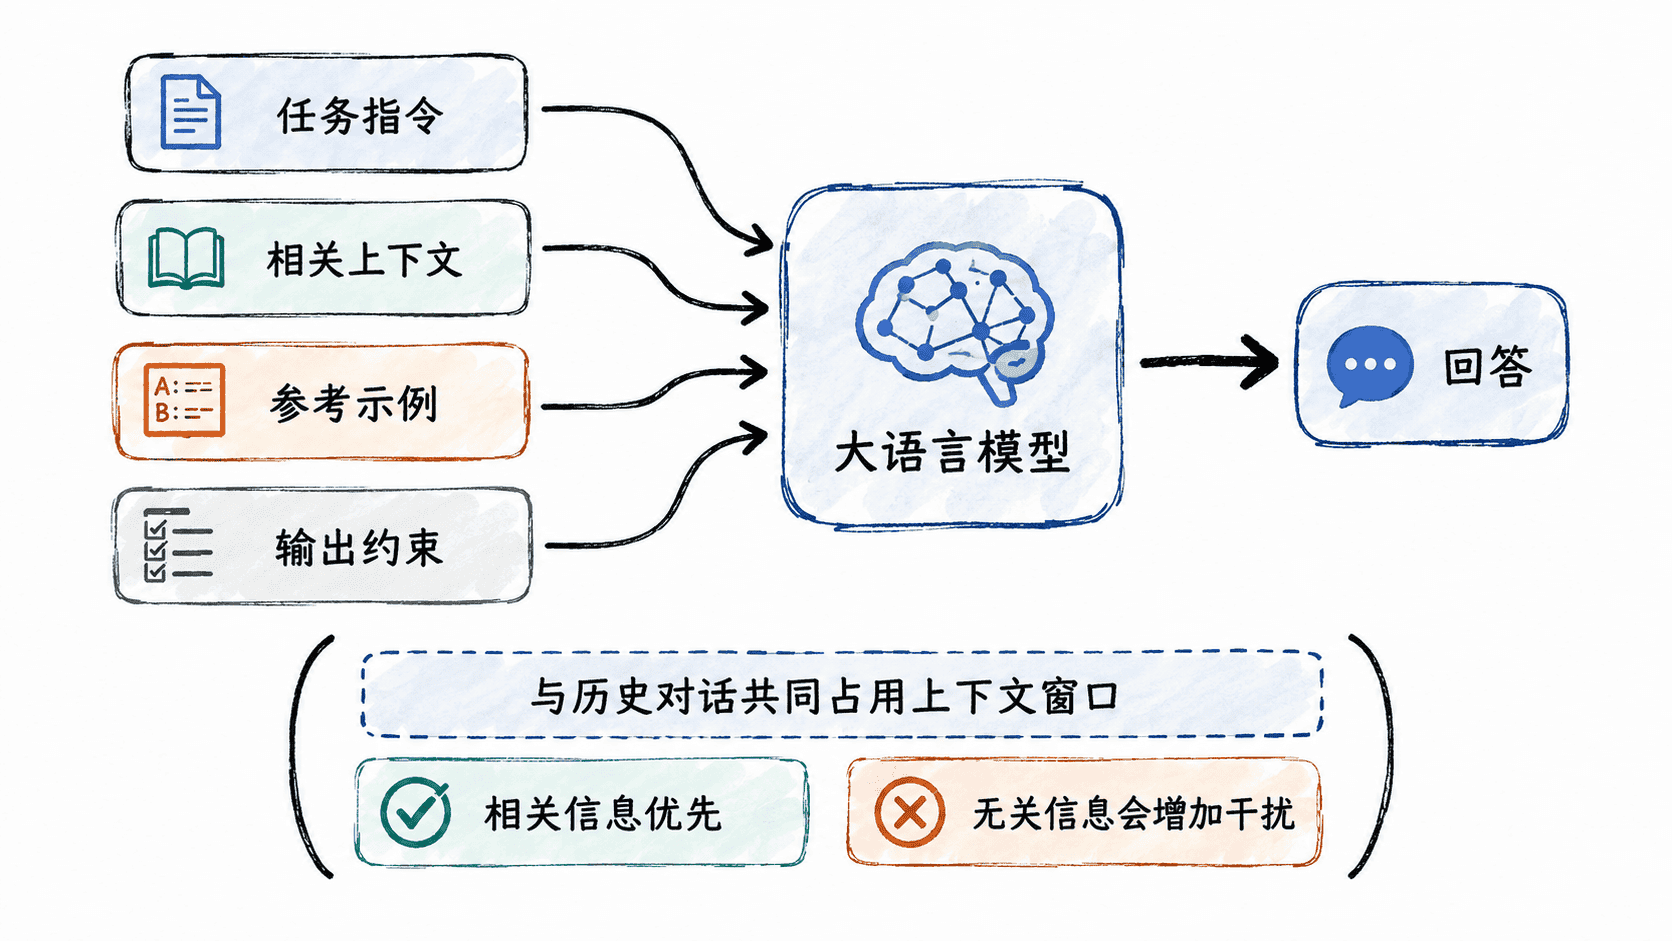
提示词的目标不是堆叠“专业一点”“认真思考”等形容词,而是减少真正影响结果的歧义。任务对象、成功标准和必要限制越具体,模型越容易沿着正确方向生成。
组成高质量输入
一个实用提示词通常包含四类信息,但并非每次都必须全部出现。
| 部分 | 解决的问题 | 示例 |
|---|---|---|
| 任务指令 | 要做什么 | 比较两种算法的差异 |
| 上下文 | 根据什么做 | 读者刚学过线性回归 |
| 约束 | 哪些边界不能越过 | 不使用微积分,控制在 300 字 |
| 输出形式 | 结果怎样组织 | 先给结论,再用表格比较 |
如果原始需求是“帮我解释这段内容”,可以改成更明确的表达:
面向第一次学习神经网络的读者,解释下面这段文字。保留“参数”和“梯度”两个术语,每个术语先用一句话定义,再给一个直观例子。总长度控制在 400 字以内。
这里没有复杂技巧,只是把读者、任务、保留内容和输出边界说清楚了。
用示例消除歧义
当一种要求难以仅靠语言定义时,示例往往比继续增加描述更有效。比如你希望模型把技术术语改写成“一句话定义 + 一个例子”,给出一条输入输出示范后,模型能够同时看到内容和格式模式。
这种做法通常称为少样本提示。示例应当代表真正希望得到的结果,而不是随便提供几个相近文本。错误或不一致的示例也会成为上下文的一部分,从而把输出带向错误方向。
上下文不是越多越好
上下文包括当前提示词、此前对话以及应用额外提供的资料。模型结合当前可见输入和参数中习得的模式生成。过往对话和资料只有进入本次可见输入后才能作为当前证据,缺少材料时模型仍可能凭模式猜测。上下文预算按词元计,应用要给模板、资料和输出留足空间。即使输入未超限,关键片段的位置也可能影响表现,应在目标模型上用同一事实的不同位置与干扰片段做对照。
整理上下文时,可以优先保留与当前问题直接相关的事实,并明确资料的角色。例如使用“以下内容是参考资料,只根据其中事实回答”比直接粘贴一大段文字更清楚。对于长资料,还可以先筛选相关片段,再交给模型处理。
上下文也不能自动保证信息正确。过期资料、互相冲突的说明或恶意文本都会影响生成结果,因此重要事实仍需核验,将检索文档等外部材料标成数据。权限由应用独立校验,只有任务所需的工具和数据可用。标记边界和输出检查都只能降低提示注入的风险。
给摘要任务加入可验证的输出约定
例如将任务写为“从提供的开放时间资料抽取最多两条原句。只返回含 quotes 数组的 JSON,每项提供 source 和 quote。资料无原句可支持时返回空数组。”实际应用独立持有可信来源表,以下用合成输出测试验证器。
import json

def check_quotes(raw, sources):
    try:
        result = json.loads(raw)
    except (TypeError, json.JSONDecodeError):
        return False
    if not isinstance(result, dict) or set(result) != {"quotes"}:
        return False
    quotes = result["quotes"]
    if not isinstance(quotes, list) or len(quotes) > 2:
        return False
    for item in quotes:
        if not isinstance(item, dict) or set(item) != {"source", "quote"}:
            return False
        source, quote = item["source"], item["quote"]
        if not isinstance(source, str) or not isinstance(quote, str):
            return False
        if source not in sources or not quote.strip() or quote not in sources[source]:
            return False
    return True

sources = {"A": "周一至周五开放。", "B": "周末开放时间尚未公布。"}
correct = '{"quotes":[{"source":"A","quote":"周一至周五开放。"}]}'
invented = '{"quotes":[{"source":"A","quote":"周六也开放。"}]}'
print(check_quotes(correct, sources))
print(check_quotes(invented, sources))
预期输出为 True、False。验证器能检查结构和引句是否逐字出现在该来源,但仍需核查来源是否过期、上下文是否被断章取义,以及空结果是否漏掉证据。把这几类失败分别记录,在同一组样例上比较两版提示词。
逐项迭代提示词
改进提示词最有效的方法,是观察输出究竟哪里不符合要求,然后只补充对应信息。
- 先用一句话明确最终任务和对象。
- 补充完成任务必需的事实上下文。
- 明确长度、格式、语气或禁止事项等关键约束。
- 如果要求难以描述,增加一个代表性的示例。
- 检查失败点,只修改一个主要因素后重新比较结果。
如果回答过于宽泛,应增加范围和成功标准;如果遗漏关键事实,应补上下文;如果结构混乱,应明确输出格式。记录提示词版本、模型版本、抽样参数和测试集。在不变的样例上分别比较格式通过率和事实证据命中率。下一章会把这些做法用于生成与工具任务。