
机器学习与深度学习 / 系统课时
模型评估与迭代
模型评估与迭代
训练结束后,先用验证数据决定是否保留模型和决策阈值。评估要记录任务、数据版本、预处理、正类、阈值和计算口径。这里用二分类验证样本说明准确率、精确率和召回率如何对应误报与漏报。
学习目标
- 根据任务成本选择指标,并和同数据上的简单基线比较。
- 用同一组验证预测比较阈值,明确指标的分母及未定义情况。
- 根据有分母的分组误差安排下一轮实验,再冻结方案进行独立验收。
指标对应错误代价
给定明确的正类,预测和真实都为正记为 TP,误报为 FP,漏报为 FN,正确拒绝为 TN。准确率的分母是所有样本,精确率的分母是预测为正的样本,召回率的分母是真实为正的样本。没有预测正例时精确率未定义,没有真实正例时召回率未定义。工具有时按指定策略用 0 或其他值替代,应记录口径和样本数。 scikit-learn 分类指标与零分母说明
对于回归,还可用 MAE 表示原量纲下的平均绝对偏差,或用 RMSE 增加大误差的影响。指标应和任务中真正关心的错误对应,最终应同时检查适用数据与成本。 scikit-learn 回归指标
在验证集比较两种阈值
下面的合成分数已由假定的模型输出。达到阈值即预测为正。示例只比较验证集上的两个候选,实际选择的阈值需与最终模型版本一起冻结。
def binary_report(labels, predictions):
    if not labels or len(labels) != len(predictions):
        raise ValueError("expected non-empty aligned inputs")
    if any(value not in (0, 1) for value in [*labels, *predictions]):
        raise ValueError("expected binary labels")
    pairs = list(zip(labels, predictions))
    tp = pairs.count((1, 1))
    fp = pairs.count((0, 1))
    fn = pairs.count((1, 0))
    tn = pairs.count((0, 0))
    return {
        "accuracy": (tp + tn) / len(pairs),
        "precision": tp / (tp + fp) if tp + fp else None,
        "recall": tp / (tp + fn) if tp + fn else None,
        "counts": (tp, fp, fn, tn),
    }


y_val = [1, 1, 1, 1, 0, 0, 0, 0, 0, 0]
scores = [0.90, 0.55, 0.80, 0.40, 0.60, 0.30, 0.20, 0.10, 0.15, 0.05]

for cutoff in (0.70, 0.40):
    pred = [int(score >= cutoff) for score in scores]
    report = binary_report(y_val, pred)
    print(f"cutoff={cutoff:.2f}: {report}")
print("always negative:", binary_report(y_val, [0] * len(y_val)))cutoff=0.70: {'accuracy': 0.8, 'precision': 1.0, 'recall': 0.5, 'counts': (2, 0, 2, 6)}
cutoff=0.40: {'accuracy': 0.9, 'precision': 0.8, 'recall': 1.0, 'counts': (4, 1, 0, 5)}
always negative: {'accuracy': 0.6, 'precision': None, 'recall': 0.0, 'counts': (0, 0, 4, 6)}较低阈值多找到两个正例,也增加一次误报。若事先要求召回至少 0.85 且精确率至少 0.80,0.40 在这十条验证记录上通过。只有四个正例,一条正例的预测变化就会改变 0.25 的召回率。正式验收需要足够样本以及对部署对象有代表性的独立数据。在训练样本上挑阈值会混用拟合与评估。 scikit-learn 阈值调节与验证边界
用误差分析决定下一步
按场景、时间或数据来源拆分错误。记录每组总数、正例数和误报漏报计数,避免把漏报数量最多的组误认为漏报率最高的组。举例来说,低光组漏报 3/5,正常光组漏报 4/80。后一组错误更多,前一组漏报率更高且分母很小。检查标注、分布与图像预处理后,再验证补样本等具体假设。样本不足的组记录不确定性或继续收集样本。
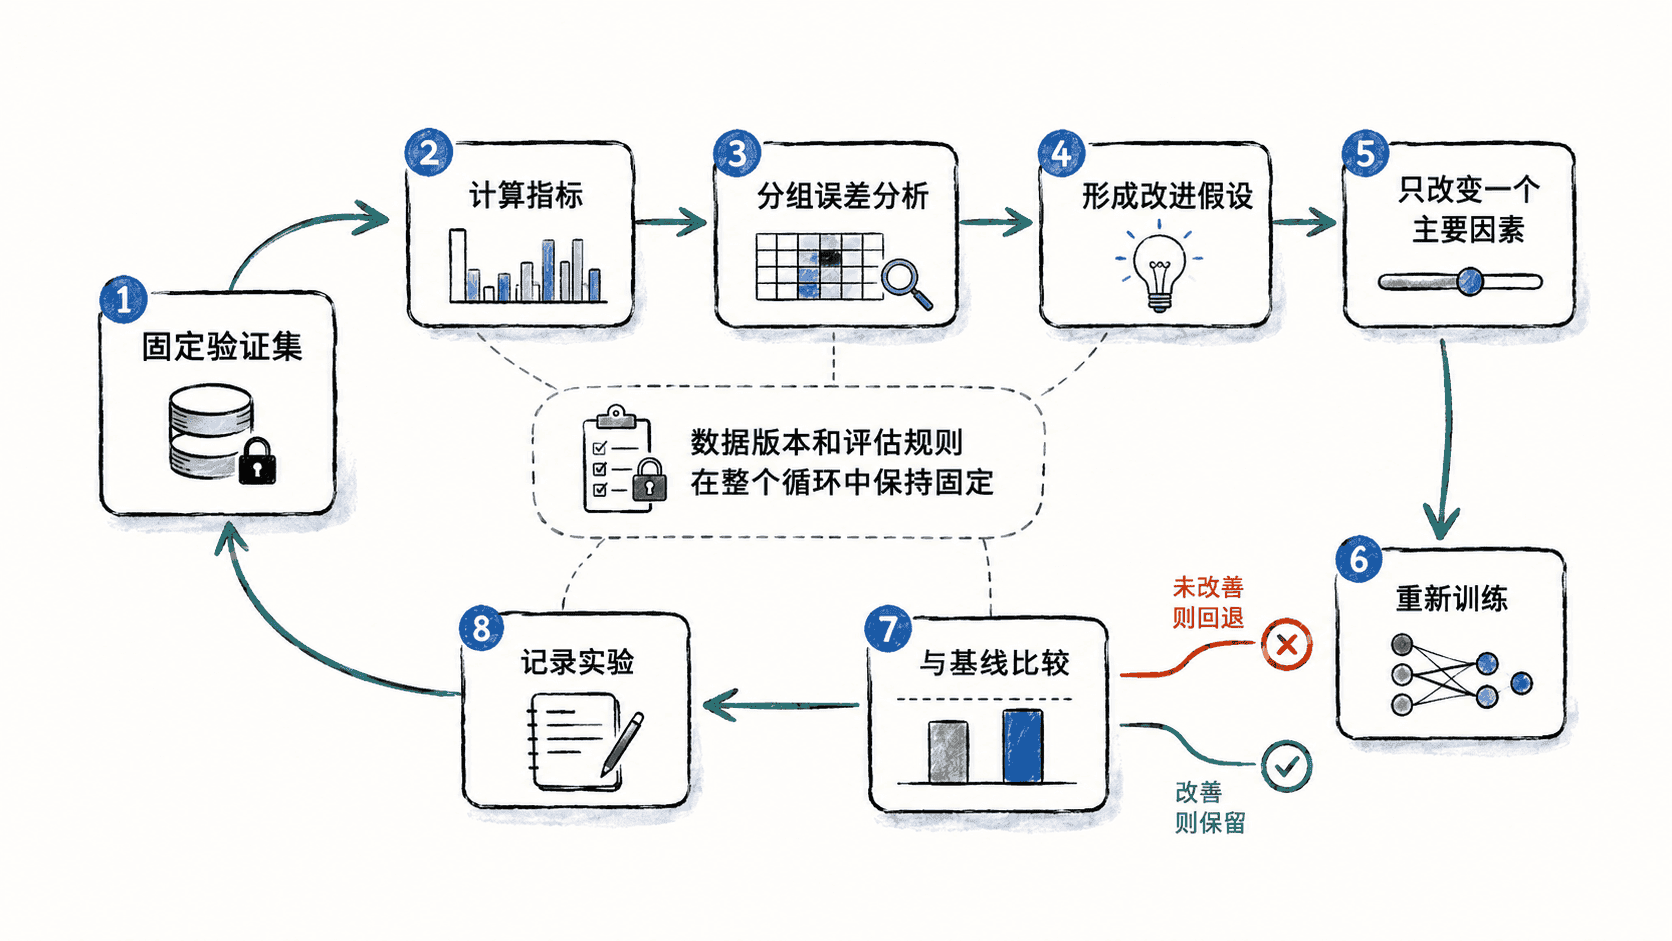
让迭代有可验收的停止条件
每轮记录改动、数据和代码版本、模型与阈值、验证指标及样本数。阈值改动和数据改动分成可比较的实验。用同一验证样本对比时,保留逐样本结果;重要决策还应根据样本结构估计差异的不确定性。必要时把误报、漏报、覆盖率、延迟和成本约束写进验收门槛。选择完成后对固定方案运行独立测试。 scikit-learn 评估指标 scikit-learn 验证与测试职责
本课练习
用阈值 0.95 重算指标,说明精确率为什么没有定义。再将某个小组设为无正例,检查组内召回的分母。用计数、样本量和预先设定的门槛写出是否继续迭代的结论。