
机器学习与深度学习 / 系统课时
线性回归
线性回归
线性回归用输入特征估计数值目标。本节用学习时长和考试成绩解释模型参数、普通最小二乘拟合和留出集误差。
斜率、截距和残差
只有一个特征时,预测值为 。斜率 表示 每增加一个单位时预测值的变化量,截距 是模型在 时给出的预测值。若训练数据没覆盖 0,截距仍可参与计算,但未必有独立的业务解释。每多学习 1 小时预测分数高 8 分,只表明拟合出的关联,不能据此推断增加学习时间一定会提高成绩。
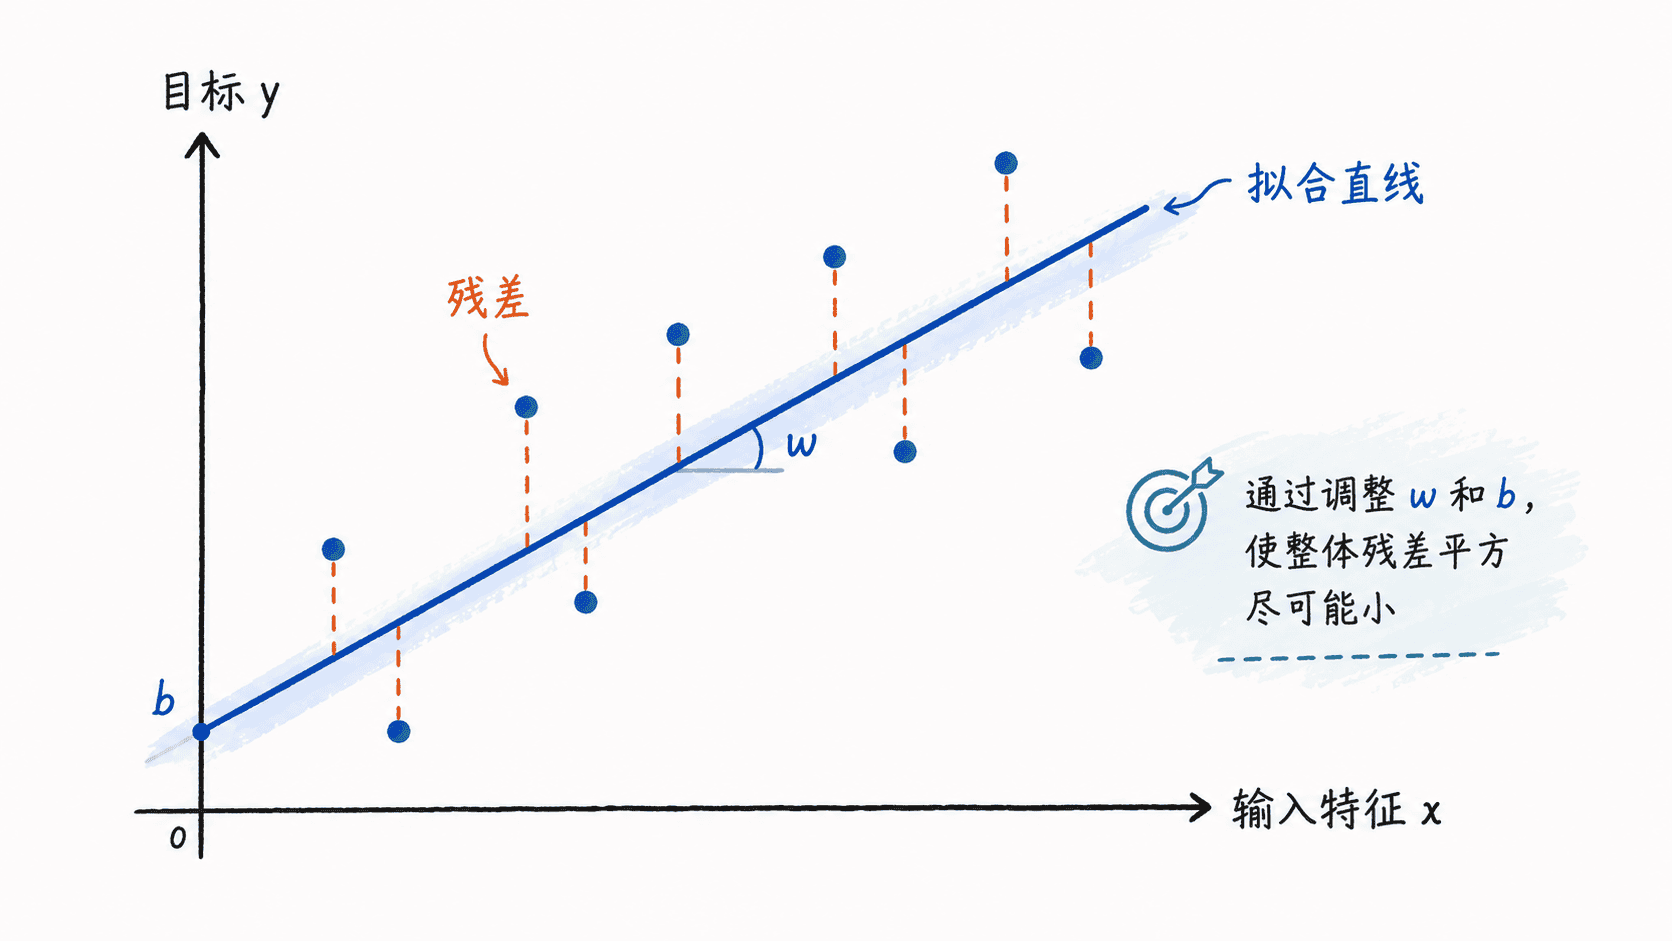
定义残差 。正残差表示预测偏低,负残差表示预测偏高。平方使正负残差不会抵消,也放大了大误差的影响。均方误差(MSE)等于:
目标用分数衡量时,MSE 的单位是分数的平方,开平方后的 RMSE 与原目标同单位。比较模型时,使用同一批评估记录和同一单位。
训练一条直线,再做留出评估
普通最小二乘选择使训练残差平方和最小的系数。单特征下,斜率是离均差乘积之和除以输入离均差平方和,即 。随后令 。训练记录与留出记录都使用合成数据。
python
from math import fsum
from statistics import mean

def fit_line(xs, ys):
    if len(xs) != len(ys) or len(xs) < 2:
        raise ValueError("需要两组等长数据,至少各有两个元素")
    x_mean, y_mean = mean(xs), mean(ys)
    centered = [x - x_mean for x in xs]
    sum_squares = fsum(dx * dx for dx in centered)
    if sum_squares == 0:
        raise ValueError("横坐标至少需要两个不同的值")
    slope = fsum(dx * (y - y_mean) for dx, y in zip(centered, ys)) / sum_squares
    return slope, y_mean - slope * x_mean

w, b = fit_line([1, 2, 3], [48, 56, 64])
held_out = [(4, 73), (5, 78)]
residuals = [y - (w * x + b) for x, y in held_out]
print(f"w={w:g}, b={b:g}")
print("残差:", residuals)
print("MSE:", mean(error ** 2 for error in residuals))
模型预测第 4 小时和第 5 小时的成绩为 72 和 80。留出记录的残差为 1 和 -2,MSE 为 2.5。训练样本恰好落在直线上,留出样本仍有误差。留出时长超出了训练区间,也演示了外推风险。
使用条件和下一步
多个特征时,模型对待估系数仍是线性的,特征本身可以包含 等变换。实际计算可交给库的最小二乘求解器处理秩亏和数值稳定性。特征接近共线时,多个系数可能互相补偿,单独解释某一项需格外谨慎。检查验证残差是否有系统趋势、极端值是否主导拟合、外推结果是否符合业务含义。若目标是垃圾邮件等类别,下一课将把线性分数转换成正类概率。
按自己的节奏,确认真正理解。