
机器学习与深度学习 / 系统课时
部署与推理
部署与推理
部署的目标是让训练好的模型以稳定、可监控的方式接收输入并返回预测。本课将比较批量推理与实时推理,使用 Python 标准库实现一个最小 HTTP 服务,并说明版本、资源和异常处理要求。
学习目标
- 区分批量推理与实时推理的适用场景
- 能运行一个最小模型推理接口
- 理解延迟、吞吐量、资源和版本管理的关系
从模型文件到可用服务
部署系统通常包含请求入口、输入校验、预处理、模型推理、后处理和监控记录。模型只是其中一部分,训练时使用的词表、归一化规则和标签映射也必须随版本一起发布。
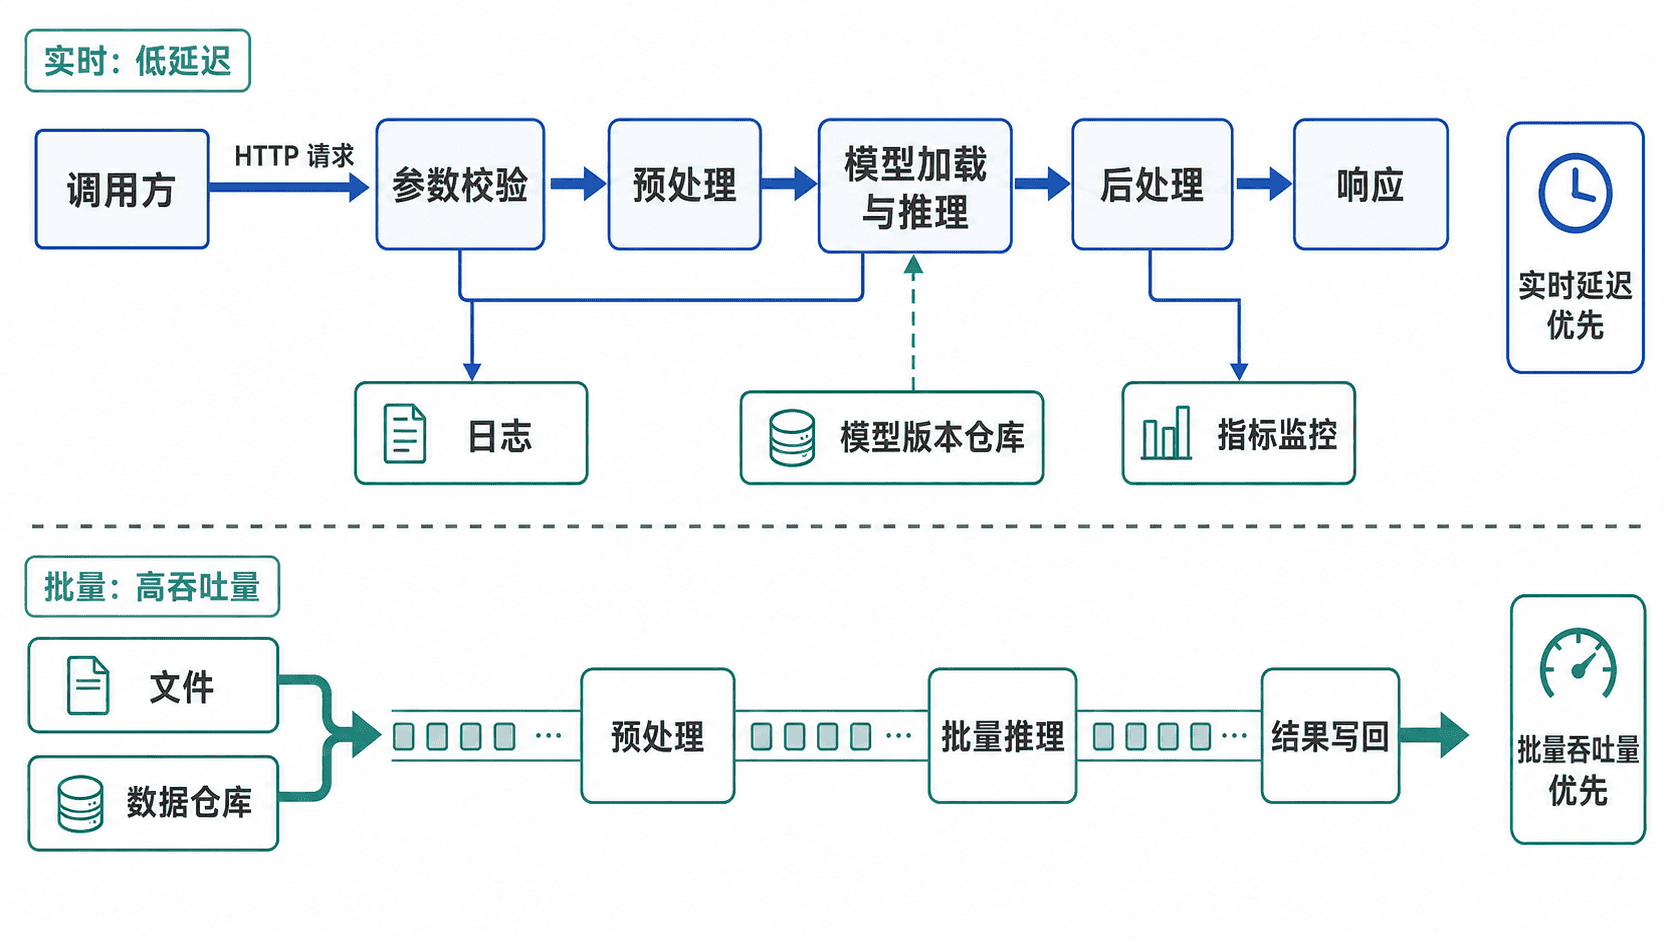
实时推理关注单次请求延迟和并发能力,适合交互式推荐、风控和在线分类。批量推理关注单位时间处理量和资源利用率,适合离线报表、历史数据补算和定时任务。
最小 HTTP 推理服务
下面的服务仅绑定回环地址,用上一阶段的规则思路演示推理接口。无命中或两类同时命中时转人工。实际业务仍应在入口先检查工单范围和敏感标记。Python 的 http.server 适合本地教学,生产服务需要独立的鉴权、资源限额、超时、访问控制和日志策略。
import json
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

MAX_BODY = 4096
RULE_VERSION = "ticket-rules-v1"

def predict(text):
    hits = [label for label, words in {
        "账号": ("登录", "验证码", "密码"),
        "退款": ("退款", "扣款"),
    }.items() if any(word in text for word in words)]
    return hits[0] if len(hits) == 1 else "转人工"

class PredictHandler(BaseHTTPRequestHandler):
    def setup(self):
        self.request.settimeout(2)
        super().setup()

    def send_json(self, status, value):
        body = json.dumps(value, ensure_ascii=False).encode("utf-8")
        self.send_response(status)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.send_header("Cache-Control", "no-store")
        self.end_headers()
        self.wfile.write(body)

    def do_POST(self):
        if self.path != "/predict":
            return self.send_json(404, {"error": "not_found"})
        if self.headers.get_content_type() != "application/json":
            return self.send_json(415, {"error": "expected_json"})
        lengths = self.headers.get_all("Content-Length") or []
        if self.headers.get("Transfer-Encoding") or len(lengths) != 1:
            return self.send_json(400, {"error": "invalid_body_length"})
        raw_length = lengths[0]
        if not raw_length.isascii() or not raw_length.isdigit() or raw_length == "0":
            return self.send_json(400, {"error": "invalid_body_length"})
        if len(raw_length) > 4 or int(raw_length) > MAX_BODY:
            return self.send_json(413, {"error": "body_too_large"})
        length = int(raw_length)
        if length == 0:
            return self.send_json(400, {"error": "invalid_body_length"})
        try:
            body = self.rfile.read(length)
        except TimeoutError:
            return self.send_json(408, {"error": "body_timeout"})
        if len(body) != length:
            return self.send_json(400, {"error": "incomplete_body"})
        try:
            data = json.loads(body.decode("utf-8"))
        except (UnicodeDecodeError, json.JSONDecodeError):
            return self.send_json(400, {"error": "invalid_json"})
        if (not isinstance(data, dict) or set(data) != {"text"} or
                not isinstance(data["text"], str) or not data["text"].strip()):
            return self.send_json(400, {"error": "invalid_text"})
        return self.send_json(200, {"label": predict(data["text"]), "version": RULE_VERSION})

    def log_message(self, format, *args):
        pass  # 本地演示不记录原始请求

if __name__ == "__main__":
    with ThreadingHTTPServer(("127.0.0.1", 8000), PredictHandler) as server:
        print("Serving on http://127.0.0.1:8000", flush=True)
        server.serve_forever()
保存为 server.py 后运行 python server.py,再从终端发请求。示例接收单个 UTF-8 JSON 对象,正文上限 4096 字节。
curl -sS -X POST http://127.0.0.1:8000/predict \
  -H 'Content-Type: application/json' \
  -d '{"text":"退款还没有到账"}'
预期 HTTP 200,响应包含 label 为“退款”和 version 为 ticket-rules-v1。发送空对象或损坏的 JSON 会得到 400,内容类型不符为 415,声明长度超限为 413。试验结束后用 Ctrl+C 停止本地服务。真实模型的预处理、标签映射和决策阈值应与模型版本一并管理。
性能与资源取舍
延迟是单次请求完成时间,吞吐量是单位时间处理的请求或样本数量。适度增大批量可能提高吞吐量,也会增加等待时间和内存占用。用实际并发和输入长度分布压测批量上限、排队超时、P95 与 P99。
模型加载通常消耗较多内存和时间,应在进程启动时完成,而不是每个请求重新加载。使用 GPU 时还要观察显存、利用率和批处理队列;使用 CPU 时应关注线程数、并发和模型大小。
压缩、量化或更小模型可以降低资源消耗,但必须重新评估精度。部署优化不能只看速度,还要确认输出质量没有跌破验收标准。
版本、监控与回退
每次响应或日志应能关联模型版本、预处理版本和服务版本。新模型先进行小流量验证,观察错误率、延迟、资源和业务指标,再逐步扩大范围。
监控至少包括请求量、成功率、错误码、延迟分位数、资源使用和输入分布变化。只监控服务是否存活,无法发现模型已经因为数据漂移而失效。
上线前还应准备回退方案,例如切回旧模型、降级到基线规则或转人工。用同一业务口径核对小流量版本和旧版本,回退时一起恢复模型、预处理和阈值。下一课拆分线上延迟、异常和质量信号。